pandas DataFrame for循环迭代指南:核心方法与避坑详解
在Python数据分析中,频繁需要遍历pandas.DataFrame提取或处理数据。本文系统讲解for循环迭代DataFrame的正确姿势,涵盖逐行、逐列、指定列取值方法,剖析iterrows与itertuples的返回特性及性能差异,并明确指出迭代修改变量不生效的原理,最后给出基于向量化计算的高效替代方案。
2026-10-12
7
在Python数据分析中,频繁需要遍历pandas.DataFrame提取或处理数据。本文系统讲解for循环迭代DataFrame的正确姿势,涵盖逐行、逐列、指定列取值方法,剖析iterrows与itertuples的返回特性及性能差异,并明确指出迭代修改变量不生效的原理,最后给出基于向量化计算的高效替代方案。
本文详细解析Python内置的os与sys标准库模块的核心用法。通过具体代码演示如何获取与切换工作目录、解析拼接路径、校验文件属性及执行目录增删操作;同时介绍如何利用sys模块读取命令行参数、控制程序退出状态、调用标准I/O流,以及获取Python解释器版本、平台类型与模块搜索路径等运行时关键信息。
本文详解NumPy库中unique()函数的核心参数与实操流程,涵盖一维与多维数组去重、首次出现索引提取、输入矩阵重建及元素频次统计方法。提供可直接运行的代码示例与避坑指南,帮助开发者高效完成数据清洗、重复值过滤与分布特征查询。
本文详解Python中使用readline()和readlines()函数按行读取文件的核心语法与参数控制。通过文本与二进制模式的对比代码,演示如何获取单行数据、处理末尾换行符及限制读取长度,并分析两者在返回值类型与内存占用上的差异,帮助开发者高效完成文件内容解析。
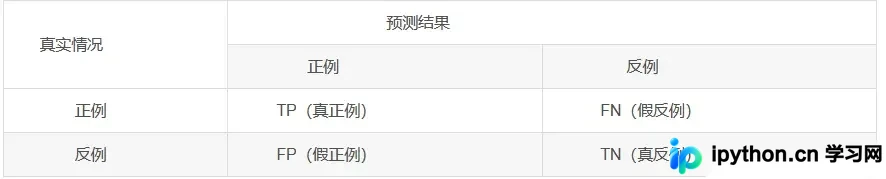
在机器学习分类任务中,混淆矩阵是量化模型性能的核心工具。本文基于 Python 和 sklearn 库,详细演示如何从原始预测数据中提取真实值与预测值,准确计算 TP、FP、TN、FN 等基础指标,并分步实现 Seaborn 热力图与官方可视化组件的代码编写。掌握该流程可快速定位模型误判分布,指导后续的特征工程与超参数调优。
本文详解 NumPy 内置的 numpy.concatenate 函数,讲解如何沿指定轴将多个数组高效拼接为新数组。核心要点包括数组形状匹配条件、axis 参数的三种取值逻辑(默认行合并、按列合并及展平拼接),以及修复 TypeError 的正确传参格式,帮助开发者快速掌握多维数据合并技巧。
本文介绍如何使用Python的Pandas库读取CSV文件,通过sort_values函数对指定数值列进行排序,并结合Matplotlib生成排序前后的对比图表,帮助快速完成数据清洗与基础可视化。
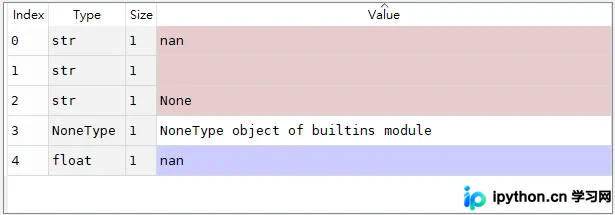
在NumPy数据处理流程中,NaN缺失值的判定存在明确的语法陷阱。直接使用等号比较或布尔条件会引发逻辑误判。本文系统梳理基于np.isnan()、身份运算符的标准验证方案,并结合Pandas内置函数演示如何高效过滤混合数据源,同时厘清None与空字符串的类型边界。
针对分类模型排序质量的评估需求,本文详细解析ROC曲线与AUC指标的计算原理,提供基于Python与sklearn库的完整实现方案。通过导入鸢尾花数据集、执行标签二值化与One-vs-Rest策略训练线性SVM模型,代码可直接输出ROC曲线图及对应的AUC评分,帮助快速验证模型在不同阈值下的泛化性能。
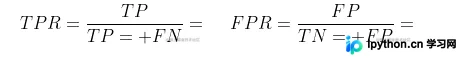
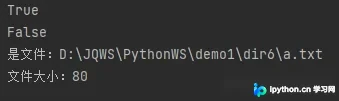
Python处理文件时,准确理解相对路径与绝对路径的机制可避免读写失败。本文详解如何通过 os 模块获取当前工作目录、切换运行环境、判断路径存在性并创建新文件夹,结合具体字符串写法说明不同前缀的实际指向,附带完整代码示例与操作注意事项。
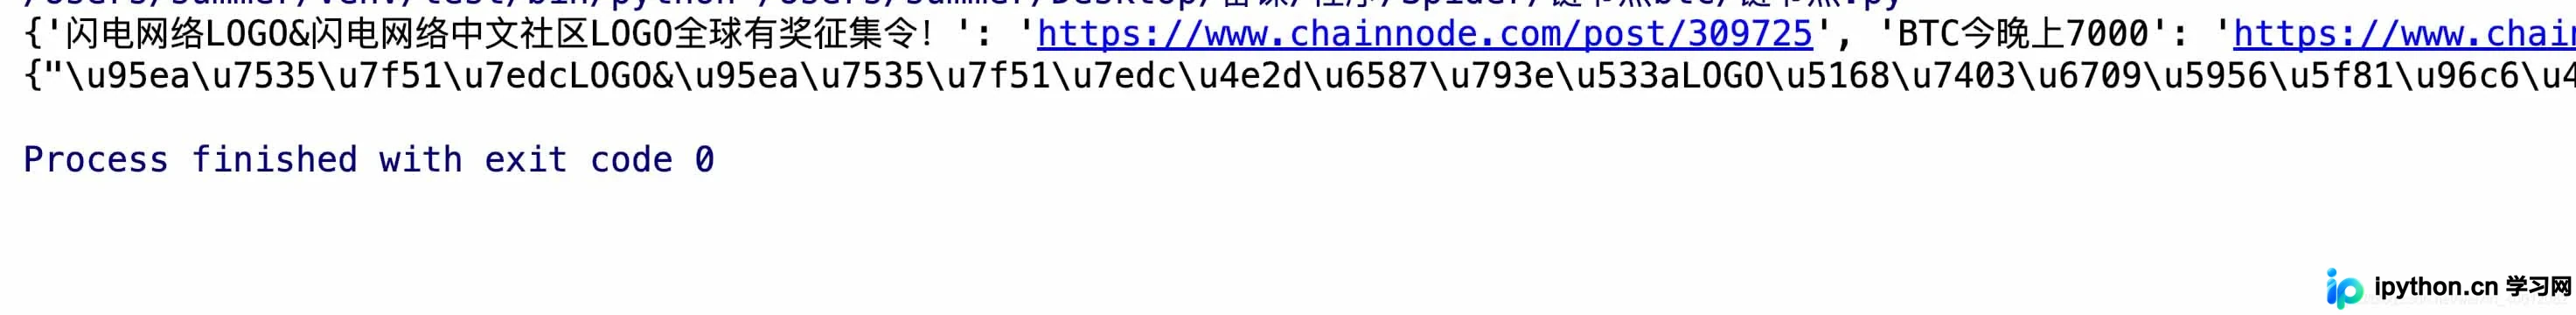
在使用 Python 将数据结构序列化为 JSON 字符串时,json.dumps() 默认遵循安全转义规则,会将中文转换为 \uXXXX 形式的 ASCII 编码,导致控制台输出晦涩且文件读取乱码。通过在调用时添加 ensure_ascii=False 参数,并配合文件写入时的 encoding='utf-8' 设置,即可直接获取并保持可读的中文字符串。
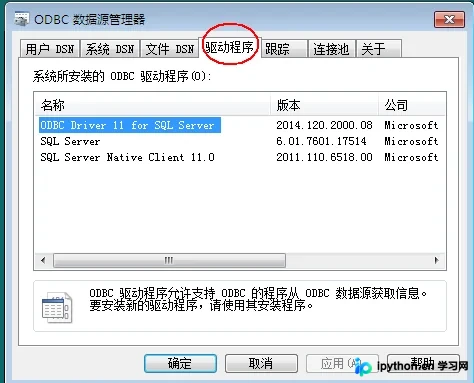
本文详细介绍如何利用 Python 的 pyodbc 模块结合 ODBC 驱动程序连接 SQL Server 数据库。内容涵盖系统驱动核查、环境安装、连接参数配置、核心方法封装以及增删改查实操步骤,提供稳定且不易出现中文乱码的数据库交互方案。