


Python 实现 DBSCAN 密度聚类算法详解与代码示例
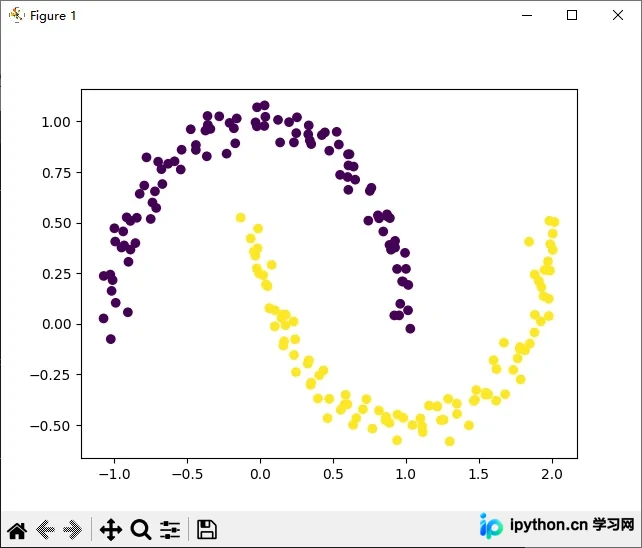
本文详解 DBSCAN 密度聚类算法的核心原理,对比其与 K-Means 的差异,并逐步演示如何在 Python 中通过 scikit-learn 快速调用及手动实现基础逻辑。结合月牙形数据集的可视化案例,帮助你掌握参数配置、结果判读及常见问题的处理方法。
2026-10-12
7
本文详解 DBSCAN 密度聚类算法的核心原理,对比其与 K-Means 的差异,并逐步演示如何在 Python 中通过 scikit-learn 快速调用及手动实现基础逻辑。结合月牙形数据集的可视化案例,帮助你掌握参数配置、结果判读及常见问题的处理方法。
在 Python 3.7 环境中使用 Sanic 时,安装 sanic-ext 后 /docs 路由无法访问且服务静默不报错。本文通过分析启动日志中的 packages 字段定位问题根源,发现是第三方元数据管理包 importlib-metadata 版本与扩展插件不匹配所致,并提供快速验证与升级建议。
本文介绍如何使用Flask轻量级Python框架快速搭建Web服务。从创建虚拟环境与安装依赖开始,逐步演示启动第一个应用、配置动态路由与参数类型转换、处理静态资源及使用Jinja2模板渲染页面的完整流程,帮助开发者用最少代码实现前后端接口或模型预测服务。
本文详细解析Python中scipy.stats.norm函数的用法。介绍通过直接调用与实例化两种方式设置均值与标准差的方法,对比概率密度(pdf)与随机抽样(rvs)的差异,并列出cdf、ppf等核心统计方法,帮助快速掌握正态分布建模与数据可视化。
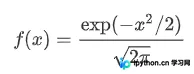
本文通过Python基础实战案例,详细演示了如何安全读取本地文本文件,并使用字典(dict)进行高效的词频统计。借助内置的sorted()函数与列表切片技术,将复杂的键值对数据进行排序,最终精准提取出文件内出现次数最多的前10个单词。非常适合初学者熟悉Python的数据结构与文件流处理。
在Python开发中,经常需要调用系统命令或第三方工具完成自动化任务。本文详细说明如何利用os.system快速执行简单命令,并重点演示subprocess模块的标准输出捕获、字符串解析及异步非阻塞运行机制,附带Windows磁盘空间检测实例,帮助开发者掌握跨进程交互的核心技巧。
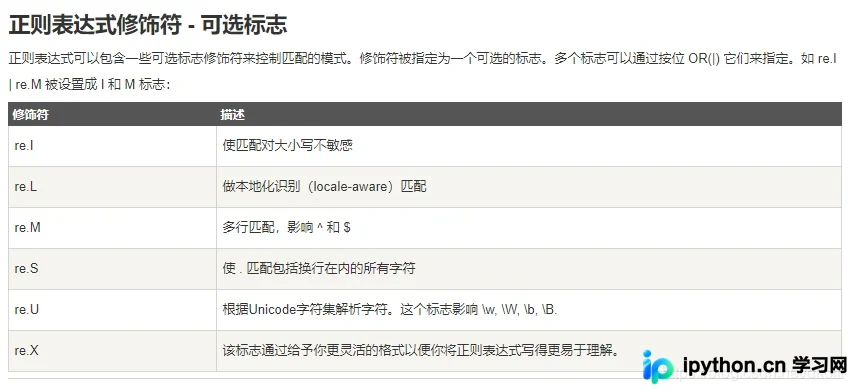
在Python文本处理中,手动逐个替换空格、制表符和换行符效率较低且易遗漏。本文对比了内置方法与正则表达式的实现差异,重点演示如何使用 re.sub 结合 \s 模式一次性清除字符串内所有类型的空白字符,并附带爬虫数据清洗的实际应用步骤与避坑指南。
Python input() 是用于读取控制台键盘输入的内置函数。该函数始终以字符串形式返回内容,直接进行数学运算会导致拼接而非求和。本文将详细讲解 input() 的语法结构、默认行为特征,演示如何配合 int() 与 float() 完成类型转换,并梳理 Python 历史版本中输入函数的演变逻辑。
本文详细拆解使用Pandas批量合并多张Excel表格的标准流程,涵盖有序文件遍历与无序目录扫描两种代码实现。同步给出身份证号等超长数字截断乱码的精准修复方案,助力高效完成底层数据汇总。
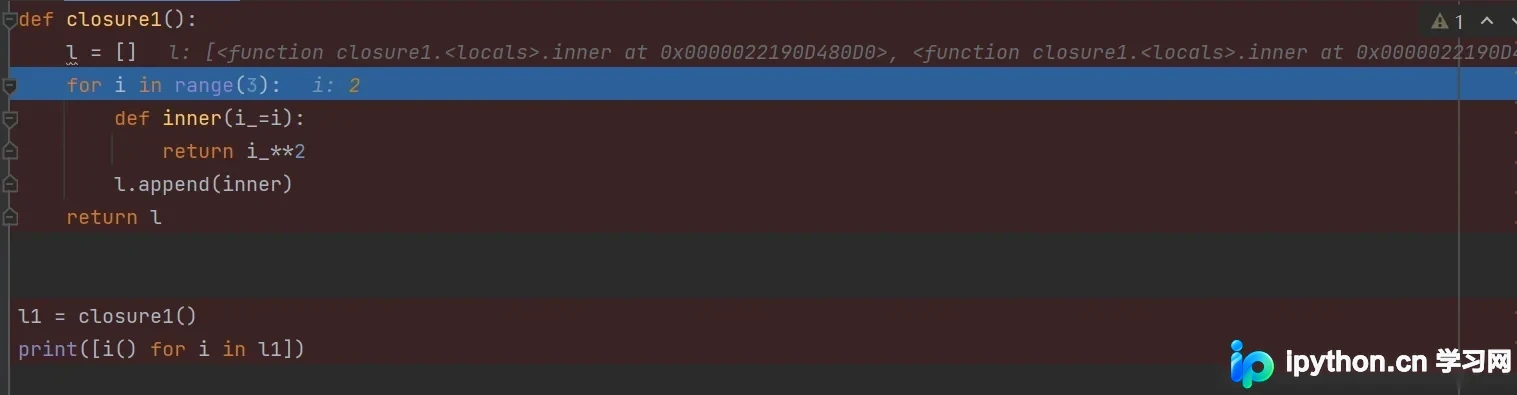
Python 闭包指内部函数引用外部作用域变量并保留其状态的技术。本文通过基础示例演示闭包的数据封装能力,并针对循环中常见的“闭包陷阱”(后期绑定导致变量共享)进行对比分析。通过默认参数捕获当前值的方法可彻底解决该问题,确保函数返回值符合预期。
面对Python代码运行缓慢或内存占用过高时,如何精准定位瓶颈?本文系统介绍time模块、%%time魔法命令、line_profiler与memory_profiler四种工具,分别提供基础耗时统计、Jupyter环境快速测算、逐行耗时分析及逐行内存监测的完整操作指南与参数配置,帮助开发者快速优化程序性能。
在Python桌面程序开发中,动态调整下拉列表的显示内容是提升交互体验的关键。本文将详细介绍如何使用Tkinter的ttk模块创建下拉列表控件Combobox,并提供完整的代码示例,演示如何初始化选项、运行时动态更换数据、重置默认值,以及如何准确获取用户选中的内容。