Python爬虫筛选指定内容的实现方案
本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
2026-10-15
39
本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
PyScript 是 Anaconda 推出的开源项目,允许在 HTML 中嵌入 Python 代码并在浏览器端直接运行。基于 Pyodide 技术,它支持引入 numpy、pandas 等科学计算库,实现 Python 与 JavaScript 的双向通信。尽管目前加载速度较慢,但它为 Python 开发者提供了构建全栈应用的新可能,无需编写 JavaScript 即可实现前端交互。
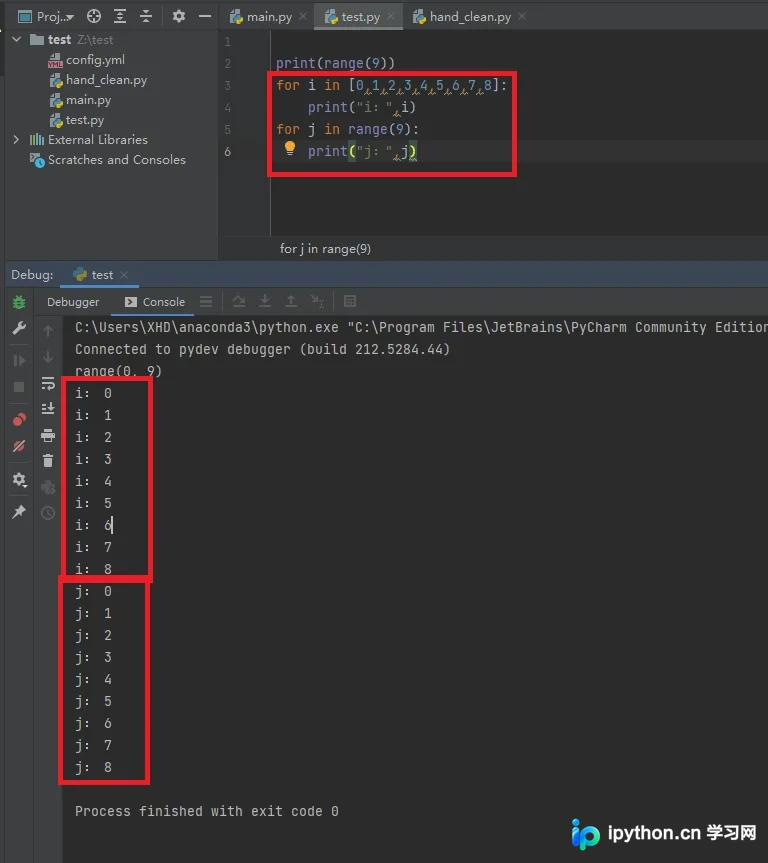
本文详细解析Python中range与len函数的核心区别。介绍range的三种参数形式及len对字符串和列表的长度计算,重点剖析range(len())的使用场景与常见TypeError错误,并提供修正方案,帮助开发者写出更简洁高效的Python代码。
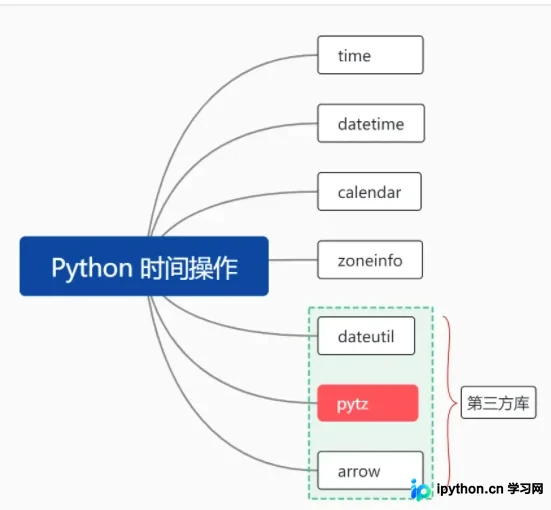
本文详细介绍Python中pytz模块的安装与核心用法。涵盖时区数据库原理、本地化时间创建(localize)、时区转换(astimezone)及夏令时处理(normalize)。通过城市查询GMT偏移量及跨时区时间计算两个实战案例,演示如何快速获取指定城市的标准时间并进行日期转换,帮助开发者高效处理复杂时区问题。
本文介绍如何利用Python的pydub库,仅需3行代码即可快速剪辑音乐文件。内容涵盖基础片段截取、音量动态调整(淡入淡出)、片段重复以及音乐反转等高级操作。通过具体代码示例,展示如何高效处理音频时长、音量分贝及文件导出,帮助开发者快速掌握Python音频处理的核心技能。
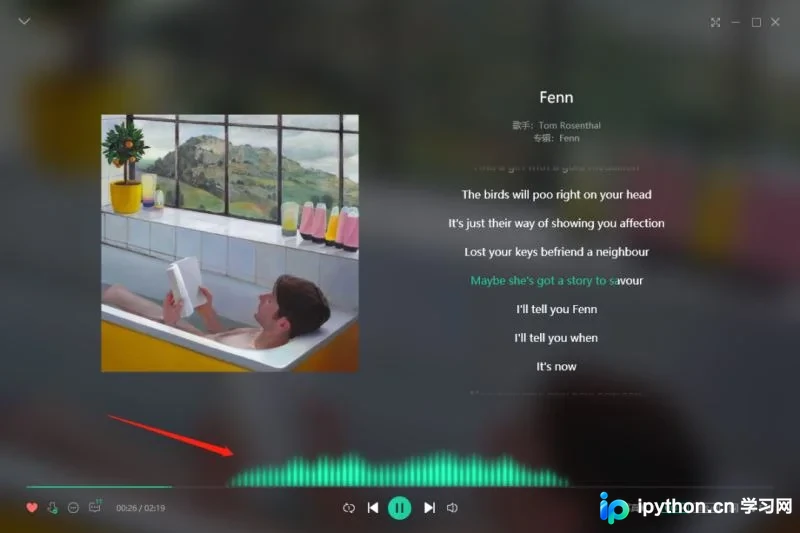
本文详解如何使用Python的librosa和pydub库提取音乐频谱并进行可视化。通过10行代码展示完整频谱,并利用pydub进行时间切片,实现特定时间段(如0-1秒)的频谱展示。文章进一步探讨了去除负值、局部放大及动态渲染等进阶技巧,为开发类似QQ音乐的高颜值频谱特效提供基础思路。
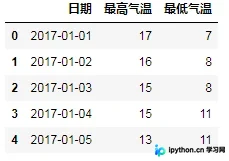
本文详解 Python Pandas 中时间序列数据的处理流程。涵盖 time 模块基础操作、DatetimeIndex 的创建与索引技巧,以及如何利用 pd.to_datetime 清洗日期数据。通过杭州天气数据集实例,演示如何按月份聚合统计并绘制温度变化趋势图,帮助开发者掌握时序数据分析的核心技能。
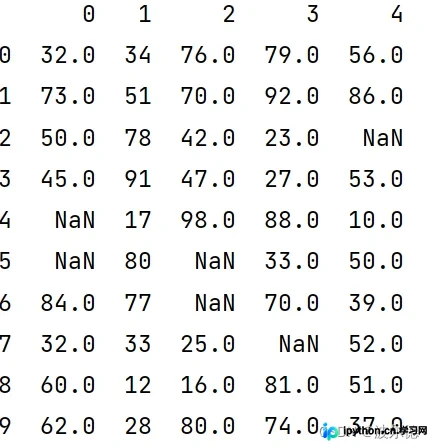
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵,isnull().any()如何识别含缺失值的列,以及isnull().sum()如何统计每列缺失值数量。结合代码示例与结果分析,帮助开发者快速掌握缺失值检测技巧。
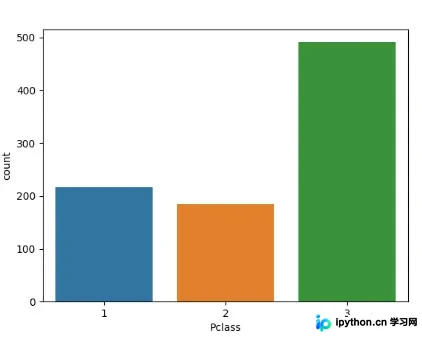
本文详细介绍Python中Seaborn库的countplot函数,用于绘制类别特征的频数统计条形图。文章解析了x、y、hue、data、order、palette等核心参数的用法,并通过Titanic数据集演示了如何绘制基础条形图、分组条形图、自定义排序与配色,以及如何在子图中组合展示。
本文详细介绍Python中列表去重的5种常见方法,包括for循环、列表推导式、set()函数、字典键值法以及删除重复数据法。重点分析各方法对原列表顺序的影响及保持顺序的解决方案,并附带NumPy二维数组去重示例,帮助开发者根据实际需求选择最优方案。
本文详细介绍Python中去除字符串空格、Tab及换行符的四种常用方法。通过strip()、lstrip()、rstrip()分别处理首尾及两端空白字符,利用replace()实现全局替换。结合具体代码示例,解析各方法的适用场景与输出结果,帮助开发者高效清理字符串数据。
本文介绍Python开源库Vaex,它利用内存映射和延迟计算技术,使笔记本电脑也能秒开100GB以上的数据集。通过纽约出租车数据的实战案例,展示了Vaex在数据清洗、统计分析及可视化方面的卓越性能,无需分布式集群即可高效处理十亿级数据。