

Python爬虫实战:利用lxml库与XPath高效提取网页数据
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
2026-10-15
29
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
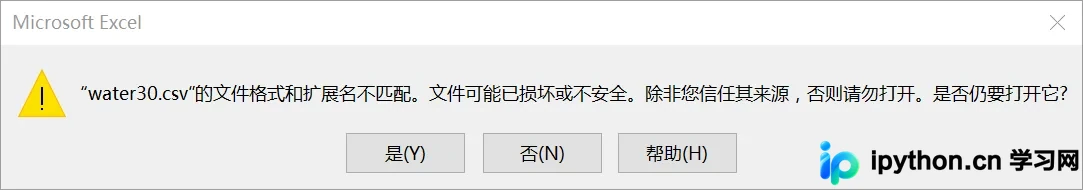
本文记录Python中读取CSV文件时常见的两个错误:CParserError提示字段数不匹配以及line contains NULL byte。通过对比直接修改后缀与“另存为”不同编码格式的操作,分析发现Excel另存为ANSI编码可解决此类解析问题。同时提供了csv模块与pandas模块对应的修正代码示例,供遇到类似编码导致解析失败的场景参考。
本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
本文详细介绍Python字典的常用操作,涵盖初始化、合并、推导式及collections标准库的使用。重点讲解defaultdict和Counter的高级用法,以及字典与JSON、Pandas DataFrame/Series之间的转换方法,帮助开发者高效处理数据结构。
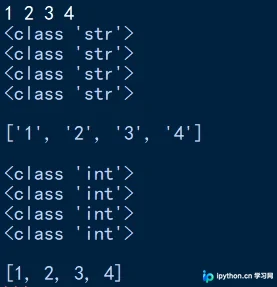
本文介绍在Python中如何在一行输入多个数字并存入列表。主要包含两种方法:一是使用split()分割字符串后通过索引遍历转换为int或float类型;二是结合map()与split()函数直接生成整型列表。文章提供了相关代码示例及注意事项,适用于Python3环境。
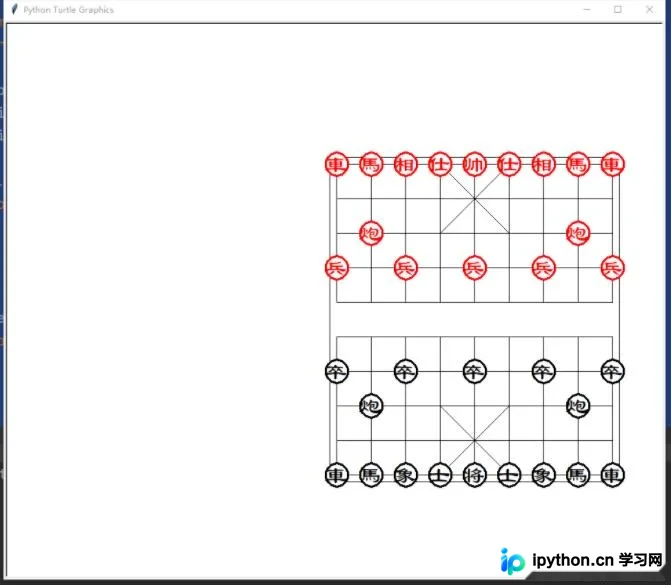
本文介绍了使用Python标准库Turtle实现中国象棋游戏的方法。通过定义棋盘尺寸与画笔速度,利用循环语句绘制纵横网格、九宫格斜线及河界楚河汉字区域。代码详细展示了红黑双方棋子的坐标定位与名称渲染逻辑,包括车马炮卒士象将的初始布局,为Python游戏开发提供完整参考。
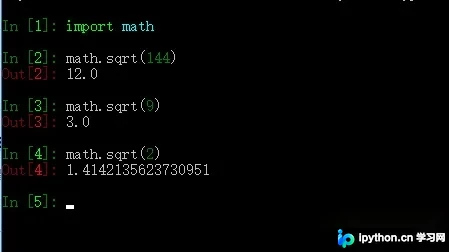
本文详细介绍在Python中实现数字开平方的三种常用方法:通过math模块调用sqrt函数、使用内置pow函数进行幂运算,以及直接利用数学表达式求解。文章分别演示了各方法的代码示例与注意事项,帮助开发者快速掌握Python中的根号计算技巧。
本文介绍如何使用Python PIL库实现按比例裁剪图片。通过计算目标宽高比,自动确定裁剪区域并保存结果。同时提供Image.resize方法实现图片等比例缩放,保持画面不变形。
本文详解Python中利用NumPy创建结构体数组的方法,涵盖通过字典定义字段类型、字节序控制及内存对齐设置。重点解析如何与C语言结构体二进制数据无缝交互,包括读写、字段访问及视图操作,并提供Python类模拟结构体的替代方案,适用于高性能数据处理场景。
本文介绍如何使用Python的python-docx库实现Word文档的自动化读取。通过解析Document对象,获取段落(Paragraph)和表格(Table)内容,提取其中的文本字符串。文章涵盖库的安装、核心概念解析以及具体的代码示例,帮助开发者快速掌握Word文件内容提取技巧。
本文介绍如何使用Python计算100以内所有质数的和。质数定义为大于1且仅能被1和自身整除的自然数。通过嵌套循环遍历2到100之间的数字,利用取模运算判断因子,累加符合条件的质数,最终输出总和为1060。该方法适用于基础数值计算场景。
本文介绍Python中删除字符串最后一个字符的三种常用方法:利用strip()移除指定尾缀、将字符串转为列表后使用pop()删除末尾元素,以及通过切片操作截取子串。每种方法均提供语法说明与代码示例,帮助开发者根据实际需求选择最合适的实现方式。