

Python批量处理多DNS多域名nslookup解析
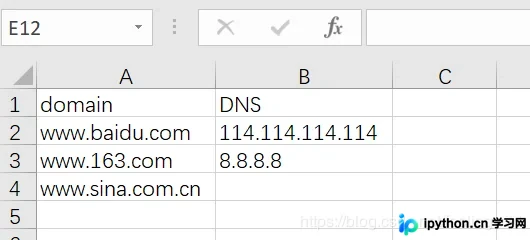
本文介绍如何使用Python脚本批量执行nslookup命令,实现多域名与多DNS服务器的组合解析。通过读取CSV文件获取域名和DNS列表,利用subprocess调用系统命令并解析返回结果,最终将解析数据保存为CSV文件,便于后续查看与分析。
2026-10-14
17
本文介绍如何使用Python脚本批量执行nslookup命令,实现多域名与多DNS服务器的组合解析。通过读取CSV文件获取域名和DNS列表,利用subprocess调用系统命令并解析返回结果,最终将解析数据保存为CSV文件,便于后续查看与分析。
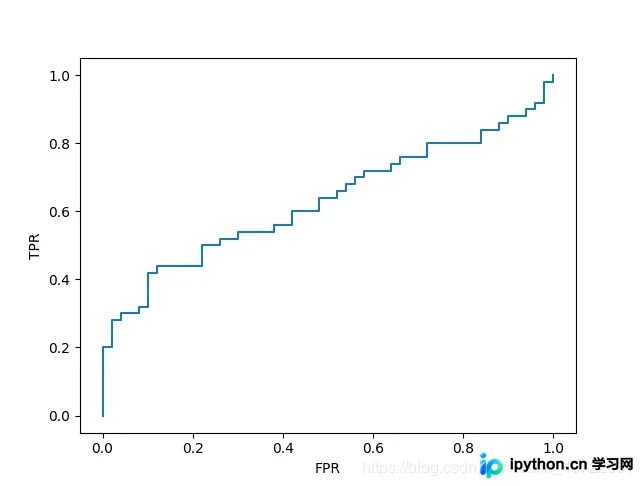
本文详细解析如何使用Python绘制ROC曲线。以鸢尾花数据集为例,通过回归拟合获取概率值,对测试数据进行排序,并基于TPR和FPR公式计算真阳性率与假阳性率。文章涵盖从数据预处理、模型预测到最终绘图的全过程,帮助读者理解分类模型的性能评估方法。
在Keras与TensorFlow混编场景下,直接设置模型层的trainable=False属性往往无法阻止优化器更新权重。本文通过引入tf.variable_scope区分变量作用域,利用tf.get_collection筛选特定作用域内的可训练变量,并在优化器中通过var_list指定更新范围,从而有效解决该兼容性问题。
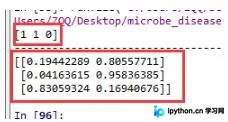
本文详细解析Python sklearn库中model.predict()与model.predict_proba()函数的核心区别。通过LogisticRegression示例代码,展示predict返回具体分类标签,而predict_proba返回各类别的概率分布。文章深入探讨了多分类场景下的概率输出逻辑,并解释了predict_proba结果如何依据self.classes_进行排序,帮助开发者准确理解模型输出格式。
本文详细解析 Python 中三种除法运算符 /、% 和 // 的具体行为。重点阐述 Python3 中 / 始终返回浮点数,而 // 执行向下取整的地板除逻辑;同时说明 % 用于计算余数。文章对比了 Python2 与 Python3 在整数除法上的版本差异,并通过具体代码示例展示正负数运算结果,帮助开发者准确掌握不同场景下的除法选择。
本文详细解析Python中split()与rsplit()方法的原理、语法及参数设置。通过指定分隔符sep和分割次数count,可实现对字符串的精确切片。文章包含完整代码示例,展示默认分隔符行为及自定义分隔符下的左右分割差异,帮助开发者掌握字符串处理技巧。
本文详细介绍 Python 内置函数 enumerate() 的核心功能与使用方法。该函数可将列表、元组或字符串等可遍历对象组合为索引序列,常用于 for 循环中。文章解析了 sequence 和 start 参数的具体作用,并通过包含列表、元组及字符串的多组代码实例,演示了默认索引与自定义起始索引的实际输出效果,帮助开发者高效处理数据遍历任务。
本文详解使用Python3.7和内置Tkinter库构建登录页面的关键技术。涵盖窗口标题与ICO图标设置、各类控件(输入框、按钮、复选框)的使用、绝对定位布局、Lambda事件传参及背景色配置。重点解析如何实现窗口屏幕居中及错误信息一次性提示,确保用户体验友好。
本文详细介绍 Sublime Text 3 的安装步骤及核心配置方法。涵盖 Package Control 包管理器的安装流程,包括通过快捷键调出菜单并联网下载的具体操作。同时提供中文语言包(ChineseLocalizations)及主题(如 ayu)的配置指南,帮助用户快速打造个性化的开发环境。
本文详细解答Python字典的值是否可以修改。通过实例演示如何更新现有键值对、添加新键值对以及使用update方法合并字典。同时指出直接访问不存在的键会抛出KeyError异常,并提供正确的添加方式,帮助开发者掌握字典的核心操作。
本文详解Python中自定义异常的捕获与处理。涵盖raise语句抛出异常、try-except-else-finally的标准执行顺序及可选性,以及通过继承Exception类创建自定义异常的方法。重点解析异常类的继承关系对捕获范围的影响,确保代码健壮性。
本文详解Python中打开文件的多种方法。从基础的open函数及其读写模式(r, w, a等)入手,分析未指定编码和异常处理时的风险。重点介绍Python3的encoding参数,以及确保代码在Python2和Python3下兼容的codecs与io模块用法。最后推荐最安全的with上下文管理器方式,自动管理文件关闭,避免资源泄露。