

Pandas中Dataframe与Series转换List及Dict的方法详解
本文详细讲解在Python Pandas库中,如何将Dataframe和Series对象转换为List列表格式,包括提取单列、去重及多维转换。同时介绍将Dataframe转换为字典(Dict)的两种常用方法:直接转换与设置索引后转换,并对比其结果差异,适用于词云生成等场景。
2026-10-14
17
本文详细讲解在Python Pandas库中,如何将Dataframe和Series对象转换为List列表格式,包括提取单列、去重及多维转换。同时介绍将Dataframe转换为字典(Dict)的两种常用方法:直接转换与设置索引后转换,并对比其结果差异,适用于词云生成等场景。
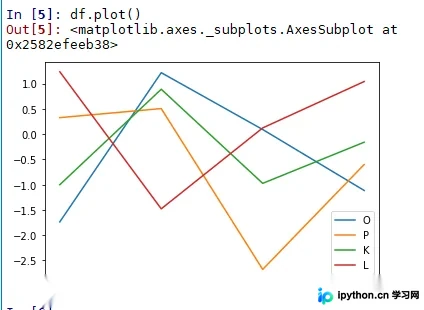
本文深入解析 pandas 库中 DataFrame.plot() 函数的核心参数与用法。详细讲解如何配置图形类型(折线、条形、散点等)、子图布局及坐标轴设置,并指出散点图需传入双Y列的关键细节。同时提供在 Jupyter Notebook 与脚本环境中创建画布、子图及显示图形的标准流程,帮助开发者高效实现数据可视化。
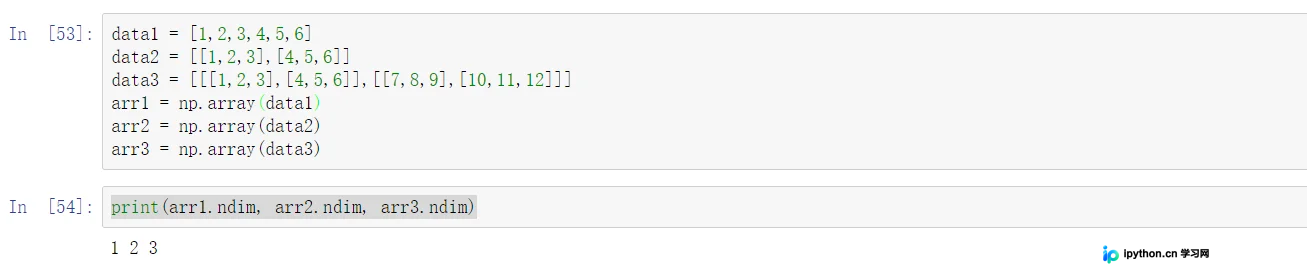
本文深入解析Numpy数组的四个核心属性与方法:ndim用于获取数组维度数,shape返回各维度大小的元组,dtype标识数据类型(如int32、float64),astype实现类型转换。内容涵盖一维至多维数组的shape理解,以及整型、浮点型、字符串间的类型转换规则与截断机制,帮助开发者准确掌握Numpy基础操作。
本文解析如何利用Python Flask框架快速搭建HTTP接口,主要用于Mock第三方服务及内部开发测试。通过展示Flask后端接收POST请求、解析JSON数据并返回响应的完整代码,以及使用requests库发起调用的客户端示例,帮助开发者掌握本地接口模拟的核心流程与关键参数配置。
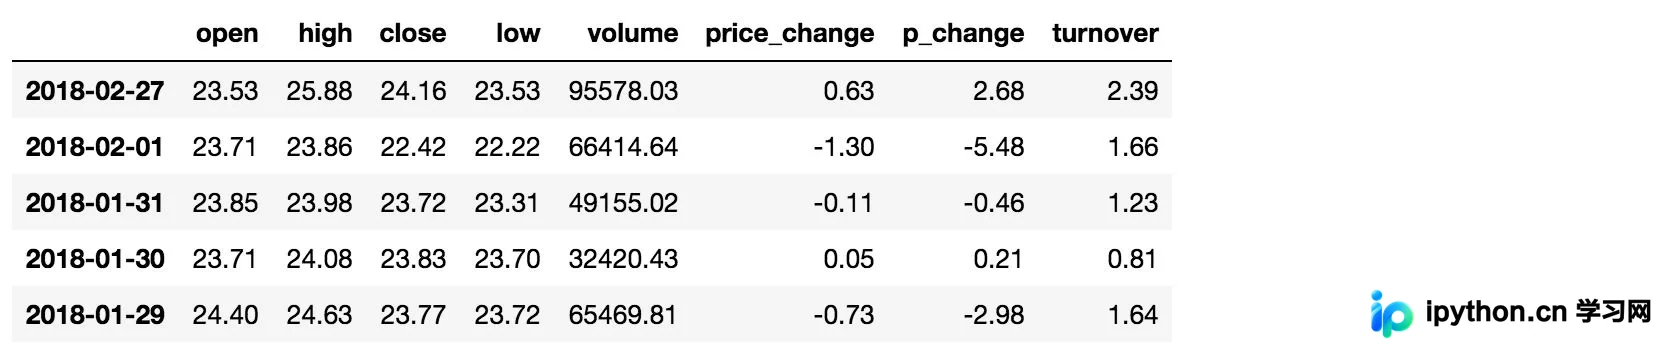
本文详细介绍 pandas DataFrame 的核心运算方法。涵盖 add/sub 算术运算、逻辑符号与 query/isin 筛选、describe 及各类统计函数(max/min/median/std等)、累计统计 cumsum,以及通过 apply 实现自定义列或行运算。
本文详细解析Python中io模块下的StringIO和BytesIO类。StringIO用于在内存中读写字符串,支持类似文件的写入与读取操作;BytesIO则用于处理二进制数据,如图片、视频等,需注意写入时需转换为UTF-8编码的bytes。通过具体代码示例,展示如何初始化、写入及读取数据,帮助开发者高效利用内存进行文件模拟操作。
本文解析Python中super()函数的两种调用方式,重点说明带参写法super(Class, self)的执行逻辑及MRO查找顺序。同时深入讲解通过双下划线__实现私有属性与方法封装的原理,包括如何限制继承以及通过getter/setter方法访问私有数据的具体操作。
本文详解Pandas在数据可视化中的应用,涵盖从创建包含正态分布与对数分布的DataFrame开始,演示如何结合Matplotlib自定义坐标轴、绘制平均线与垂线。进一步展示多子图布局、直方图对比及折线图生成,最后通过最小二乘法实现线性拟合,提供完整代码示例与参数说明。
Python是一款完全免费且开源的高层次脚本语言,其盈利模式依赖于庞大的用户生态。本文深入解析Python的解释性、交互式、面向对象及初学者友好等核心特性,并详细列举其易学性、跨平台可移植性、丰富的标准库以及可扩展性等显著优势,帮助开发者全面理解Python的价值。
本文解析Python中对象属性的两种处理方式:在类外部动态添加属性,以及在类内部通过self访问已添加的属性。通过海尔洗衣机的示例,展示如何在实例化后赋值,并在方法中读取这些属性,帮助理解Python动态特性的实际应用。
本文详细介绍在Windows系统中手动安装Python pip工具的全过程,包括下载解压、执行安装脚本及配置环境变量。同时深入解析pip常用命令,如安装、查看、升级和卸载包,并演示如何安装rarfile库以处理压缩文件,帮助开发者快速掌握Python依赖管理。
本文详细解析Python中函数的定义方法,涵盖def关键字语法、函数名规范、形参列表规则及空函数处理。通过数据库操作和文件读写两个实战案例,演示位置参数与关键字参数的应用,帮助开发者掌握函数创建的核心技巧。