

Python数据结构实现:栈、队列、双端队列与链表详解
本文详细讲解如何在Python中手动实现栈、队列、双端队列和链表四种基础数据结构。通过具体代码示例,演示了Stack、Queue、Deque和Link类的核心方法,包括入栈、出队、添加节点及遍历等功能,并结合烫手山芋游戏和回文检查案例说明实际应用。
2026-10-14
19
本文详细讲解如何在Python中手动实现栈、队列、双端队列和链表四种基础数据结构。通过具体代码示例,演示了Stack、Queue、Deque和Link类的核心方法,包括入栈、出队、添加节点及遍历等功能,并结合烫手山芋游戏和回文检查案例说明实际应用。
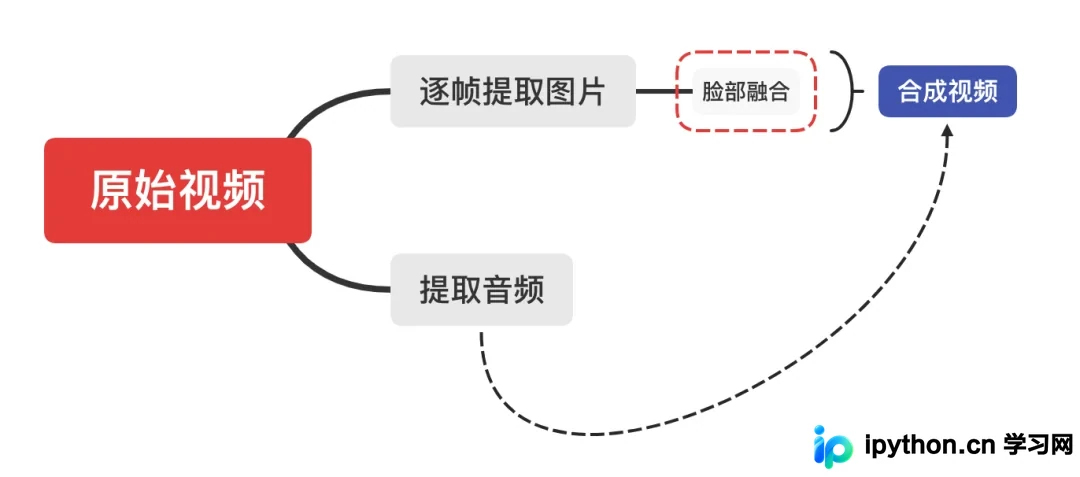
本文详细介绍如何利用Python实现视频的人脸融合功能。流程涵盖视频逐帧图片提取、基于概率阈值的目标人脸识别与融合处理、音频独立提取以及最终视频合成。通过具体代码示例,展示如何控制融合质量并保留原视频声音,为技术交流提供完整参考。
本文深入解析Python中的变量作用域机制,详细区分局部变量与全局变量的定义、生命周期及交互方式。通过代码示例演示如何通过返回值或global关键字在函数内外共享数据,并指出直接修改外部变量可能引发的UnboundLocalError错误,帮助开发者避免常见陷阱,编写更规范的Python代码。
本文详解Pandas中处理缺失值的两种主要方式。首先介绍针对np.nan类型缺失值的直接删除(dropna)与均值/自定义值填充(fillna)操作;其次讲解如何处理带有特定标记的非标准缺失值,通过replace将其转换为np.nan后再进行常规处理。
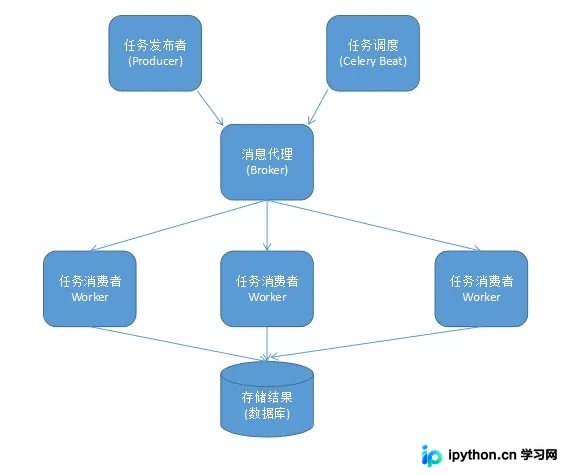
本文深入解析Celery作为分布式消息传输异步任务队列的核心原理,涵盖Producer、Worker、Broker等组件架构。详细演示基于Redis和RabbitMQ的安装配置流程,通过完整代码示例展示如何创建Celery应用、注册异步任务、配置消息代理及结果后端,并指导用户完成从启动Worker到调用delay()执行任务的完整操作闭环。
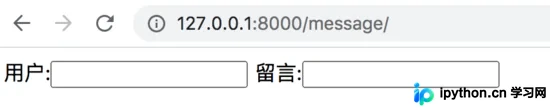
本文介绍在 Django 中构建模板表单的两种核心方式:手动定义字段与基于数据表映射。通过具体代码示例,演示如何创建 forms.py 并在视图中传递给模板,实现从基础 Form 到 ModelForm 的灵活应用,帮助开发者快速掌握 Django 表单处理机制。
本文详细介绍Python中Pandas库对DataFrame行和列的选取与删除方法。重点解决读取CSV时产生的未命名索引列问题,通过重命名或删除列索引实现数据清洗。涵盖iloc、loc、head、tail等常用函数的使用场景及版本兼容性注意事项,帮助开发者高效处理结构化数据。
本文深入解析Django中间件的运行机制与核心流程,详细阐述process_request、process_view等五大关键方法的触发时机与作用。通过具体代码示例,演示如何继承MiddlewareMixin实现IP限制、URL过滤及缓存等常见场景,并对比中间件与装饰器的适用边界,帮助开发者高效构建全局请求处理逻辑。
本文总结了在pandas库中创建DataFrame的七种常用方法,包括利用Python字典、指定列与索引、读取Excel/CSV文件、使用NumPy数组、合并元组以及基于Series生成数据。文章提供了相应的代码示例与注意事项,如读取Excel需安装xlrd包,旨在帮助开发者快速掌握数据框的构建技巧。
本文介绍如何使用Python内置的zipfile模块,结合密码字典对压缩文件进行暴力破解。通过遍历字典中的密码尝试解压,利用异常处理机制判断密码是否正确,从而快速定位压缩包口令。
本文深入解析Pandas中DataFrame的单列、多列及分组运算方法。通过map实现元素级操作,利用apply处理行或列聚合,结合transform进行组内映射,以及使用agg执行复杂分组统计。涵盖具体代码示例与参数说明,帮助开发者高效处理数据。
本文详细介绍在Python pandas中获取Dataframe元素值的多种方法。包括通过遍历、类字典属性访问Series,以及使用at、iat、loc和iloc等属性根据行索引、列名或索引位置精准获取单个元素、单行或多行数据,涵盖Series与Dataframe的返回类型差异。