

Python逻辑回归分类实现:从原理到通用模板
本文介绍Python中逻辑回归分类器的实现方法。逻辑回归通过最大似然概率构建方程,利用牛顿梯度上升求解参数。其优势在于计算成本低且易于理解,但可能面临欠拟合风险。文章提供了适用于多维数据集的完整代码模板,涵盖Sigmoid定义、参数迭代及预测函数,适合初学者快速上手。
2026-10-13
14
本文介绍Python中逻辑回归分类器的实现方法。逻辑回归通过最大似然概率构建方程,利用牛顿梯度上升求解参数。其优势在于计算成本低且易于理解,但可能面临欠拟合风险。文章提供了适用于多维数据集的完整代码模板,涵盖Sigmoid定义、参数迭代及预测函数,适合初学者快速上手。
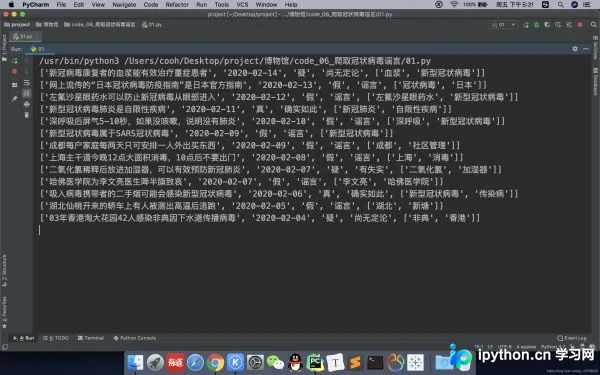
本文详细介绍如何使用Python爬取权威辟谣平台数据,并通过Pandas和Matplotlib进行可视化分析。文章涵盖从数据抓取、清洗嵌套列表关键字,到绘制谣言真假占比饼图及高频关键字柱状图的全过程,帮助读者掌握利用编程手段进行舆情数据分析的完整技能。
本文详解在Django项目中通过django-environ库实现多环境配置管理的方案。重点介绍如何创建并加载不同环境的.env文件(如local、product),通过PROJECT_ENV环境变量动态切换配置。同时提供Django Crontab定时任务在多环境下的配置技巧,确保定时脚本能正确读取对应环境的参数,提升部署效率与安全性。
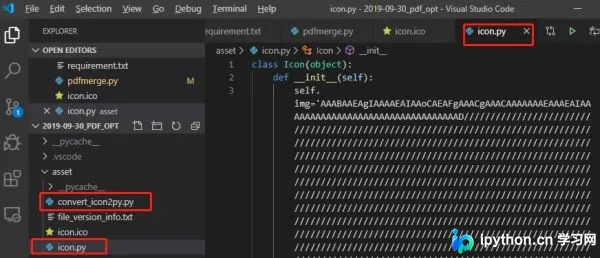
本文详解Python使用PyInstaller打包exe时常见的“Failed to execute script”及图标加载失败问题。通过终端运行exe查看日志定位原因,解决依赖包缺失及虚拟环境配置问题,并提供将图标嵌入代码并动态生成临时文件的方案,确保打包后的单文件exe能正确加载自定义图标。
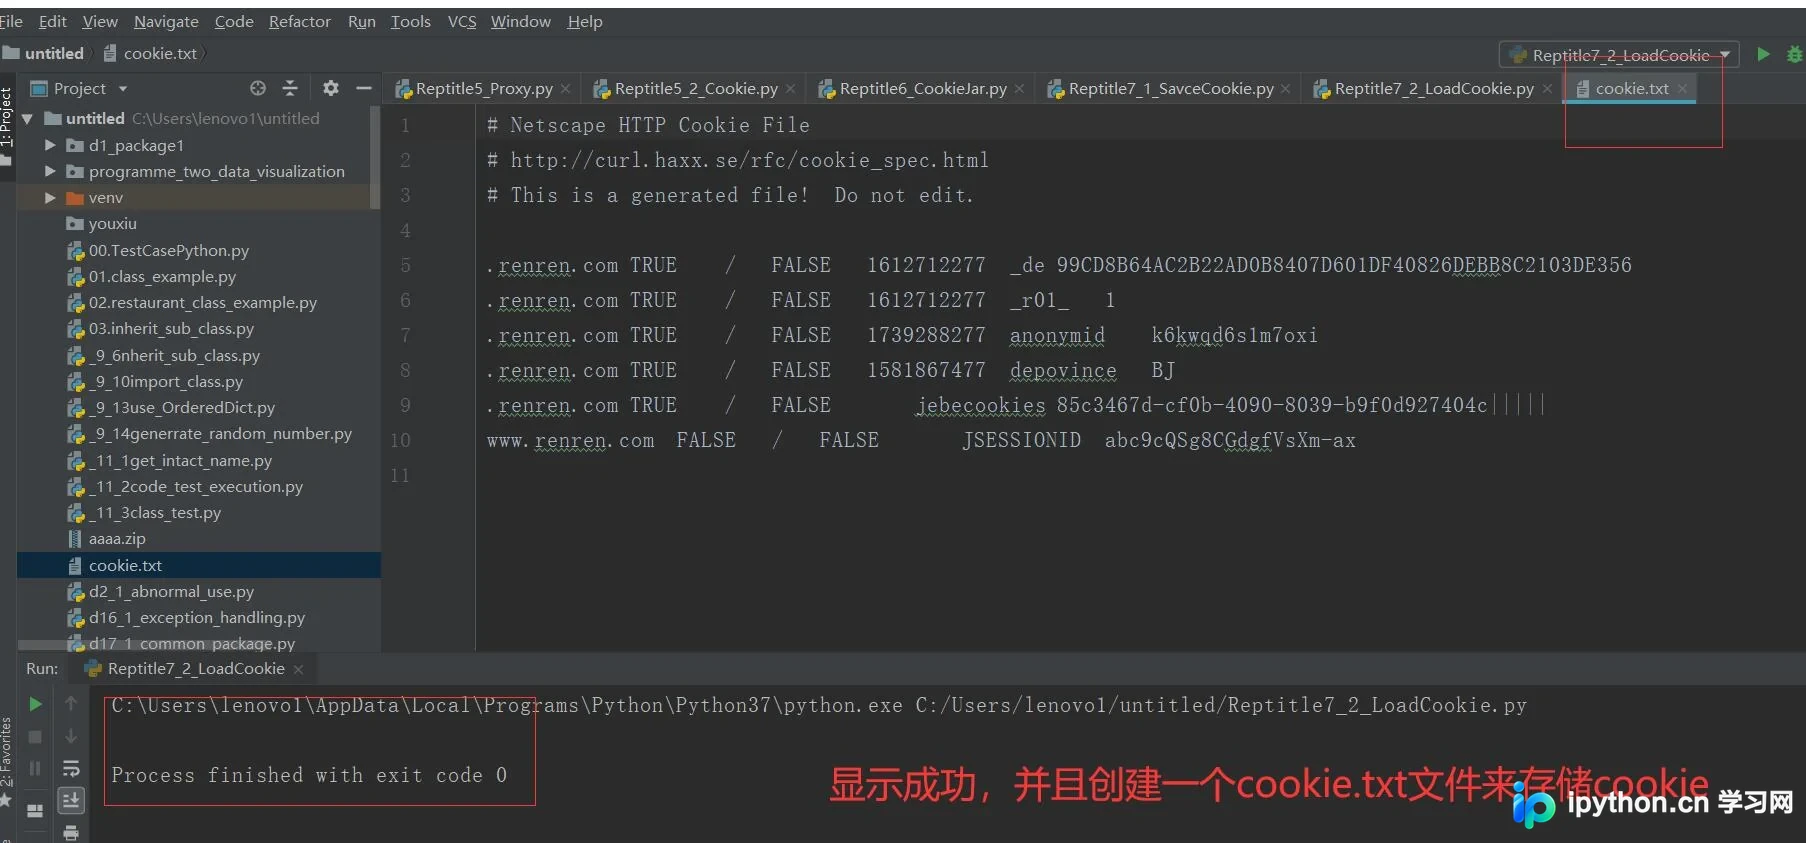
本文详解Python爬虫中Cookie的持久化保存与读取方法,利用FileCookieJar类实现登录状态的文件存储。同时介绍如何处理HTTPS请求中的SSL证书验证问题,通过替换默认上下文环境来忽略不信任的SSL证书,确保爬虫程序在复杂网络环境下的稳定运行。
本文提供使用 TensorFlow 批量生成多个 TFRecord 文件的完整代码示例。通过设定 shard 数量和每个 shard 的数据量,遍历指定目录下的图片资源,调整尺寸并序列化写入多个 TFRecord 文件,适用于大规模图像数据的模型训练准备。
本文深入解析Python内置函数zip(),演示如何将多个可迭代对象打包为元组列表。涵盖长度不等时的截断行为、*号解压操作、for循环中的并行迭代技巧,以及利用zip实现二维矩阵行列互换的高级用法。此外,还介绍了基于zip的概率元素采样方法,帮助开发者高效处理数据组合与转换任务。
本文详细介绍 TensorFlow 中实现数据类型转换的核心函数,包括 tf.to_bfloat16、tf.to_complex128、tf.to_complex64、tf.to_double、tf.to_float、tf.to_int32 及 tf.to_int64。内容涵盖各函数的参数定义、返回值类型、潜在异常处理及代码示例,帮助开发者准确进行张量类型强制转换。
本文详细介绍 TensorFlow 中三种数据读取方式,重点讲解如何使用 TFRecord 格式保存和读取图片数据。通过 Slim 库实现高效的数据序列化与反序列化,涵盖从文件路径获取、参数配置到批量读取的完整流程,适用于大规模图像数据集的训练与验证。
本文介绍使用Python编写简易爬虫并将抓取的数据保存至本地文件的方法。通过urllib获取网页内容,利用正则表达式提取图片链接,最后将图片保存至指定本地目录。文章基于Python 3.5环境,重点讲解了文件存储的实现细节及正则匹配的注意事项,适合初学者参考。
本文详细解析Python环境变量的核心作用,包括如何在CMD中直接调用python命令、确保pip install正确识别包路径,以及解决IDE找不到Python解析器的问题。同时整理PYTHONPATH、PYTHONHOME等关键变量说明,帮助开发者快速配置开发环境。
本文详细介绍Python中NetworkX库的核心功能,涵盖无向图与有向图的创建、顶点与边的属性管理、图的遍历算法(DFS/BFS)及可视化绘制。重点解析PageRank算法原理与参数配置,通过代码示例演示如何计算节点重要性,适用于社会网络分析与复杂系统建模。