

全栈开发必学指南:HTML语义化布局进阶技巧:性能优化、最佳实践与避坑要点
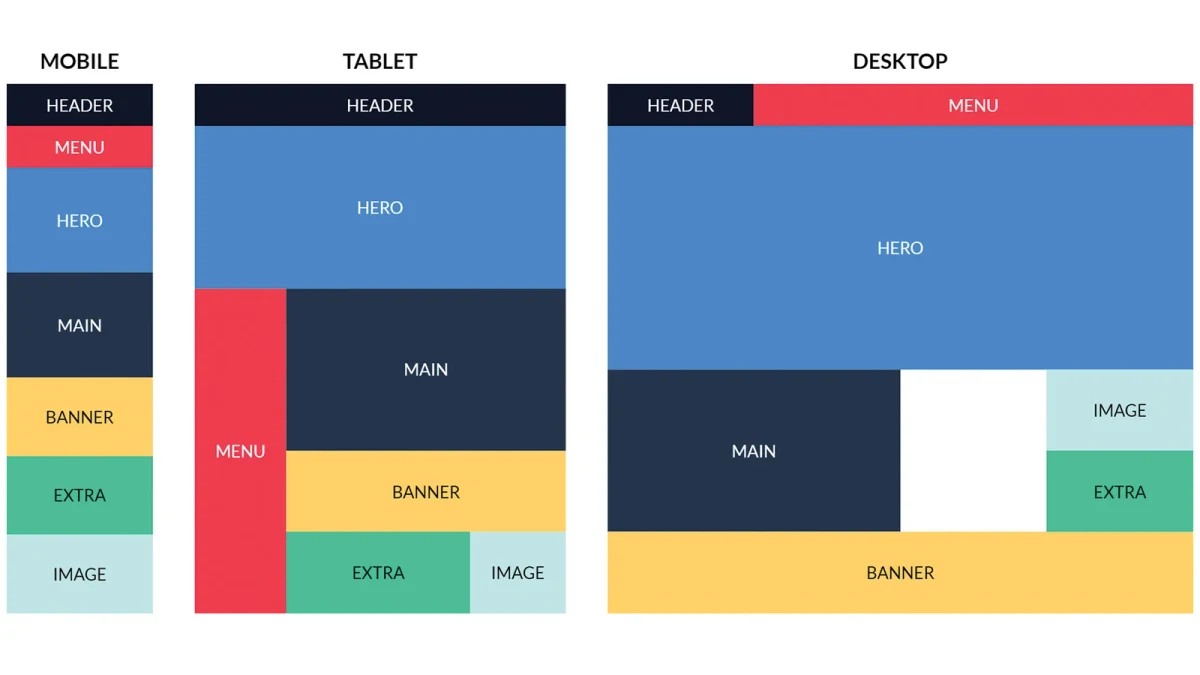
从语义化结构优化、可访问性与SEO实践,到页面性能验证和常见误区排查,系统掌握HTML语义化布局的进阶方法,帮助全栈开发者构建结构清晰、易维护且高性能的网页。
2026-09-08
3
从语义化结构优化、可访问性与SEO实践,到页面性能验证和常见误区排查,系统掌握HTML语义化布局的进阶方法,帮助全栈开发者构建结构清晰、易维护且高性能的网页。
系统梳理HTML语义化布局开发中的高频问题,从标签选用、页面结构、嵌套关系到样式与可访问性进行排查,并通过完整案例验证修复效果,帮助开发者建立规范、易维护的语义化页面结构。
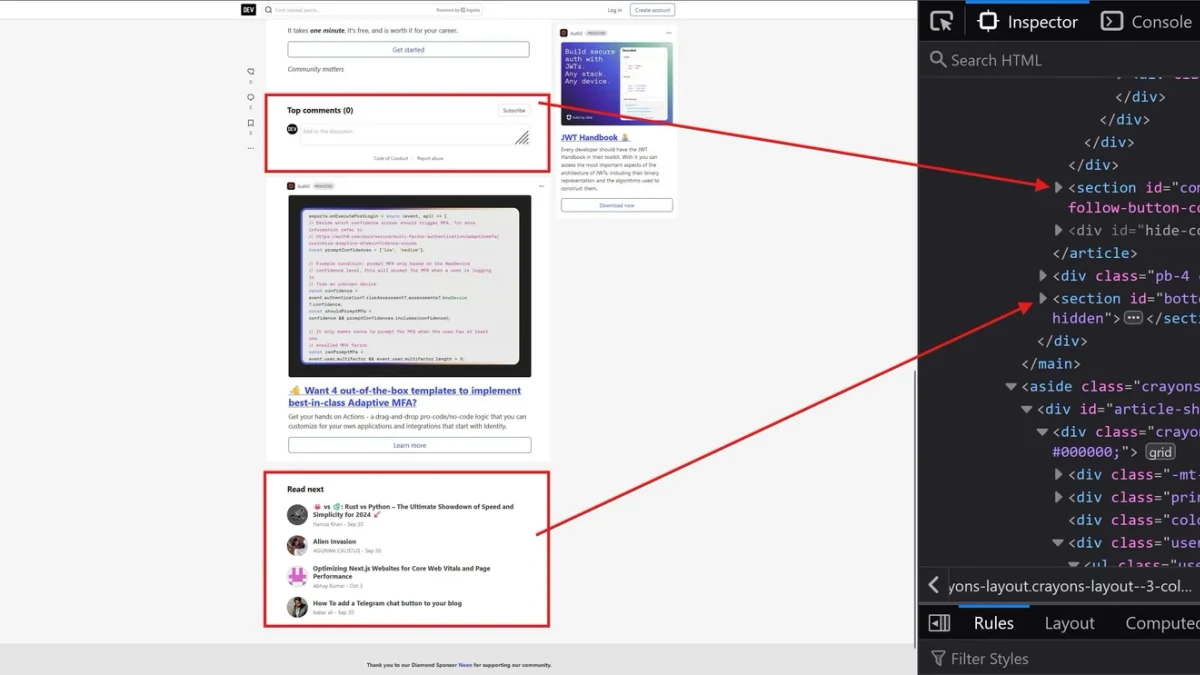
从语义化标签选择、页面结构搭建到样式布局与浏览器验证,系统掌握 HTML 语义化布局的实战方法,并通过完整案例了解常见误区与优化技巧。
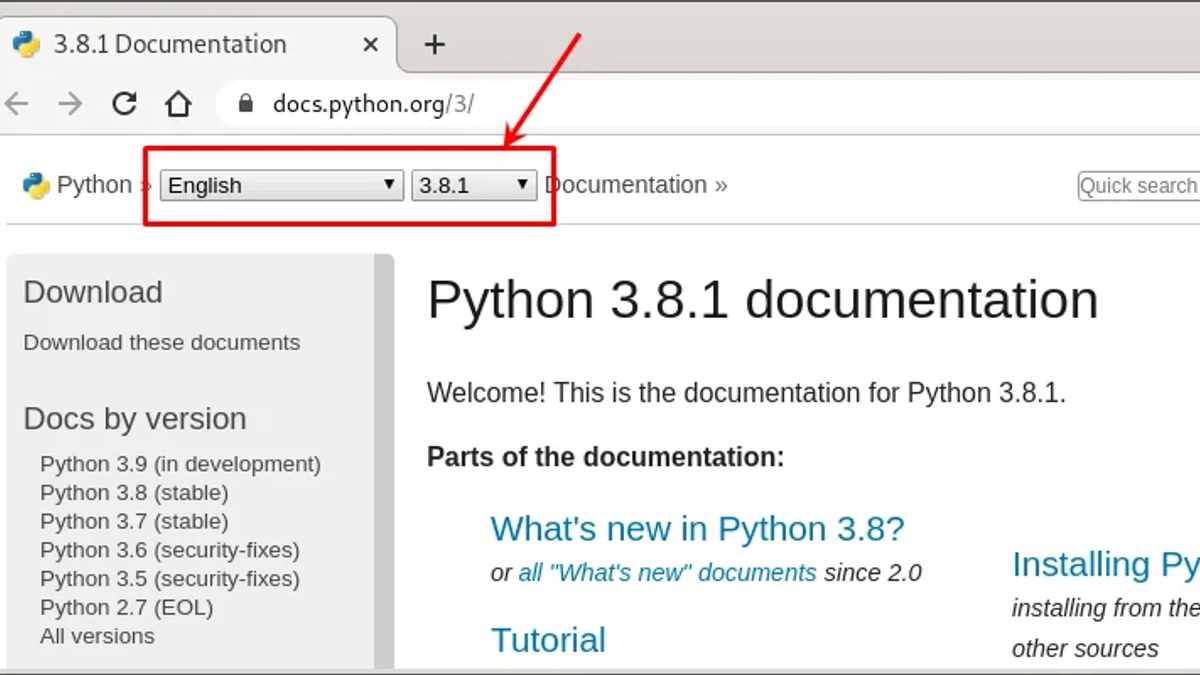
针对无法联网或网络受限的开发环境,介绍如何准备本地Python手册、快速检索API与标准库文档,并通过版本核对和实际运行验证避免查错文档。
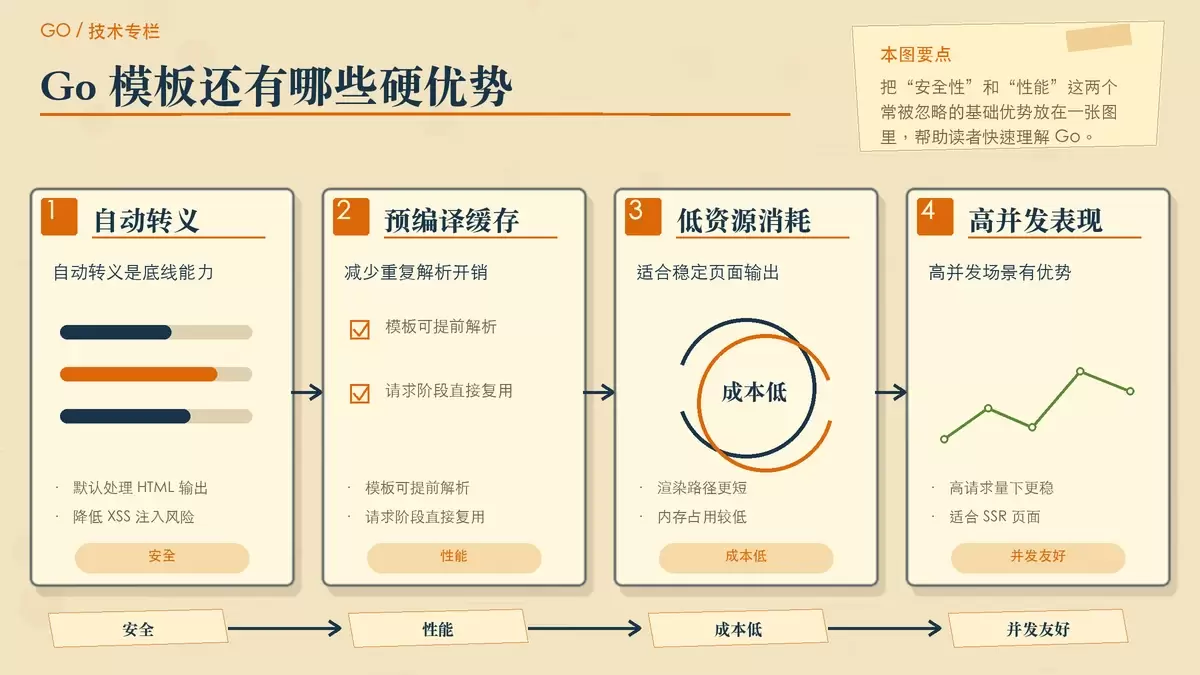
前后端分离已成主流,但这不等于 Go 模板引擎失去价值。对于服务端渲染、内部后台、邮件与报告生成等场景,`html/template` 依旧凭借自动转义、低开销和部署简单保持竞争力,关键在于按业务复杂度选择,而不是被架构潮流带着走。
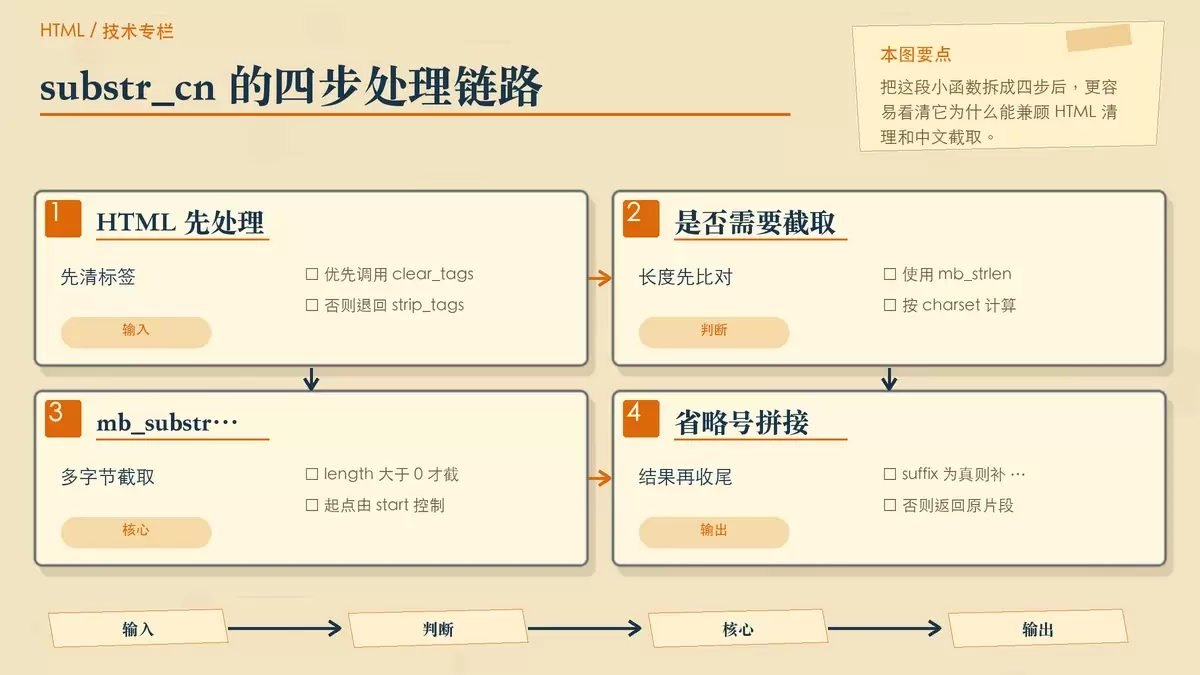
这篇示例围绕一个常见 PHP 小工具展开:先清除 HTML 标签,再按中文安全的方式截取字符串。原函数实现很短,但是否适合直接用于列表摘要、内容预览,还要看它对长度判断、省略号追加和字符集参数的处理是否符合你的场景。
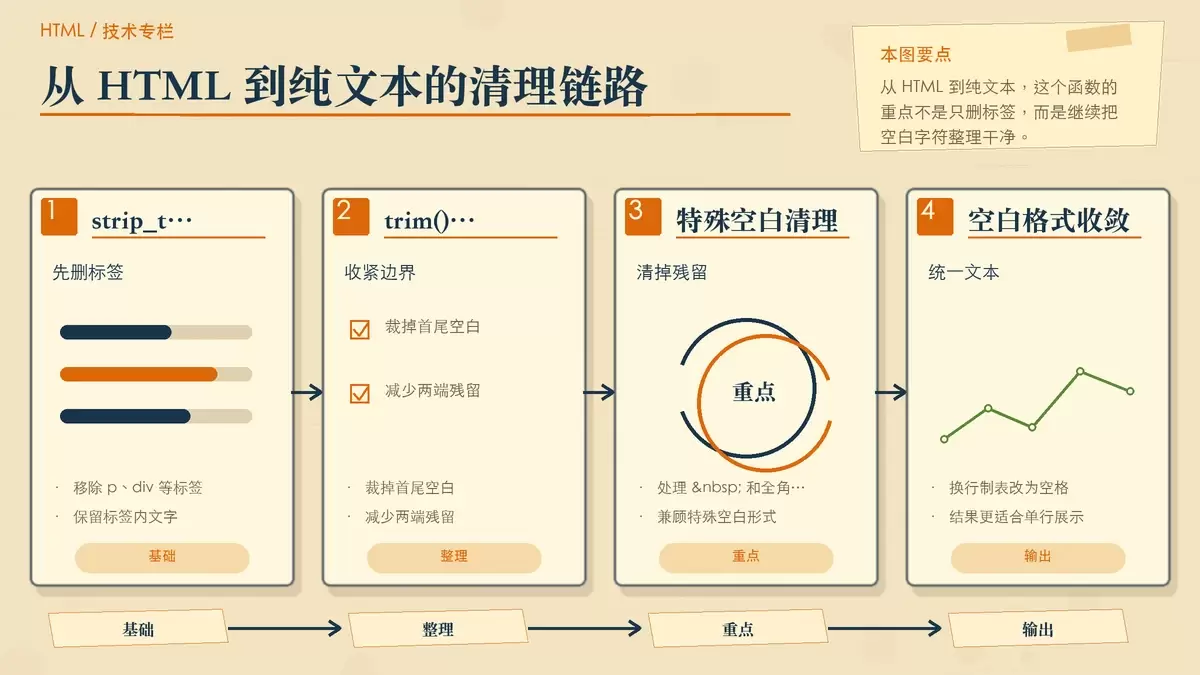
在 PHP 里,`strip_tags()` 能去掉 HTML 标签,但处理后常会留下 ` `、全角空格、换行符等残留。本文围绕一个 `clear_tags()` 示例,拆解它如何把 HTML 内容进一步整理成更干净的纯文本,并指出代码里各步实际起到的作用与适用场景。
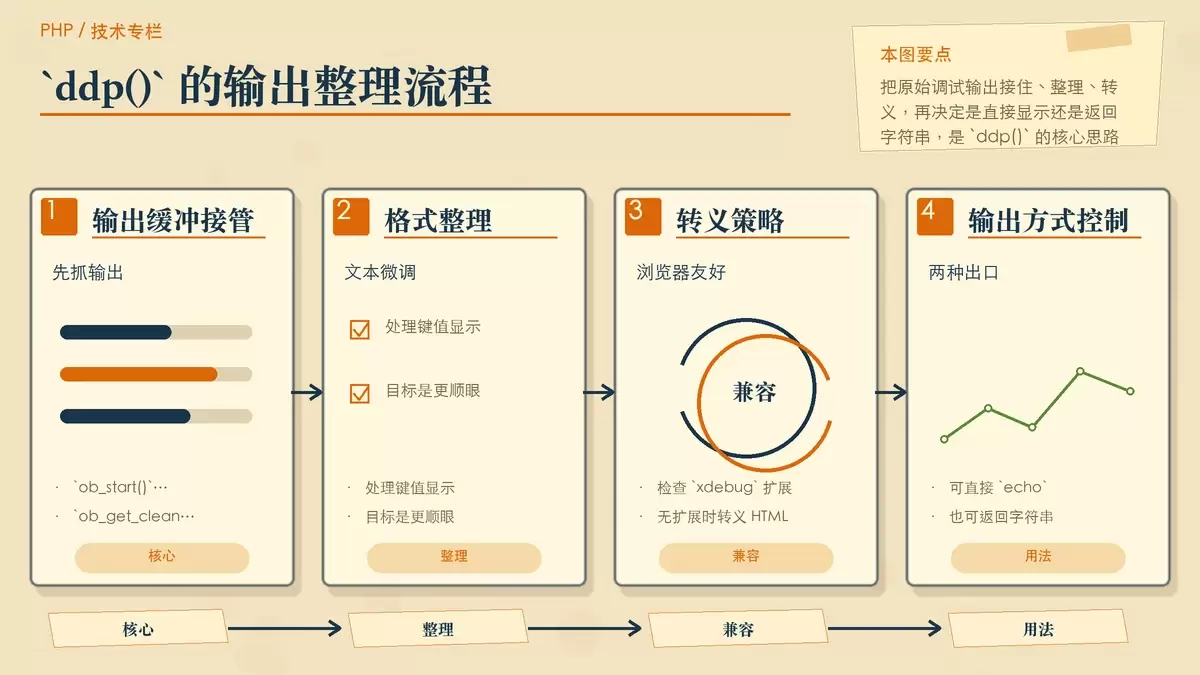
PHP 自带的 `print_r` 和 `var_dump` 虽然好用,但直接输出到浏览器时可读性往往很差。本文基于一个改造过的 `ddp()` 函数,拆解它如何通过输出缓冲、换行清理和 HTML 转义,让调试信息更适合网页查看,也说明参数分别解决了什么问题。
本文详解如何使用 Python 内置的 HTMLParser 模块解析网页 HTML 内容。通过继承 HTMLParser 类并重写 handle_starttag、handle_endtag 和 handle_data 方法,可以精准提取特定标签(如 title)的属性值及文本内容。文章提供了完整的代码示例,展示了从解析器初始化到数据提取的全过程,帮助开发者掌握这种基础的 HTML 解析方式。
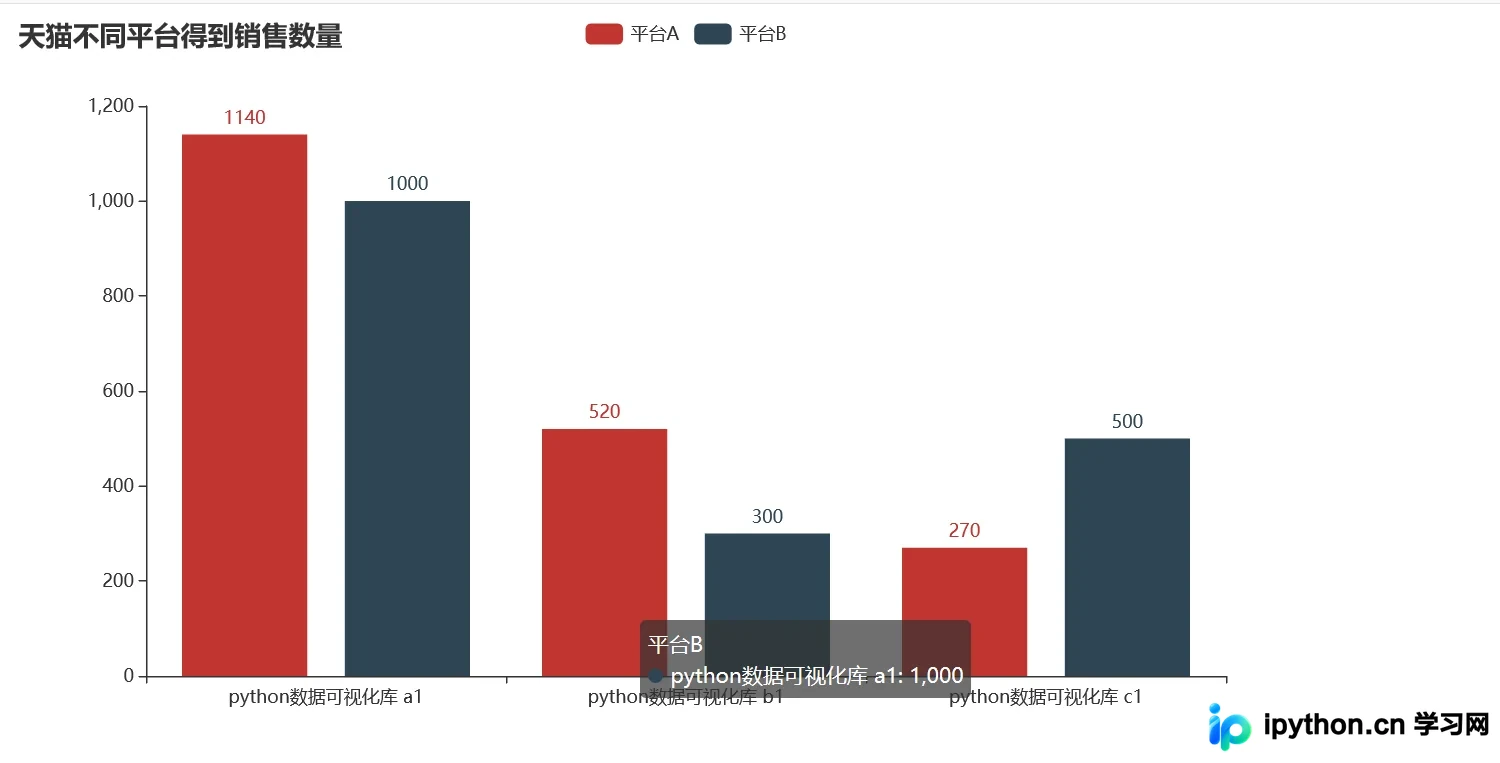
本文介绍了如何使用Python3和pyecharts库生成HTML格式的柱状图和折线图。通过安装pyecharts库,利用Bar和Line类分别创建图表,并设置x轴、y轴数据及全局选项,最终渲染为独立的HTML文件。
本文详细介绍在Python中处理HTML转义字符的五种方法。涵盖Python2的HTMLParser模块、Python3中html.parser的迁移、Python3.4新增的html.unescape推荐用法,以及xml.sax模块的支持方案。文章对比了各版本的兼容性与废弃状态,帮助开发者选择合适的数据清洗工具。
本文介绍如何在Python中使用lxml模块结合XPath语法解析HTML文档。通过对比jQuery和正则表达式,演示如何定位特定节点、提取文本及处理嵌套结构,并详细解析XPath基本语法如路径分隔、属性过滤及节点函数,帮助开发者掌握高效的网页数据抓取技巧。