


很多人在用 PHP 提取纯文本时,第一反应都是 `strip_tags()`,但实际结果往往并不干净:标签没了,空格、换行、` ` 之类的残留还在。下面这段 `clear_tags()` 的思路,就是在 `strip_tags()` 之后继续做一次文本清洗,适合需要把 HTML 内容整理成展示摘要、搜索索引或普通文本输出的场景。
为什么只用 strip_tags() 还不够
`strip_tags()` 的职责主要是移除 HTML 标签,本身并不负责把各种空白字符统一处理掉。因此,原始内容里如果混有 ` `、全角空格、换行符,或者标签删除后留下多余空白,最终得到的字符串看起来还是会“脏”。
也就是说,如果目标只是“去标签”,`strip_tags()` 已经够用;但如果目标是“把 HTML 转成尽量整洁的纯文本”,还需要继续补一层清理逻辑。
clear_tags() 函数代码
/**
 * 清除html标签
 */
function clear_tags($str)
{
    $str = strip_tags($str);
    //首先去掉头尾空格
    $str = trim($str);
    $str = preg_replace("/(s| | |xc2xa0)/", "", strip_tags($str));
    //接着去掉两个空格以上的
    $str = preg_replace('/s(?=s)/', '', $str);
    //最后将非空格替换为一个空格
    $str = preg_replace('/[nrt]/', ' ', $str);
    return $str;
}

// echo clear_tags('<p>Hello,World!!!</p>');
// 输出:
// Hello,World!!!
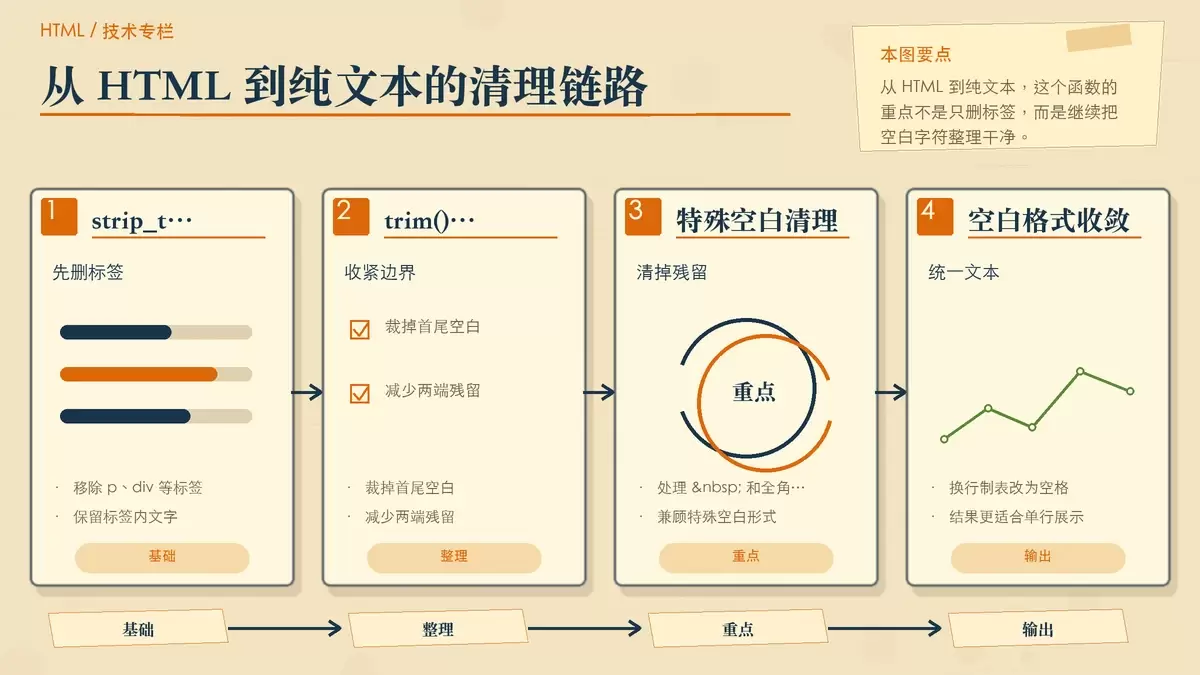
这段函数的核心思路很直接:先删标签,再裁掉首尾空白,然后继续处理特殊空格和换行,尽量把结果收敛成普通文本。
这段函数实际做了什么
1. 先用 strip_tags() 去掉 HTML 标签
第一步调用:
$str = strip_tags($str);它会把类似 `<p>`、`<div>` 这样的标签直接移除,只保留其中的文字内容。这一步解决的是结构层面的 HTML 标签问题。
2. 用 trim() 清掉头尾空白
$str = trim($str);标签删除后,字符串首尾常会留下空格或换行。`trim()` 可以先把头尾这些多余内容裁掉,避免后续输出时两端不整洁。
3. 继续清理特殊空白字符
$str = preg_replace("/(s| | |xc2xa0)/", "", strip_tags($str));这一句的目标,是继续处理普通空格样式、` `、全角空格以及一些特殊编码形式的空白字符。对很多网页抓取内容或富文本字段来说,问题往往不在标签本身,而在这些看不见却会影响显示的空白残留。
需要注意的是,原示例里正则写法保持了原样展示;从代码意图来看,它是在集中删除几类常见空白内容,而不是再次处理 HTML 结构。
4. 压缩重复空格
$str = preg_replace('/s(?=s)/', '', $str);这一步的注释写的是“去掉两个空格以上的”,也就是希望把连续出现的空白进一步压缩,避免文本中间出现明显断层。对于从富文本编辑器、网页正文里提取出来的内容,这一步通常很有必要。
5. 把换行和制表符替换成普通空格
$str = preg_replace('/[nrt]/', ' ', $str);函数最后把换行、回车、制表一类字符统一替换成普通空格。这样做的好处是,输出结果更适合做单行展示,比如文章摘要、列表描述、搜索结果预览等,不会因为原文里的换行而打乱页面布局。
适合用在哪些场景
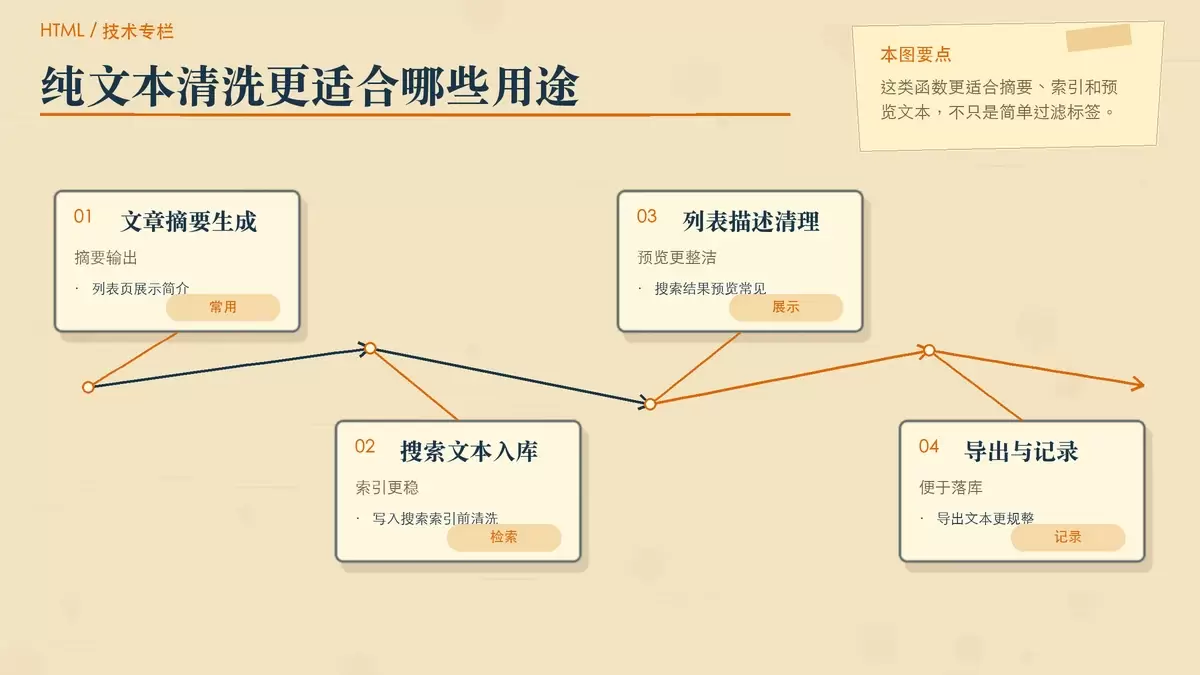
如果你的目标是把 HTML 内容转成较干净的纯文本,这类函数比单独使用 `strip_tags()` 更实用,常见场景包括:
- 生成文章摘要或列表简介;
- 清洗富文本输入后再写入搜索索引;
- 把网页内容转换成便于比较、导出或日志记录的普通文本。
示例里的调用结果也很直观:
// echo clear_tags('<p>Hello,World!!!</p>');
// 输出:
// Hello,World!!!
输入是带 `<p>` 标签的 HTML 字符串,输出则只保留文本 `Hello,World!!!`。
这段方法的价值在哪里
这段 `clear_tags()` 的价值,不是替代 PHP 原生 `strip_tags()`,而是在“去标签”之后继续补做空白清洗,让最终文本更接近可直接使用的结果。对于只需要简单过滤标签的场景,原生函数已经足够;但只要你关心输出是否整洁、是否适合展示,这种二次清理思路就很值得保留。









