


在文章列表、评论摘要、内容预览这些场景里,最常见的问题不是“怎么截字符串”,而是“截完之后会不会把中文切坏、会不会把 HTML 标签带出来”。这段 substr_cn 函数就是为这个需求准备的:先清标签,再用 mb_strlen 和 mb_substr 做多字节安全截取。读完你可以快速判断,这个写法适不适合直接放进项目里,以及哪些细节值得顺手修正。
这个函数解决了什么问题
普通的字符串截取在处理中文内容时,常见风险有两个:
- 字符串里带有 HTML 标签,直接截取会把标签残片一起带进结果。
- 使用不支持多字节字符的截取方式时,中文可能被截断成乱码。
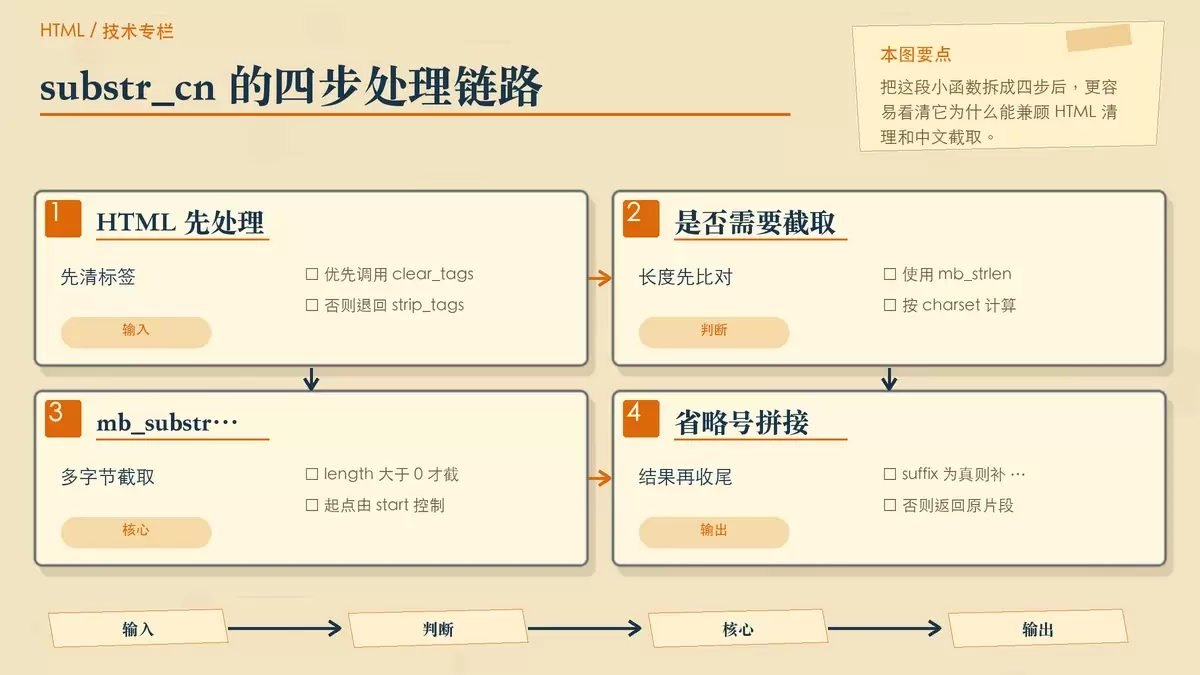
substr_cn 的思路比较直接:先把 HTML 标签去掉,再根据指定字符集执行多字节安全截取,最后按需补上省略号。
/**
 * 清除html标签,字符串截取
 * 支持中文
 * @author TechLee
 */
function substr_cn($str, $length = 0, $start = 0, $charset = "utf-8", $suffix = true)
{
    $str = function_exists('clear_tags') ? clear_tags($str) : strip_tags($str);
    if ($length > 0 && mb_strlen($str, $charset) <= $length) {
        return $str;
    }
    $slice = $length > 0 ? mb_substr($str, $start, $length, $charset) : $str;
    if ($suffix) {
        return $slice . "…";
    }
    return $slice;
}

echo substr_cn('PHP是世界上最好的语言,是宇宙第一语言!', 10);
// 输出:
// PHP是世界上最好的…
函数的执行流程拆开看
先清理 HTML 标签
函数第一步会判断是否存在 clear_tags,如果存在就优先调用;如果没有,就退回到 PHP 内置的 strip_tags:
$str = function_exists('clear_tags') ? clear_tags($str) : strip_tags($str);这意味着它默认把输入当成“可能包含 HTML 的正文”来处理,比较适合文章摘要、富文本简介这类场景。如果你的输入原本就是纯文本,这一步虽然不影响结果,但属于额外处理。
长度足够短时直接返回
接下来这段判断决定了是否真的需要截取:
if ($length > 0 && mb_strlen($str, $charset) <= $length) {
    return $str;
}
这里用的是 mb_strlen($str, $charset),关键点在于它按多字节字符长度计算,不会把一个中文字符拆成多个字节来误判长度。也就是说,传入 utf-8 时,中文长度判断是可靠的。
真正的截取由 mb_substr 完成
只有在 $length > 0 时,函数才会调用 mb_substr:
$slice = $length > 0 ? mb_substr($str, $start, $length, $charset) : $str;这里保留了 $start 和 $charset 两个参数,因此它不只是“从头截 10 个字”,也支持从任意起始位置按指定字符集截取。对需要二次处理标题、摘要或分段预览的代码来说,这种参数设计是够用的。
省略号逻辑要注意什么
函数最后一段是:
if ($suffix) {
    return $slice . "…";
}
return $slice;
这段逻辑很实用,但也有一个容易忽略的行为:只要 $suffix 为 true,就会直接在结果后拼接 …。
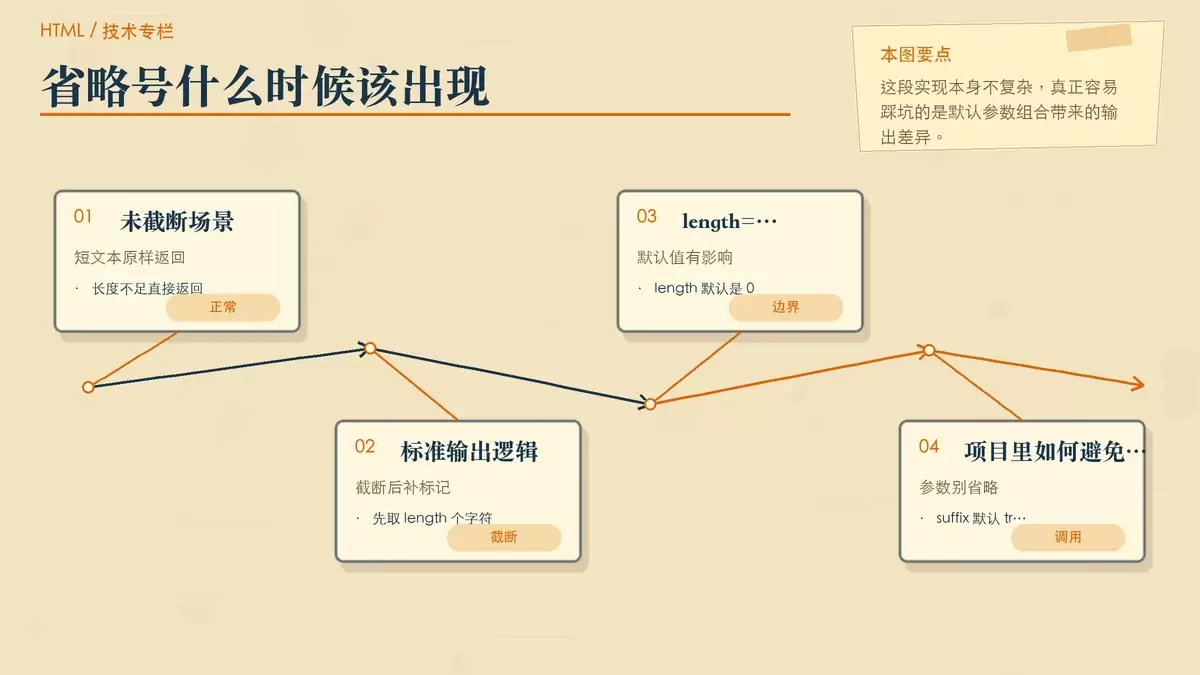
好在前面已经有一次“长度不足则直接返回原文”的判断,所以常规情况下,只有真正发生截断时才会补省略号。不过还要注意一个边界:当 $length = 0 时,函数会把整个字符串赋给 $slice,如果 $suffix 仍然是 true,最终结果会变成“原文 + …”。
也就是说,这个函数默认更适合明确传入截取长度的场景。如果你把 $length 留在默认值 0,输出行为未必符合直觉。
示例输出与适用场景
原文给出的调用方式如下:
echo substr_cn('PHP是世界上最好的语言,是宇宙第一语言!', 10);
// 输出:
// PHP是世界上最好的…
这个结果说明两件事:
- 中文内容是按字符正常截断的,没有出现乱码。
- 截取后自动补上了中文省略号
…。
如果你的需求是生成文章列表摘要、商品介绍短描述、评论预览文本,这个实现已经能覆盖大部分基础用法。它的优势是短小、依赖少、逻辑清楚,直接放进老项目也没什么理解门槛。
放进项目之前,最好先确认这几点
从教程示例角度看,这个函数已经完成了“支持中文 HTML 字符串截取”的核心目标;从实际项目角度看,仍有几个判断点值得确认:
- 环境是否开启 mbstring:
mb_strlen和mb_substr都依赖多字节字符串扩展。 - 字符集是否统一:默认参数是
"utf-8",如果项目历史包袱里混有其他编码,结果可能不稳定。 - 是否需要保留部分 HTML:这个函数会先清掉标签,不适合“保留部分格式再截取”的需求。
- 默认参数是否符合团队习惯:尤其是
$length = 0和$suffix = true的组合,最好在调用层明确传值。
如果你的目标只是做一个简洁可靠的中文摘要函数,这个版本已经够轻量;如果还要考虑富文本保留、表情符号、复杂编码兼容等问题,就需要在这个基础上继续扩展,而不能把它当成所有文本场景的通用方案。









