SQL 查询连续 N 天登录用户:基于窗口函数与日期差值算法
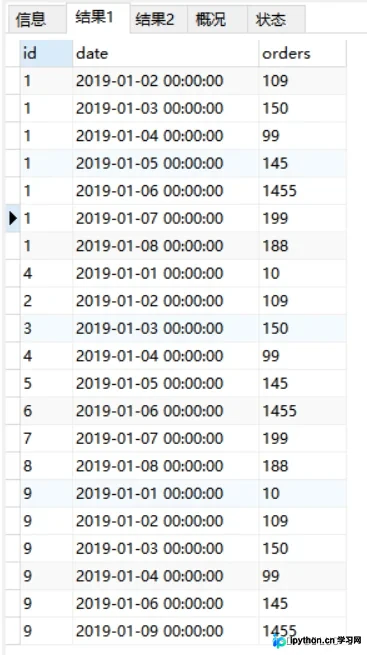
本文介绍使用 MySQL 窗口函数 ROW_NUMBER() 结合日期减法,解决“连续 N 天登录用户”查询的技术方案。通过为每日记录排序并减去天数,生成恒定日期分组,从而利用 COUNT 和 HAVING 筛选出满足连续天数要求的用户及起止时间。
2026-10-16
7
本文介绍使用 MySQL 窗口函数 ROW_NUMBER() 结合日期减法,解决“连续 N 天登录用户”查询的技术方案。通过为每日记录排序并减去天数,生成恒定日期分组,从而利用 COUNT 和 HAVING 筛选出满足连续天数要求的用户及起止时间。
本文详解Python与Matlab数据互通技巧,重点介绍SciPy库中scipy.io模块的savemat函数用法。同时系统梳理SciPy核心子模块,包括integrate数值积分、optimize优化器、interpolate插值及linalg线性代数模块,提供具体代码示例与参数说明,助力Python科学计算与数据分析。
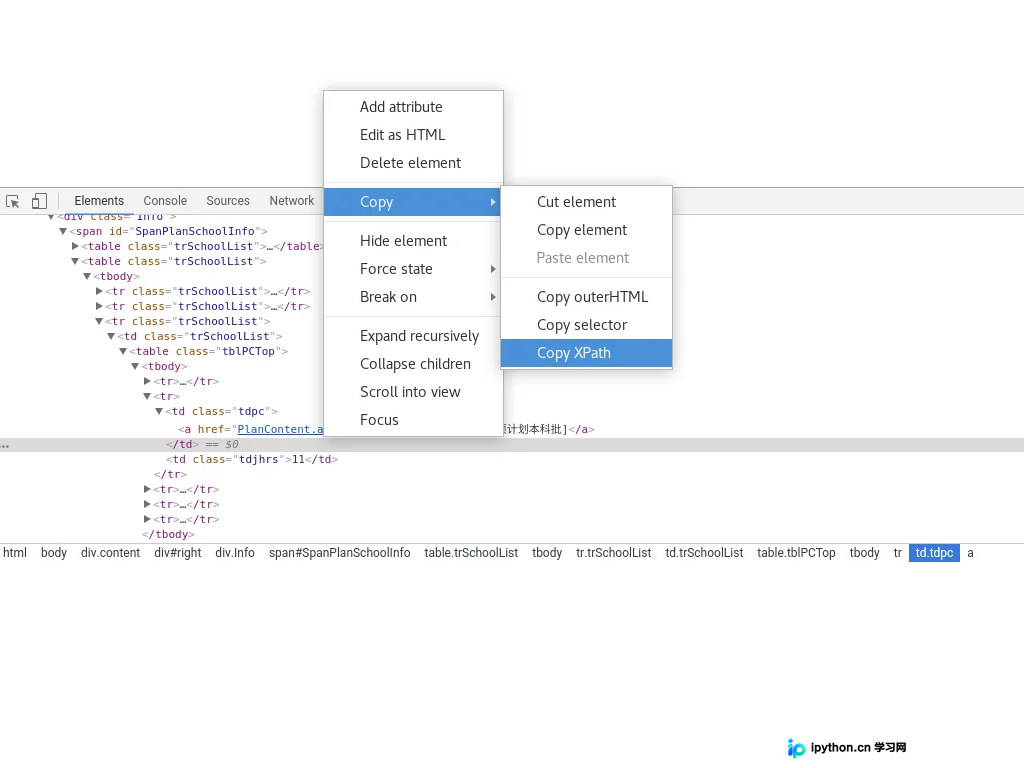
本文分析Scrapy中使用Chrome开发者工具生成的XPath在爬虫中失效的问题。根本原因在于浏览器自动插入tbody标签,而原始HTML结构中可能不存在该标签。通过对比Chrome生成的含tbody XPath与Scrapy实际解析结果,发现需手动移除xpath中的tbody节点。文章提供了使用scrapy shell逐步定位问题的方法,并给出修正后的正确XPath示例,帮助开发者避免此类常见坑点。
本文详细介绍如何使用Scrapy框架将爬取数据导出为Excel格式。通过定义Item实体类、配置CsvItemExporter以及注册Pipeline,实现数据的结构化存储。文章涵盖环境要求、核心代码实现及爬虫运行步骤,帮助开发者快速掌握Scrapy数据导出功能。
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
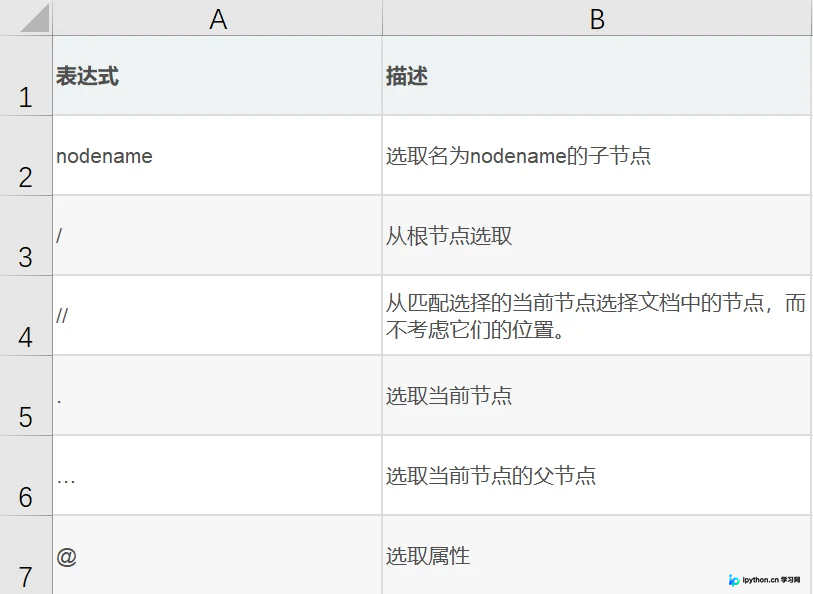
本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
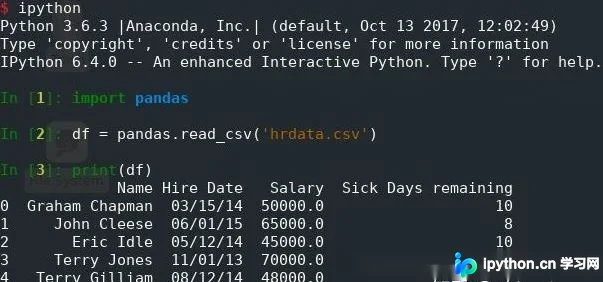
本文详细介绍如何使用 Python Pandas 库高效读取和写入 CSV 文件。涵盖基础读取方法、索引设置、日期解析、列名自定义以及数据导出等核心操作,通过具体代码示例展示 read_csv 和 to_csv 函数的关键参数用法,帮助开发者快速掌握 CSV 数据处理技巧。
本文详解Python中IndexError: list index out of range错误的成因与解决方案。当XPath定位不到数据导致列表为空时,直接索引会触发此异常。通过引入try-except异常捕获机制,可将未定位到的元素赋值为None,从而避免程序崩溃,确保爬虫脚本稳定运行。
本文分析Python爬虫中使用多进程生产者-消费者模式时,因未正确调用join()导致消费者进程过早终止的问题。通过对比错误与正确的代码结构,指出必须等待生产者完成并调用消费者join(),同时需向队列发送结束标志,确保所有任务被处理完毕。
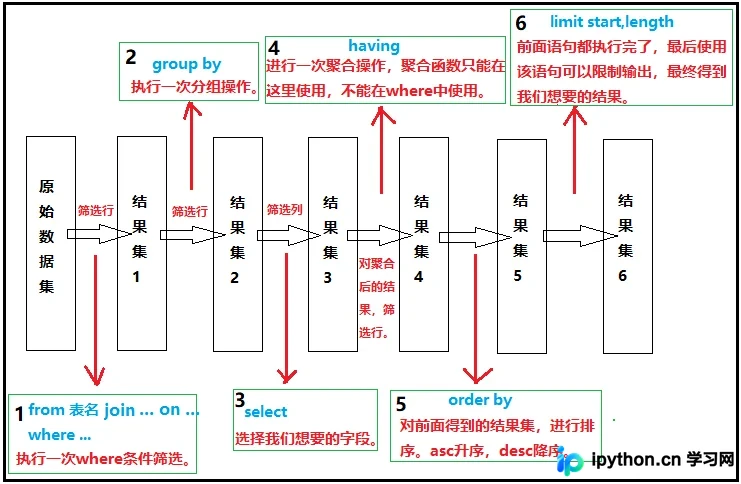
本文详细解析MySQL SQL查询语句的书写顺序与底层执行顺序。通过对比 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY 和 LIMIT 关键字,阐明两者为何不同及其背后的逻辑。同时重点探讨 HAVING 与 SELECT 的执行先后争议及优化建议,帮助开发者写出更高效的SQL代码。
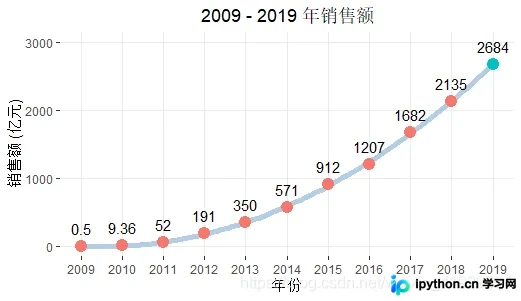
针对淘宝历年双十一销售额数据的拟合争议,通过R语言的ggplot2包对2009至2019年的销售额及增长率数据进行可视化重构。利用双Y轴设计清晰展示销售额的总量增长与增长率的变化趋势,验证数据分布的合理性并直观呈现经济学规律。
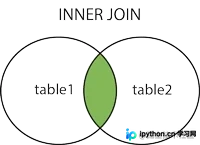
本文详细解析MySQL中的表联结与集合操作。涵盖CROSS、INNER及LEFT/RIGHT OUTER JOIN的原理与示例,讲解UNION与UNION ALL合并结果集的规则与差异,通过具体SQL代码演示如何在开发中正确应用这些核心查询语法以获取精准数据。