iPython搜索

数据分析实战 搜索结果

共找到 120 个相关内容

Python 探索性数据分析(EDA)实战:从描述统计到相关性分析

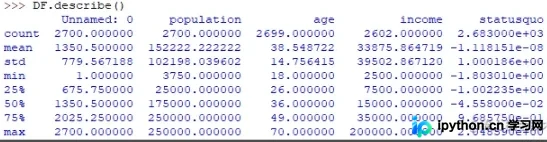
本文详解 Python 中的探索性数据分析(EDA)流程。通过 Pandas 的 describe() 和 value_counts() 快速获取数据分布与分类计数,利用 matplotlib 绘制箱线图识别异常值。进一步使用 groupby 进行分组统计,结合 scipy 的 f_oneway() 执行 ANOVA 方差分析,并通过 Pearson 相关系数评估变量间的相关性,帮助数据分析师深入理解数据特征与变量关系。

Python 探索性数据分析(EDA)实战:从描述统计到相关性分析

SQL实战:从数据查询到业务分析

统计每月销售额、找出重复记录、关联用户与订单,SQL能把业务问题转化为查询结果。通过实际案例掌握筛选、分组、多表连接与窗口函数,并学习排查慢查询。

SQL实战:从数据查询到业务分析

Python数据处理实战:Pandas移除列、统计词数与频次分析

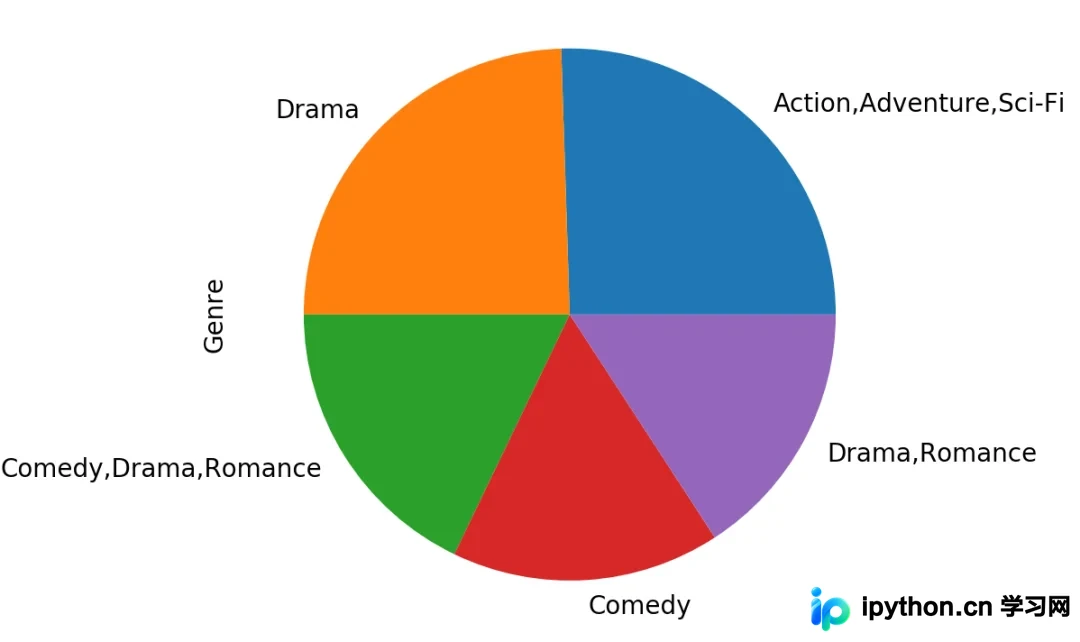
本文介绍Python中Pandas库的三个实用数据处理技巧。首先演示如何使用pop方法高效移除指定列并验证结果;其次讲解利用str.count方法统计标题中单词数量的方法;最后通过value_counts和matplotlib展示电影Genre的频次统计及Top5可视化分析,帮助开发者快速掌握数据清洗与基础统计操作。

Python数据处理实战:Pandas移除列、统计词数与频次分析

Vaex:秒开100GB+数据集的Python高性能分析库

本文介绍Python开源库Vaex,它利用内存映射和延迟计算技术,使笔记本电脑也能秒开100GB以上的数据集。通过纽约出租车数据的实战案例,展示了Vaex在数据清洗、统计分析及可视化方面的卓越性能,无需分布式集群即可高效处理十亿级数据。

Vaex:秒开100GB+数据集的Python高性能分析库

Python数据分析之NumPy常用函数使用详解

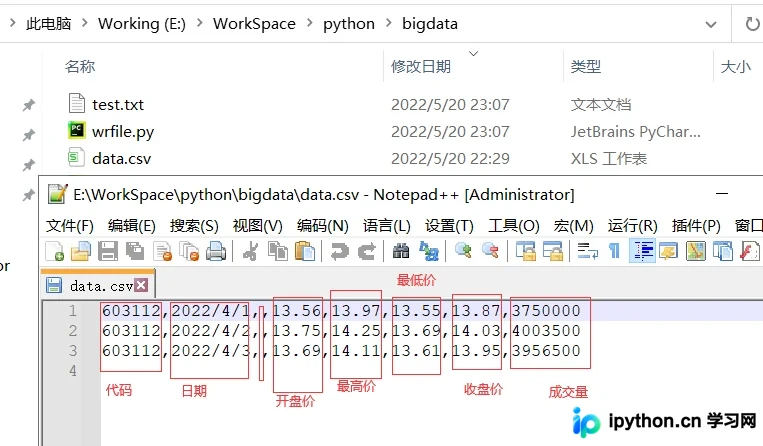
本文以历史股价分析为例,详细讲解NumPy核心函数。涵盖loadtxt与savetxt的文件读写、usecols参数筛选、average加权与算术平均、diff计算收益率、log对数收益及波动率公式。通过实战代码演示日期处理、where筛选、std标准差及极值统计,帮助掌握NumPy在金融数据分析中的关键应用。

Python数据分析之NumPy常用函数使用详解

JS逆向:破解 webpack 打包站点及 JS 代码扣取实战

本文详解如何识别并破解前端 webpack 打包的加密 JS 代码。通过分析典型模块执行逻辑,实战演示如何通过浏览器开发者工具定位关键函数(如 encode),构建局部运行环境,剥离核心加解密代码到本地 JavaScript 文件中独立执行,从而实现数据抓取中的算法复现。

JS逆向:破解 webpack 打包站点及 JS 代码扣取实战

MySQL连接查询详解:自连接、内连接与左右外连接实战

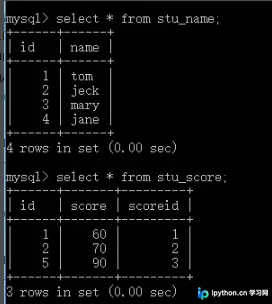
本文详细解析MySQL中常用的五种连接查询方式,包括自连接、内连接、左连接、右连接及外连接的概念与区别。通过创建测试表和插入示例数据,结合具体SQL语句和结果截图,直观展示各类型连接的执行逻辑与数据返回特征,帮助开发者快速掌握关系型数据库的多表关联技巧。

MySQL连接查询详解:自连接、内连接与左右外连接实战

MySQL 10大经典优化场景实战与排查指南

本文深入解析 MySQL 性能优化的十大核心场景,涵盖最左匹配原则、隐式转换陷阱、大分页延迟关联、IN 查询临界值及范围查询阻断等常见问题。通过 explain、show profile 和 optimizer_trace 工具定位执行计划瓶颈,提供从索引设计到 SQL 重构的实操方案,帮助开发者有效解决慢查询与索引失效问题。

MySQL 10大经典优化场景实战与排查指南

Scrapy中XPath匹配失效:tbody标签导致的常见陷阱与修复

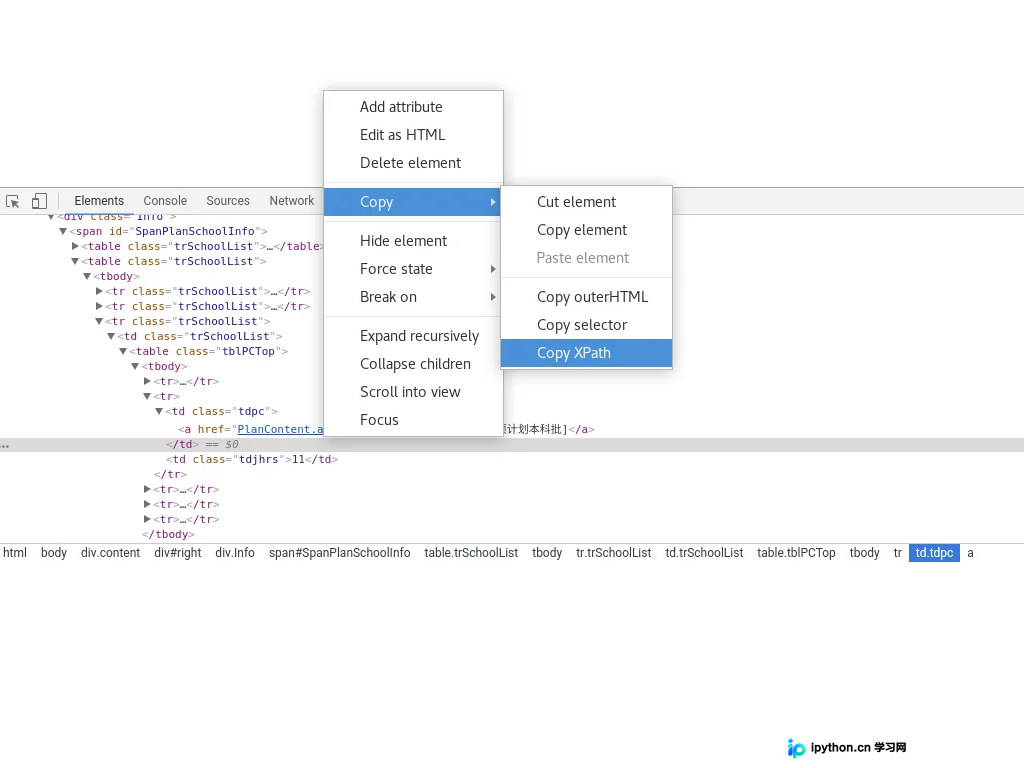
本文分析Scrapy中使用Chrome开发者工具生成的XPath在爬虫中失效的问题。根本原因在于浏览器自动插入tbody标签,而原始HTML结构中可能不存在该标签。通过对比Chrome生成的含tbody XPath与Scrapy实际解析结果,发现需手动移除xpath中的tbody节点。文章提供了使用scrapy shell逐步定位问题的方法,并给出修正后的正确XPath示例,帮助开发者避免此类常见坑点。

Scrapy中XPath匹配失效:tbody标签导致的常见陷阱与修复