

Python使用pdfkit将HTML转换为PDF的操作指南
本文详细介绍Python中pdfkit库的使用,该库封装了wkhtmltopdf工具实现HTML到PDF的转换。内容涵盖pdfkit与wkhtmltopdf的安装步骤(Windows、Ubuntu、CentOS),代码示例演示如何通过URL或字符串生成PDF文件,并重点解决“No wkhtmltopdf executable found”报错,提供路径配置与环境变量设置方案。
2026-10-16
0
本文详细介绍Python中pdfkit库的使用,该库封装了wkhtmltopdf工具实现HTML到PDF的转换。内容涵盖pdfkit与wkhtmltopdf的安装步骤(Windows、Ubuntu、CentOS),代码示例演示如何通过URL或字符串生成PDF文件,并重点解决“No wkhtmltopdf executable found”报错,提供路径配置与环境变量设置方案。
本文深入解析Python中三种主流字符串格式化方式:传统的%s操作符、功能强大的format()方法以及高效的f-string。通过具体代码示例,详细讲解整数、浮点数、字符串及对齐补齐等格式化规则,对比各方法的适用场景与注意事项,帮助开发者选择最适合的格式化方案。
本文深入解析Python中列表、字符串和元组的索引与切片机制。详细讲解索引从0开始的规则、切片左含右不含的特性,以及如何通过index()查找元素。重点对比pop()与del()在删除元素时的返回值差异及边界报错处理,并探讨元组索引的特殊性,帮助开发者掌握高效的数据访问技巧。
本文详细介绍如何在Python中利用Selenium库搭建代理IP池,以规避网站访问限制。内容涵盖Selenium及浏览器驱动的下载安装、环境变量配置,以及通过Chrome Options添加随机代理IP的核心代码实现。文中提供了完整的代码示例和注意事项,帮助开发者高效管理多个代理IP,降低被封禁风险。
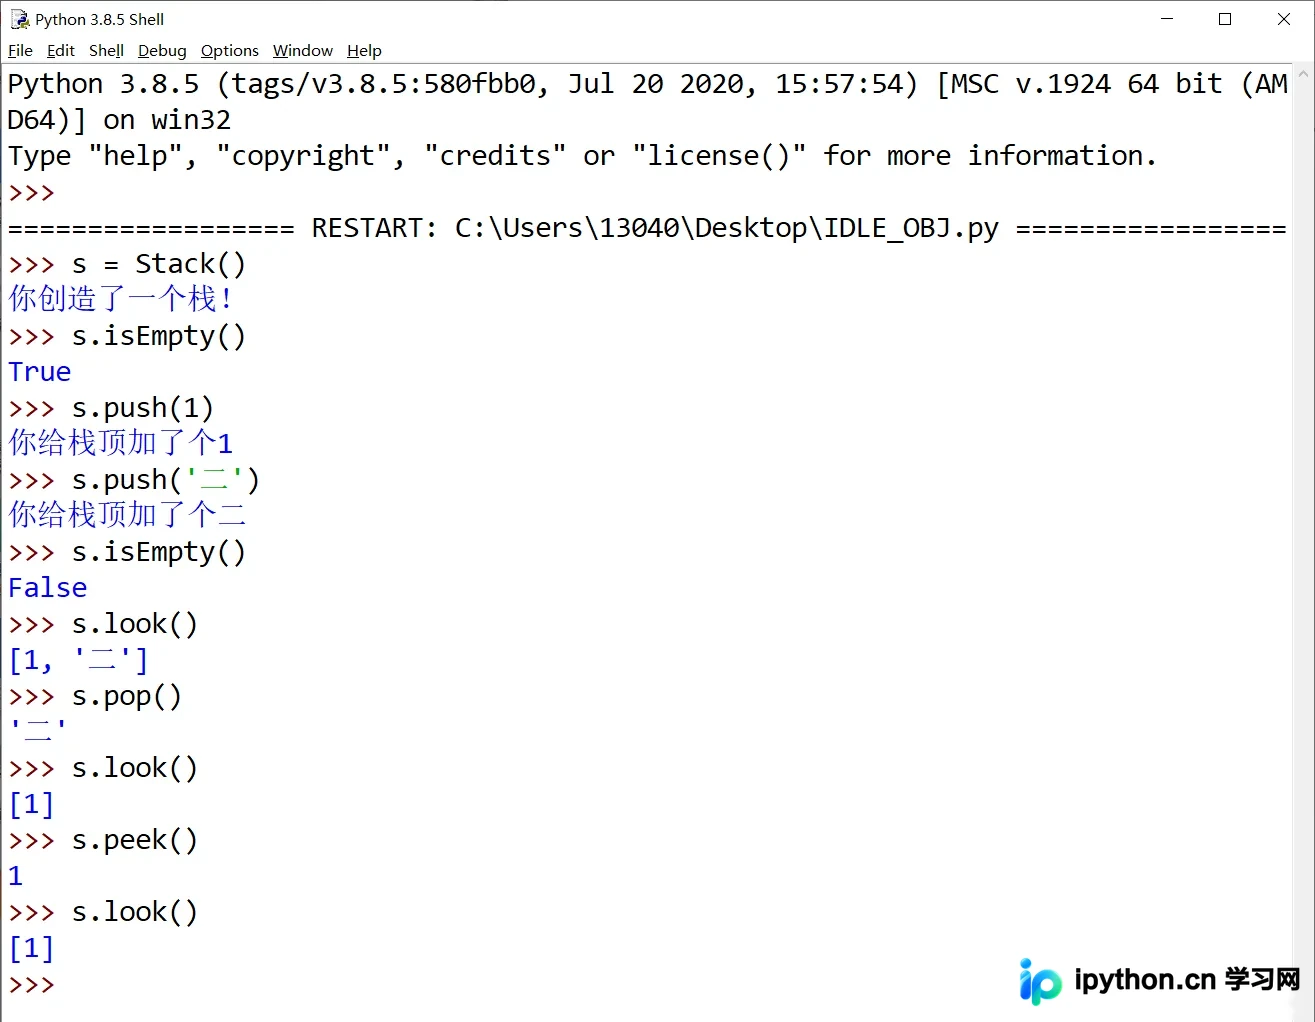
本文深入解析Python中栈(Stack)这一基础数据结构。栈遵循后进先出(LIFO)原则,支持入栈、出栈、查看栈顶等核心操作。文章通过Python类封装展示两种基于列表的实现方案:以列表尾部为栈顶的O(1)高效实现,以及以头部为栈顶的O(n)低效实现,并对比分析其性能差异,帮助开发者选择最优存储策略。
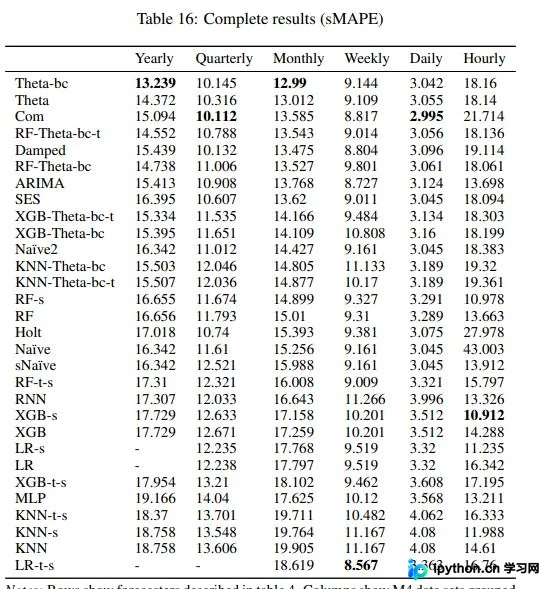
本文介绍如何使用Python中的LazyProphet库结合LightGBM进行高效的时间序列预测。通过特征工程如傅里叶基函数和滞后值,该模型在M4数据集上超越了传统树模型基准,且无需复杂调参即可实现快速建模与预测,适合高频大数据场景。
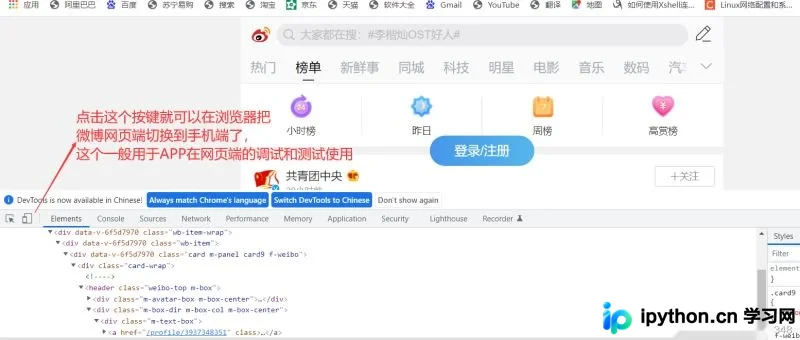
本文详解如何利用Python爬取微博移动端动态图片。针对PC端反爬限制,通过解析m.weibo.cn接口获取用户UID及动态列表,提取图片ID后拼接完整链接进行下载。文中包含参数转码、UID获取及循环下载的具体代码实现与步骤说明。
本文详解Python中folium库的使用,从基础安装到Map对象参数解析,涵盖location、zoom_start等核心配置。重点演示如何调用高德、智图GeoQ及腾讯地图等第三方瓦片服务,实现中英文、卫星影像及矢量注记等多种地图样式的本地化部署与交互操作。
本文详细介绍Python中matplotlib库支持的多种颜色表示格式,包括RGB/RGBA元组、Hex字符串、灰度值、单字母缩写、CSS4命名颜色、xkcd颜色及Cn和tab格式。同时解析如何通过matplotlib.colors模块调用BASE_COLORS、TABLEAU_COLORS、CSS4_COLORS和XKCD_COLORS四类内置颜色,并展示具体色号与色图示例,帮助开发者灵活进行图表配色。
本文系统介绍Python中字符串(str)的核心操作。涵盖单双三引号创建规则、下标与切片语法(含步长)、%与format及f-string格式化技巧,以及find、replace、split、startswith等常用内置方法,帮助开发者掌握字符串处理基础。
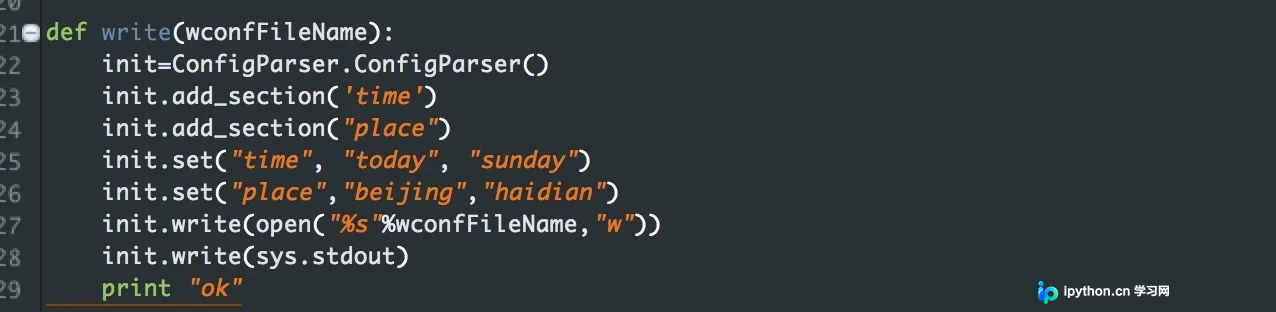
本文详细讲解Python ConfigParser库的基本用法,包括write和read方法的操作流程。重点分析了在Apache服务器环境下因相对路径识别问题导致的NoSectionError错误,并提供使用绝对路径读取配置文件的解决方案,帮助开发者避免常见配置读取陷阱。
本文详解Python导入自定义模块时常见的报错问题及解决方法。针对同目录与跨目录两种场景,分别介绍了在PyCharm中设置Sources Root、通过cmd命令行执行时的路径差异。重点讲解了将模块拷贝至site-packages、创建.pth文件添加搜索路径以及设置根目录等有效方案,确保代码在IDE和命令行环境中均能正常运行。
