

Python使用ElementTree生成XML文件的完整示例
本文介绍如何利用Python标准库xml.etree.ElementTree模块创建XML文件。通过定义根节点、子节点及属性,并设置文本内容,最终写入指定文件。文中附带完整代码及在线XML处理工具推荐,适用于需要程序化生成结构化数据场景。
2026-10-13
5

本文介绍如何利用Python标准库xml.etree.ElementTree模块创建XML文件。通过定义根节点、子节点及属性,并设置文本内容,最终写入指定文件。文中附带完整代码及在线XML处理工具推荐,适用于需要程序化生成结构化数据场景。
本文介绍利用Python的gevent库实现MySQL数据库表数据转换为XML格式的方法。针对文件I/O阻塞问题,通过多任务并发处理提升效率。文中对比了两种list_to_xml函数的实现,后者通过直接写入文件流和特殊字符转义,使处理速度提升上百倍,适用于需要与Navicat导出格式保持一致的场景。
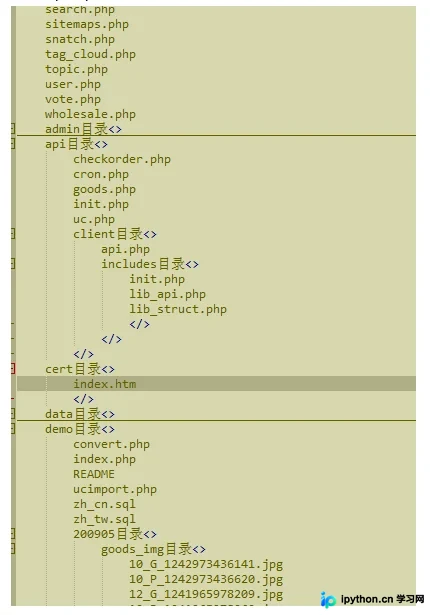
本文介绍使用Python脚本递归遍历指定目录下的所有文件和子文件夹,并将结果保存为XML格式文件的方法。通过示例代码展示如何生成文件树结构,便于使用Notepad++等工具进行查看和折叠操作,适用于需要快速了解项目文件结构的场景。
本文详解Python中ElementTree库的使用,涵盖从引入Element、ElementTree及SubElement类开始,演示如何读取XML文件并获取根节点。内容包含查找子节点、插入新节点(两种方法对比)、操作属性以及使用indent函数美化XML输出的完整代码示例,帮助开发者高效处理XML数据。
本文介绍5个常被忽略但极具实用价值的Python技巧。涵盖使用字典和集合推导式简化代码、利用Counter高效统计元素、通过indent参数美化JSON输出、使用SimpleXMLRPCServer快速搭建内部RPC服务,以及评估开源库质量的五大标准。这些技巧无需额外依赖,能显著提升日常开发效率与代码可读性。
本文介绍如何使用Python的xml.etree.ElementTree库将字典转换为XML格式。通过dict_to_xml函数构建Element对象,利用tostring()生成字节串,并演示如何添加属性。重点讨论了手动拼接字符串与Element对象的区别,强调Element能自动处理特殊字符转义,推荐使用OrderedDict保持顺序,并提供了xml.sax.saxutils进行手动转义的备选方案。
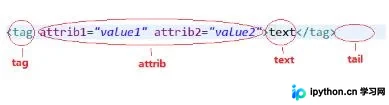
Python 的 ElementTree 模块生成的 XML 默认紧凑无缩进,难以阅读。本文介绍如何遍历 Element 对象的 tag、attrib、text 和 tail 属性,通过递归修改 text 和 tail 添加换行与缩进,实现 XML 文档的美化输出,并讨论了 Windows 换行符兼容性及 XML 与 JSON 的使用场景差异。
本文介绍利用Python标准库xml.dom.minidom解析XML文件的方法。通过读取包含省份和城市信息的XML文档,演示如何遍历节点并提取属性值,将结构化数据转换为Python列表对象。该方法适用于小文件读取,可作为JSON之外的数据交换方案,避免数据库查询开销。
本文详细介绍在Python中处理HTML转义字符的五种方法。涵盖Python2的HTMLParser模块、Python3中html.parser的迁移、Python3.4新增的html.unescape推荐用法,以及xml.sax模块的支持方案。文章对比了各版本的兼容性与废弃状态,帮助开发者选择合适的数据清洗工具。
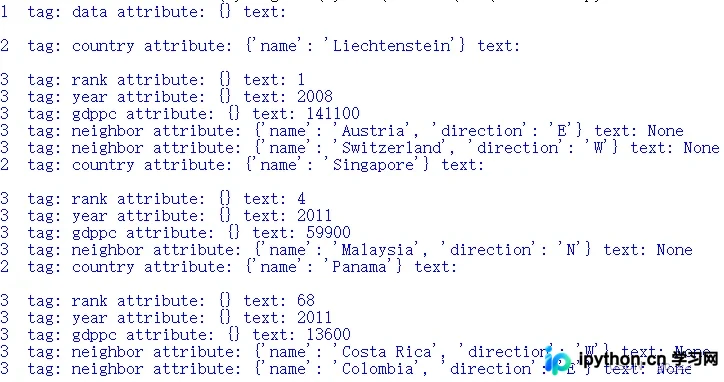
详细介绍Python中使用内置标准库读取和编写XML配置文件的核心方法。通过xml.etree.ElementTree与xml.dom.minidom两大模块的代码示例,涵盖文件解析、节点遍历、属性读取、动态构建树结构及数据持久化的完整操作流程,并对比两者的性能特点与适用场景。
本文详细介绍基于Python调用Nmap命令行工具,结合标准库解析扫描结果并将其持久化至MySQL数据库的完整流程。方案涵盖从接口获取IP网段、发起端口探测、过滤开放服务到数据入库的全链路操作,适用于企业内网或测试环境的资产盘点与基础安全检查。
Python内置的SAX解析器基于事件驱动架构,以流式方式读取XML数据,有效避免DOM全量载入引发的内存瓶颈。通过继承ContentHandler基类并重写核心回调函数,可实现超大规模文件的轻量级内容提取。下文详解环境配置、代码编写步骤及生产环境避坑指南。