Python使用xmltodict实现XML与Dict格式互转
本文介绍在Python接口自动化测试中,如何利用xmltodict库将XML数据转换为字典格式。通过安装库、处理节点属性及文本内容,并提供封装好的转换函数,解决XML模板提取与复用的问题,适用于APP接口调试场景。
2026-10-13
2

本文介绍在Python接口自动化测试中,如何利用xmltodict库将XML数据转换为字典格式。通过安装库、处理节点属性及文本内容,并提供封装好的转换函数,解决XML模板提取与复用的问题,适用于APP接口调试场景。
本文详细介绍使用Python从XML文件中提取链接的两种方法。第一种利用urllib和正则表达式匹配URL,适用于简单结构;第二种通过xml.dom.minidom遍历节点,适合复杂XML文档。代码包含完整示例,帮助开发者快速实现数据抓取与解析功能。
本文介绍在Python中使用Socket进行网络通信时,如何采用先读取报文长度、再读取具体报文内容的处理模式。通过示例代码展示了连接服务器、发送XML数据以及接收响应并解析长度的完整流程,适用于需要处理定长或变长报文的应用场景。
本文介绍如何使用Python脚本批量处理labelImg生成的XML标注文件。通过解析ElementTree,程序可自动过滤掉不需要的目标类别(如仅保留people和cat),并强制将所有保留标签的名称统一转换为小写,以适配py-faster-rcnn等对标签大小写敏感的训练框架。该方法避免了重新打标的繁琐工作,高效完成数据预处理。
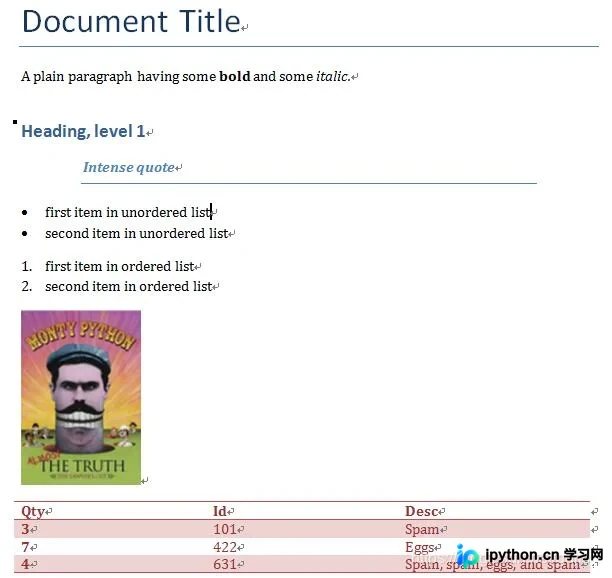
本文介绍如何使用python-docx库在Python中创建和编辑Microsoft Word文档。内容涵盖库的安装方法、.docx文件格式原理、文档创建(包括标题、段落、列表、图片及表格)以及文档读取操作。通过具体代码示例,展示如何生成包含格式文本的demo.docx文件并提取其内容,适用于需要自动化处理Word文档的开发者。
本文详解使用Python提取Bilibili视频弹幕的完整流程。核心在于通过手机User-Agent请求视频页面,利用正则表达式从响应JavaScript中提取弹幕接口所需的cid参数,拼接生成以.xml结尾的弹幕URL。随后发起二次请求获取XML数据,借助lxml库解析并提取文本内容,最终保存至本地文件。

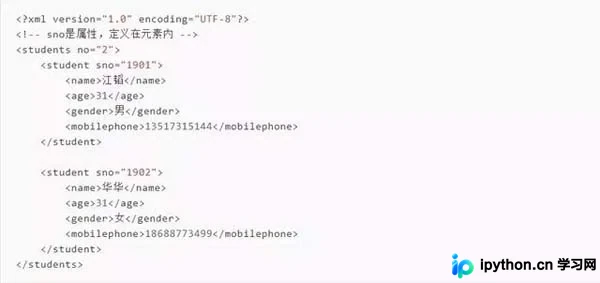
本文深入解析XML属性的定义、引用规则及使用场景。虽然HTML中属性常见,但在XML设计中应严格区分元数据(属性)与业务数据(子元素)。文章详细说明了属性值引号的使用例外,并列举了为何应避免滥用属性的五大理由,最后通过ID标识的示例展示了标准用法,帮助开发者写出更健壮的结构化文档。
本文详解Python中CSV、JSON和XML三种主流数据格式的读写方法。通过内置csv、json模块及ElementTree处理XML,结合pandas库实现高效操作。重点演示如何将数据在列表、字典、DataFrame及XML之间相互转换,涵盖从基础读写到高级格式互转的完整流程,助开发者轻松应对数据存储与交换需求。
本文深入解析XML文档的两大核心标准:“结构良好”与“有效”。通过对比代码示例,阐明仅符合语法规范即为结构良好,而必须通过DTD或XML Schema验证才算有效。同时介绍W3C对错误处理的严格原则,帮助开发者确保数据交换的稳定性。
本文深入讲解SQL Server解析XML数据的五种核心方法(value、exist、nodes、query、modify)。通过T-SQL代码示例,演示如何使用XQuery表达式提取节点值、筛选属性、遍历子元素及修改XML内容,适用于需要高效处理结构化文本数据的技术场景。
本文详细介绍如何使用Python内置的ElementTree库处理XML文件。通过导入模块、获取根节点、使用find和findall方法提取子节点及遍历元素等步骤,展示完整的XML数据读取流程。文末附带UI库XML解析的编程练习题,帮助读者巩固XML节点操作与类设计能力。
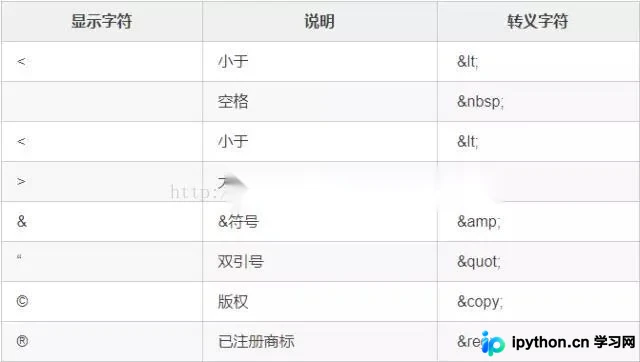
本文详解Python中处理HTML转义字符反转义的几种方法。重点介绍Python 3.4+推荐的html.unescape函数,以及Python 2和3中HTMLParser模块的使用差异。同时提供xml.sax.saxutils.unescape的替代方案,帮助开发者在不同Python版本中正确解析HTML实体。