

Python读写XML配置文件的完整指南:ElementTree与Minidom实战

详细介绍Python中使用内置标准库读取和编写XML配置文件的核心方法。通过xml.etree.ElementTree与xml.dom.minidom两大模块的代码示例,涵盖文件解析、节点遍历、属性读取、动态构建树结构及数据持久化的完整操作流程,并对比两者的性能特点与适用场景。
XML配置文件读写核心方案概述
在Python项目中,配置文件常采用XML格式存储层级化参数。Python内置了xml.etree.ElementTree和xml.dom.minidom两个模块来处理XML数据。前者基于轻量级事件驱动与DOM结合的理念,API简洁高效,适合绝大多数常规读写场景;后者遵循W3C DOM规范,功能全面但实现较重,在处理大型文档时可能占用较多内存。若无特殊兼容需求,推荐使用ElementTree模块。
使用 xml.etree.ElementTree 读取与生成数据
第1步:准备测试XML数据
以下示例包含国家、排名、年份等嵌套字段,用于演示标签提取与属性解析:
<?xml version="1.0"?>
<data>
    <country name="Liechtenstein">
        <rank>1</rank>
        <year>2008</year>
        <gdppc>141100</gdppc>
        <neighbor name="Austria" direction="E"/>
        <neighbor name="Switzerland" direction="W"/>
    </country>
    <country name="Singapore">
        <rank>4</rank>
        <year>2011</year>
        <gdppc>59900</gdppc>
        <neighbor name="Malaysia" direction="N"/>
    </country>
</data>
第2步:解析并遍历XML结构
导入ET后,可通过parse()加载文件返回实例,调用getroot()获取根节点。常用属性包括.tag(标签名)、.attrib(键值对字典)和.text(文本内容)。编写递归函数可直观打印整个文档树:
import xml.etree.ElementTree as ET

def ShowSubElement(curElement, level):
    print(level, ' tag:', curElement.tag, 'attribute:', curElement.attrib, 'text:', curElement.text)
    for child in curElement:
        ShowSubElement(child, level + 1)

tree = ET.parse('test.xml')
level = 1
root = tree.getroot()
ShowSubElement(root, level)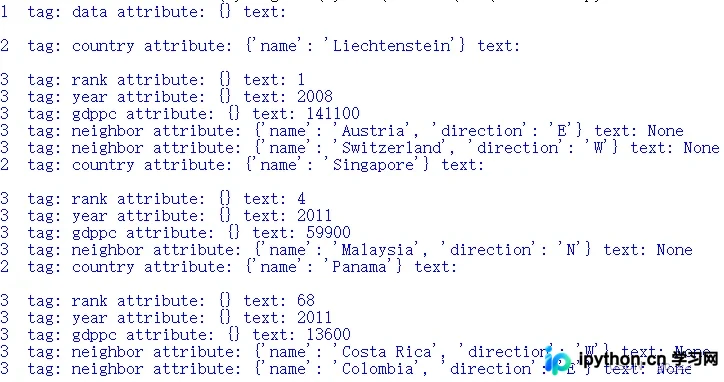
第3步:动态构建与写入XML文件
创建新XML需实例化ET.Element('root')作为根节点,使用.set()添加属性,.append()或ET.SubElement()插入子节点。组装完成后调用tree.write()保存。注意:写入前请备份原文件,避免意外覆盖重要配置。
import xml.etree.ElementTree as ET

root = ET.Element('root')
root.set('ver', '2.0')

classA = ET.Element('classA')
root.append(classA)
classA.set("master", "张三")
classA.set("grade", "一年级")

studentA = ET.Element('studentA')
classA.append(studentA)
studentA.text = '小米'

classB = ET.SubElement(root, 'classB')
classB.set("master", "李四")
classB.set("grade", "三年级")

studentB = ET.SubElement(classB, 'studentB')
studentB.text = '小明'

tree = ET.ElementTree(root)
tree.write("writetest.xml")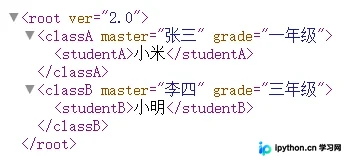
使用 xml.dom.minidom 处理XML文档
第1步:加载文档与递归解析节点
Minidom采用严格树形节点模型。解析时需导入parse方法,通过document.documentElement定位根元素。获取信息依赖.nodeName(节点类型或名称)、.nodeValue(文本值)及.attributes。由于纯文本也会被包装为#text节点,遍历时需注意过滤非标签节点:
from xml.dom.minidom import parse

def ShowSubNode(curNode):
    print('节点:', curNode.nodeName, ":", curNode.nodeValue)
    if curNode.nodeName == '#text':
        return
    if curNode.hasAttributes:
        for attr in curNode.attributes.values():
            print('属性:', attr.name, ':', attr.value)
    if curNode.hasChildNodes:
        for child in curNode.childNodes:
            ShowSubNode(child)

doc = parse('test.xml')
root = doc.documentElement
ShowSubNode(root)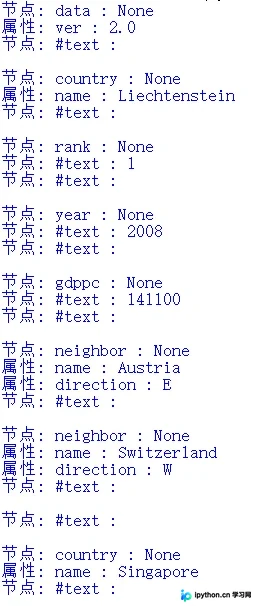
第2步:创建节点与格式化输出文件
写入流程相对繁琐,需依次调用Document()初始化对象,使用createElement()创建元素节点,通过setAttribute()绑定属性,并用createTextNode()包裹文本。最终利用writexml()导出,指定缩进与换行符以提升可读性:
import xml.dom.minidom

doc = xml.dom.minidom.Document()

root = doc.createElement("root")
root.setAttribute('ver', '2.0')
doc.appendChild(root)

classA = doc.createElement('classA')
root.appendChild(classA)
classA.setAttribute("master", "张三")
classA.setAttribute("grade", "一年级")

studentA = doc.createElement('studentA')
classA.appendChild(studentA)
studentA.appendChild(doc.createTextNode('小米'))

classB = doc.createElement('classB')
root.appendChild(classB)
classB.setAttribute("master", "李四")
classB.setAttribute("grade", "三年级")

studentB = doc.createElement('studentB')
classB.appendChild(studentB)
studentB.appendChild(doc.createTextNode('小明'))

with open("writetest1.xml", "w", encoding='utf-8') as f:
    doc.writexml(f, indent='\t', addindent='\t', newl='\n', encoding="utf-8")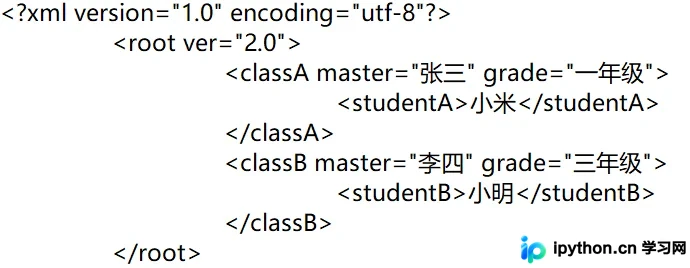
方案对比与选择建议
两者均属于Python标准库,无需额外安装。ElementTree API更贴近直觉,属性访问与字符串处理直接,性能开销更低,是日常脚本与自动化运维的首选;Minidom严格遵循DOM标准,适合需要深度操作节点树、进行复杂校验或迁移传统DOM逻辑的场景。实际工作中遇到编码乱码时,确保文件读写两端统一指定encoding="utf-8"即可解决多数问题。
以上就是Python读写XML配置文件的详细内容,更多关于Python基础语法与数据处理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









