

XML转HTML实战:通过XSLT实现数据与显示分离
XML擅长数据存储但缺乏显示能力。本文详解利用XSLT(XSL Transformation)技术将原始XML数据转换为HTML页面的完整流程。通过DOM解析构建结果树,并应用格式化规则,实现数据与显示的完美分离,让杂乱的数据瞬间变得美观易读。
2026-10-16
6

XML擅长数据存储但缺乏显示能力。本文详解利用XSLT(XSL Transformation)技术将原始XML数据转换为HTML页面的完整流程。通过DOM解析构建结果树,并应用格式化规则,实现数据与显示的完美分离,让杂乱的数据瞬间变得美观易读。
本文介绍如何在客户端使用 JavaScript 实现 XSL(可扩展样式表语言)将 XML 转换为 HTML。通过构建 Microsoft.XMLDOM 对象分别加载 XML 和 XSL 文件,利用 transformNode 方法进行本地转换并输出结果。该方法适用于支持 IE ActiveX 环境的浏览器,解决了部分不支持原生 XML 解析的显示问题。
XSL(可扩展样式表语言)是用于控制XML文档显示的核心技术。本文介绍XSL的基本概念,解释其由XSLT和XSL-FO两部分组成,分别负责数据转换与格式化。由于XML缺乏固定标签,浏览器无法直接渲染,通过XSL可将XML转换为HTML或进行高级排版,从而解决数据显示问题。
本文详细介绍 C# 中处理 XML 数据的两种核心类:XmlDocument 和 XDocument。通过构建 DOM 对象,演示如何声明版本、创建根节点与子元素、设置属性并保存为文件,以及如何加载并解析已有 XML 内容。代码涵盖写入与读取的完整流程,适用于需要配置管理或数据交换的场景。
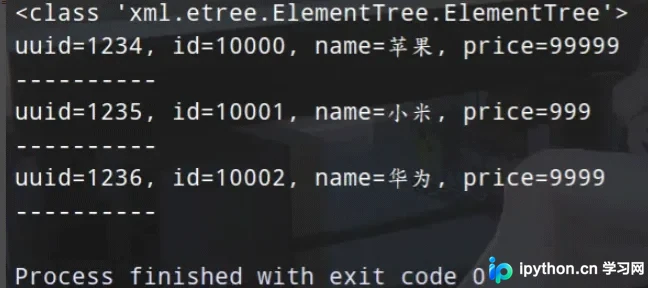
本文通过Python面试题案例,演示如何使用xml.etree.ElementTree模块读取XML文件。重点讲解parse函数加载文档及iterfind方法遍历子节点,结合findtext与get方法获取节点文本及属性值,实现数据的高效提取与分析。
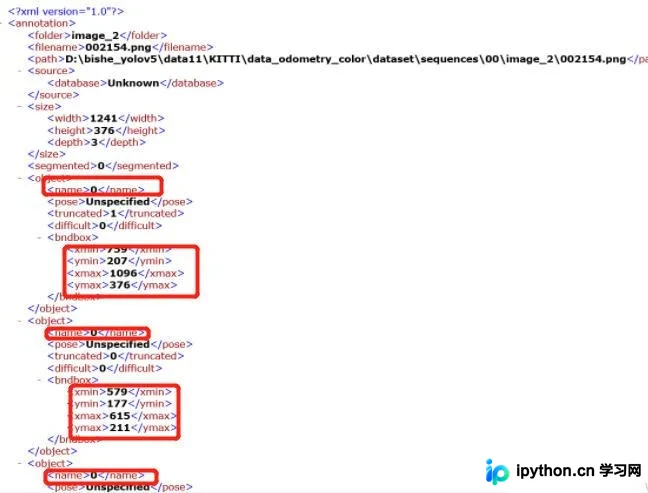
本文介绍如何利用Python将VOC数据集的XML标注文件转换为YOLO模型所需的TXT格式。通过解析XML树结构提取边界框坐标,应用归一化公式计算中心点与宽高,实现自动化批量转换,解决手动处理效率低的问题。
本文介绍如何利用Python内置的xml.etree模块,将XML格式数据高效转换为TXT文件。重点解析批量处理包含多个XML文件的文件夹场景,通过遍历目录、解析树结构并提取指定标签文本,实现自动化数据提取与格式转换,适用于数据分析前的预处理环节。
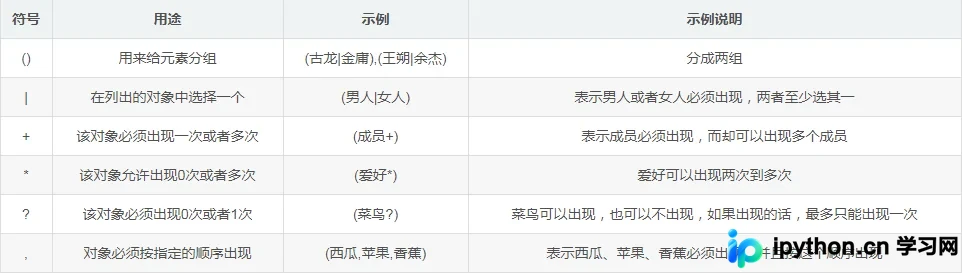
本文详细介绍在Python生成XML文件时如何正确声明和引用DTD文档。内容涵盖内部DTD与外部DTD(SYSTEM与PUBLIC)的区别、DTD基本语法如ELEMENT定义、元素组合类型修饰符以及属性类型的五种分类与特点,帮助开发者规范XML结构。
本文系统讲解Python读取XML文件的方法,涵盖XML基础概念、结构特征及两种主流解析库的使用。通过xml.dom.minidom模块演示节点属性获取、子标签遍历及文本提取,并结合ElementTree模块介绍批量遍历技巧,帮助开发者掌握XML数据处理的实战技能。
本文介绍Python中处理HTML和XML字符串的常用方法。通过html.escape()函数转义特殊字符,利用encode()方法处理非ASCII编码实体,以及使用HTMLParser和xml.sax.saxutils进行实体解码。建议优先使用解析器自动处理,确保文本安全与格式正确。
本文详细介绍Python中解析XML文件的三种主要方式:SAX、DOM和ElementTree。重点讲解基于事件驱动的SAX解析器及其ContentHandler回调机制,以及将XML加载为内存树结构的DOM解析方法。通过具体代码示例,展示如何利用xml.sax和xml.dom.minidom模块处理大型文件或特定数据提取,帮助开发者根据场景选择合适方案。
本文介绍利用Python内置xml.dom模块生成XML文件的具体方法,通过minidom.Document类构建节点并写入文件。同时对比了Python中常见的三种XML解析方式:xml.dom、xml.sax和xml.etree.ElementTree,分析各自在API便捷性、处理速度及内存占用方面的差异,帮助开发者根据需求选择合适的解析库。