

Python中XML与JSON数据转换全指南
本文详细讲解Python中XML与字典、JSON及类实例之间的转换方法。涵盖基于DOM和ElementTree的XML读写,以及利用dicttoxml和xmltodict模块实现字典与XML的双向转换。同时介绍JSON与字典、类实例的相互转换技巧,包括回调函数的使用,并提供XML与JSON互转的完整流程示例。
2026-10-15
5

本文详细讲解Python中XML与字典、JSON及类实例之间的转换方法。涵盖基于DOM和ElementTree的XML读写,以及利用dicttoxml和xmltodict模块实现字典与XML的双向转换。同时介绍JSON与字典、类实例的相互转换技巧,包括回调函数的使用,并提供XML与JSON互转的完整流程示例。
本文介绍如何使用Python标准库xml.etree.ElementTree修改XML文件中的特定节点数据。通过解析XML文档、定位目标节点并更新文本内容,最后保存文件,实现高效的数据处理。
本文详解Python中xml.etree.ElementTree模块的核心用法,涵盖XML文件的读取、节点查找与遍历、属性与文本修改、文档构建及保存等常见操作。此外,文章还介绍了利用xmltodict库实现XML与JSON格式之间的高效互转方法,并附带完整代码示例,帮助开发者快速掌握Python处理XML数据的技巧。
本文详细介绍Python中Beautiful Soup库的使用方法。涵盖安装、四大核心对象(Tag、NavigableString、BeautifulSoup、Comment)的解析,文档树遍历与搜索技巧(find_all、find、select),以及综合实例与lxml对比。
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
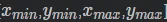
本文介绍如何利用Python结合OpenCV库,根据LabelImg生成的XML标注文件批量裁剪目标图片。通过解析XML中的边界框坐标,自动提取并保存裁剪后的图像,有效去除背景信息,提升模型训练数据质量。
本文深入剖析Python应用中常见的十大安全隐患,涵盖输入注入、断言误用、计时攻击、临时文件、YAML与XML解析风险、依赖污染及序列化问题。针对每种漏洞提供具体的代码示例与修复建议,帮助开发者构建更安全的Python应用。
本文详解Python获取网络数据的多种方法。从底层Socket通信原理出发,介绍利用urllib库简化HTTP请求的操作,并深入讲解如何使用ElementTree解析XML数据,以及利用json库高效处理JSON格式数据,为网络爬虫和数据抓取提供实用指南。
本文介绍Python中处理XML数据的基础方法。通过xml.etree.ElementTree模块,可以实现对XML文件的解析、遍历、修改节点属性与文本、删除节点以及动态创建新的XML文档结构。内容涵盖基本语法示例及常见操作代码,适用于需要与旧系统接口进行数据交换的场景。
本文介绍如何在Python中处理带有命名空间的XML文档。通过封装XMLNamespaces类简化ElementTree的查询操作,避免繁琐的全URI匹配。同时对比了iterparse的高级用法,并建议在需要DTD验证或复杂XPath时优先使用lxml库,以提升解析效率与功能支持。
本文介绍Python中处理HTML和XML字符串的常用方法。通过html.escape()函数转义特殊字符,利用encode()方法处理非ASCII编码实体,以及使用HTMLParser和xml.sax.saxutils进行实体解码。建议优先使用解析器自动处理,确保文本安全与格式正确。
本文详细解析Python中XML、字典、JSON字符串及类实例之间的相互转换方法。通过xmltodict和dicttoxml库简化XML处理,结合json模块的dumps/loads及object_hook/default回调机制,实现数据格式的高效互通,适用于Django开发及各类数据交互场景。