

Python爬虫网络请求:IP代理、Cookie与异常处理详解
本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
2026-10-15
5

本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
本文深入讲解Python中Requests模块的安装与基础用法,详细对比GET与POST请求在TCP层面的差异及适用场景。通过代码示例演示如何传递params和payload参数,解析响应对象属性,帮助开发者掌握网络请求的核心技巧,适用于渗透测试与数据抓取场景。
本文详细解析Python中urllib标准库与第三方库urllib3的区别。urllib包含request、parse、error和robotparser四个模块,适用于基础网络请求。urllib3功能更强大,支持连接池、线程安全、代理及SSL验证。文章通过代码示例对比两者在GET/POST请求、Cookie处理、代理设置、文件上传及超时处理上的具体用法,帮助开发者根据需求选择合适的库。
本文深入解析Python标准库urllib与第三方库urllib3的核心用法与区别。详细阐述urllib.request、error、parse及robotparser模块功能,并通过urlopen实例演示远程文件读取。对比两者在身份验证、Cookie处理及协议扩展上的优劣,帮助开发者根据场景选择最佳网络请求方案。
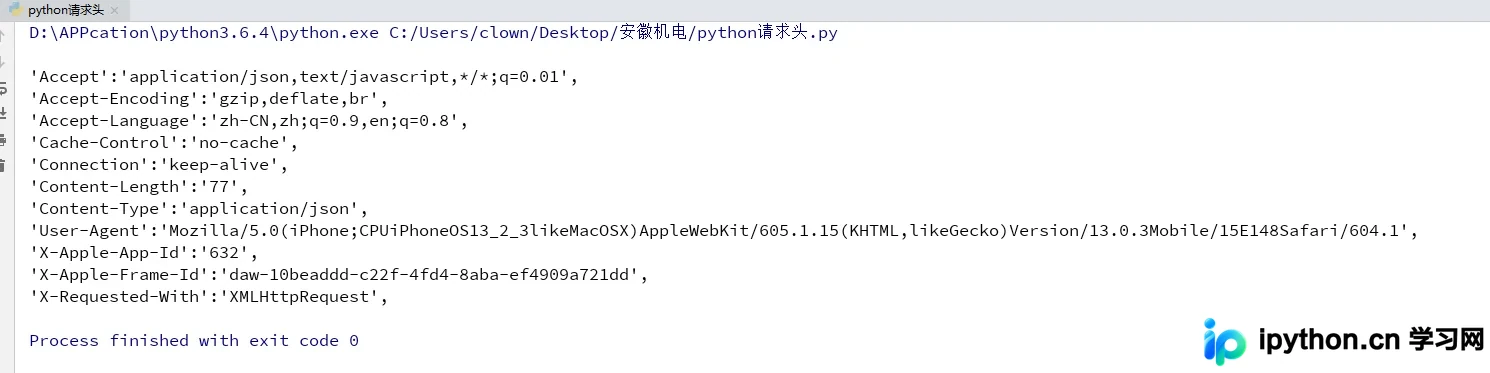
本文详解Python爬虫中Requests库设置Headers请求头的技巧。针对网页反爬限制,通过抓取浏览器真实请求头并模拟User-Agent等关键信息,有效绕过禁止爬取提示。文章提供从获取Headers到代码实现的完整步骤,帮助开发者解决爬虫访问被拒问题。
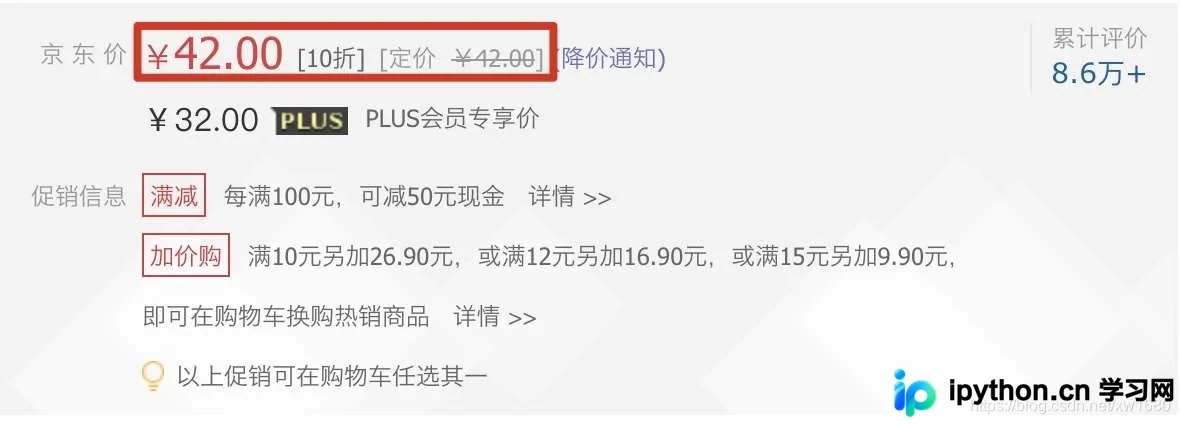
本文详解Python爬虫中动态加载数据的识别与抓取方法。通过浏览器开发者工具分析网络请求,定位非URL直接返回的数据接口,利用requests发送请求并解析JSON数据,解决商品价格等动态内容无法直接获取的问题。
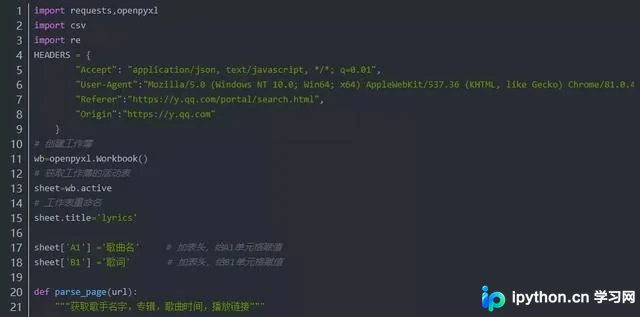
本文详细介绍如何利用Python爬虫技术批量获取QQ音乐歌词。通过浏览器开发者工具分析网络请求,定位搜索接口与歌词接口的URL及参数,编写代码提取歌曲信息与歌词文本,最终使用openpyxl库将结果保存为Excel文件,实现本地化存储与整理。
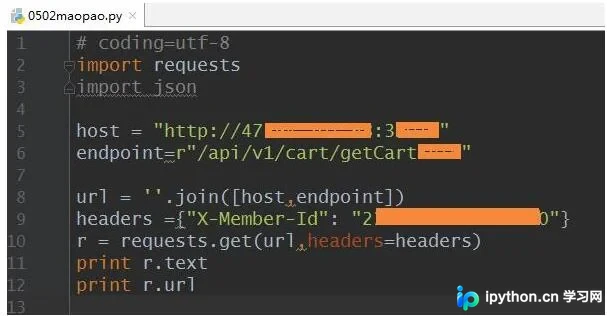
本文介绍如何在 Python 中使用 requests 库发送带 Header 的 HTTP 请求。通过示例展示如何构建请求头字典并传递给 requests.get 方法,涵盖常见 Header 字段如 Accept、Content-Type 和 Cookie 的作用及配置方式,帮助开发者掌握 API 调用的基础技巧。
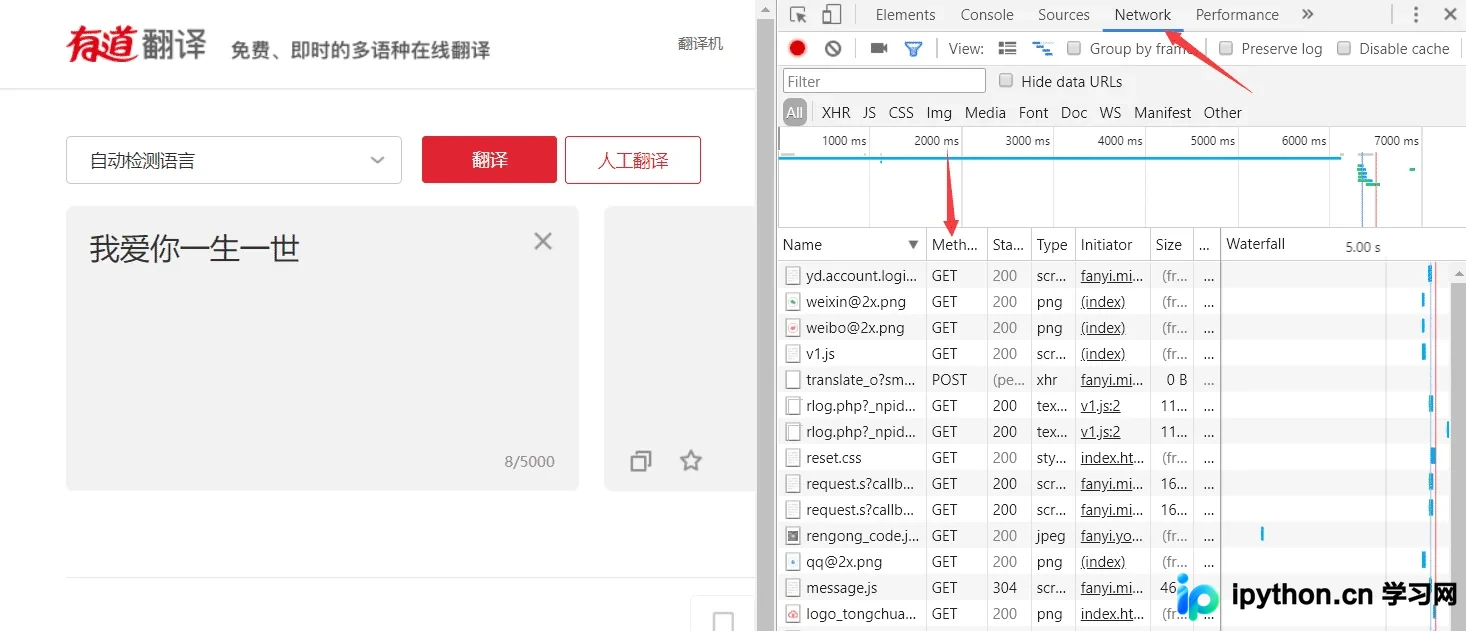
本文详解如何使用Python的urllib库模拟有道在线翻译的POST请求。通过浏览器开发者工具分析网络请求,识别GET与POST差异,重点讲解urlopen方法中data参数的应用、字典数据的构造以及UTF-8编码转换原理,帮助开发者掌握基础网页抓取与接口模拟技巧。
本文详细介绍Python中retrying模块的安装方法及通过装饰器实现自动重试的核心用法。深入解析stop_max_attempt_number、wait_fixed、wait_exponential等关键参数的配置逻辑,结合代码示例说明如何控制重试次数、等待时间及异常过滤条件,帮助开发者高效处理爬虫或网络请求中的不稳定情况。
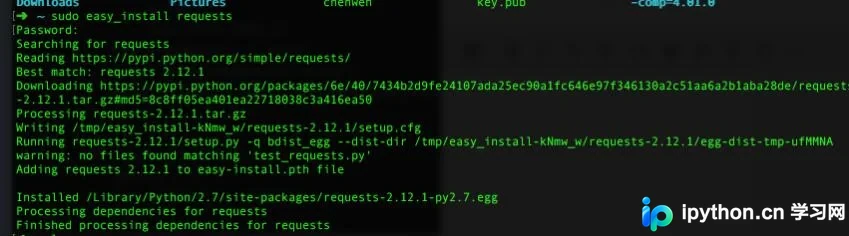
本文介绍在macOS系统中安装Python网络请求库requests的方法。通过执行sudo easy_install requests命令,用户可快速完成安装。安装成功后,即可在Python项目中正常使用requests进行网络请求操作。
本文介绍Python3中网络请求路径包含中文时引发的UnicodeEncodeError错误。通过示例展示如何利用urllib.parse.quote对中文参数进行编码,从而解决浏览器自动处理而代码需手动编码的问题,确保请求正常发送。