

Python3实现淘宝商品信息爬取实战解析
本文详细解析使用Python3爬取淘宝商品信息的完整代码流程。通过requests获取网页源码,利用正则表达式精准提取价格、名称、地址及图片链接,并展示如何遍历多页数据并格式化输出结果。代码包含异常处理机制,适合初学者理解网络爬虫的基本逻辑与实现细节。
2026-10-13
6

本文详细解析使用Python3爬取淘宝商品信息的完整代码流程。通过requests获取网页源码,利用正则表达式精准提取价格、名称、地址及图片链接,并展示如何遍历多页数据并格式化输出结果。代码包含异常处理机制,适合初学者理解网络爬虫的基本逻辑与实现细节。
本文详细解析Scrapy框架中Spider的四种核心爬取模式。通过具体代码示例,演示如何抓取单页数据、基于预设列表生成多页链接、识别并跟随“下一页”按钮,以及进入子链接提取深层内容。涵盖start_urls配置、parse回调处理及Request对象的使用,帮助开发者掌握不同场景下的爬虫构建技巧。
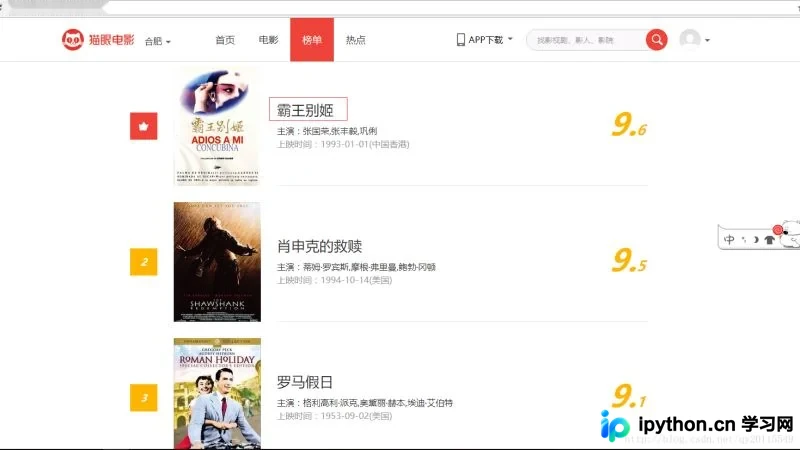
本文详细介绍如何使用Python的requests模块发起HTTP请求获取HTML源码,并结合BeautifulSoup库解析网页结构。通过抓取猫眼电影Top100榜单的具体案例,演示安装依赖、构造请求及提取电影标题与链接的完整流程,提供可直接运行的代码示例。
本文详细介绍如何利用Python解析HTML网页内容并生成Word文档。通过安装setuptools和python-docx组件,结合sgmllib与urllib获取数据,实现了从网页抓取到文档生成的自动化流程。文中提供了完整的代码示例及安装步骤,适用于需要批量处理网页数据并导出为Word格式的场景。
本文详细演示了使用Python进行数据抓取与分析的完整流程。通过requests获取页面,利用BeautifulSoup和XPath解析HTML及JS动态数据,并将结果存入MongoDB。文章涵盖分类网址获取、产品详情页抓取、数据清洗入库及异常处理等核心步骤,提供具体代码实现供参考。
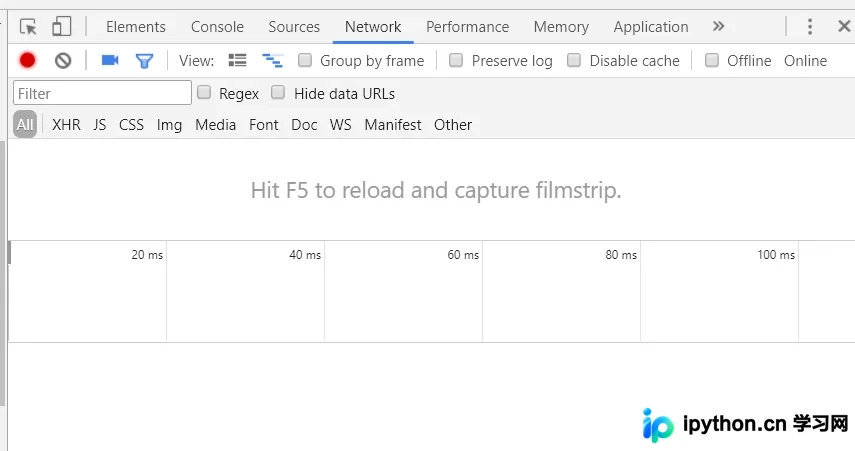
本文介绍如何使用Python3和requests模块抓取B站视频的历史弹幕数据。通过Chrome开发者工具分析网络请求,定位rolldate和dmroll接口,获取弹幕ID及时间戳。利用正则表达式解析返回的XML数据,按日期保存弹幕内容至本地文件,为后续词云或情感分析提供数据支持。
本文介绍如何利用Python多线程技术提升爬虫效率,以爬取糗事百科段子为例。通过对比普通爬虫与多线程爬虫的实现方式,解析URL规律并展示核心代码逻辑。多线程机制可并行执行任务,显著加快数据抓取速度,适合需要处理大量页面数据的场景。
本文提供一段Python代码示例,演示如何抓取大众点评网中关村区域的餐馆信息。通过模拟浏览器请求并解析HTML页面,利用正则表达式提取餐馆名称,最终输出抓取到的餐厅列表。
本文提供基于Python和Selenium库的淘宝登录及数据爬取代码示例。通过模拟浏览器操作实现账号登录,并演示如何抓取特定网页内容。文中指出该方法可能触发平台风控,建议根据实际需求调整策略,并提到不登录模式在某些场景下可能更为有效。
本文详细介绍如何使用Python编写脚本,通过抓包获取斗鱼App的垂直房间API接口,解析返回的JSON数据并提取主播头像链接。文章包含完整的Python代码示例,演示如何构造请求、处理翻页逻辑(offset参数)以及批量保存高清图片至本地文件夹,适合Python初学者学习网络爬虫基础。

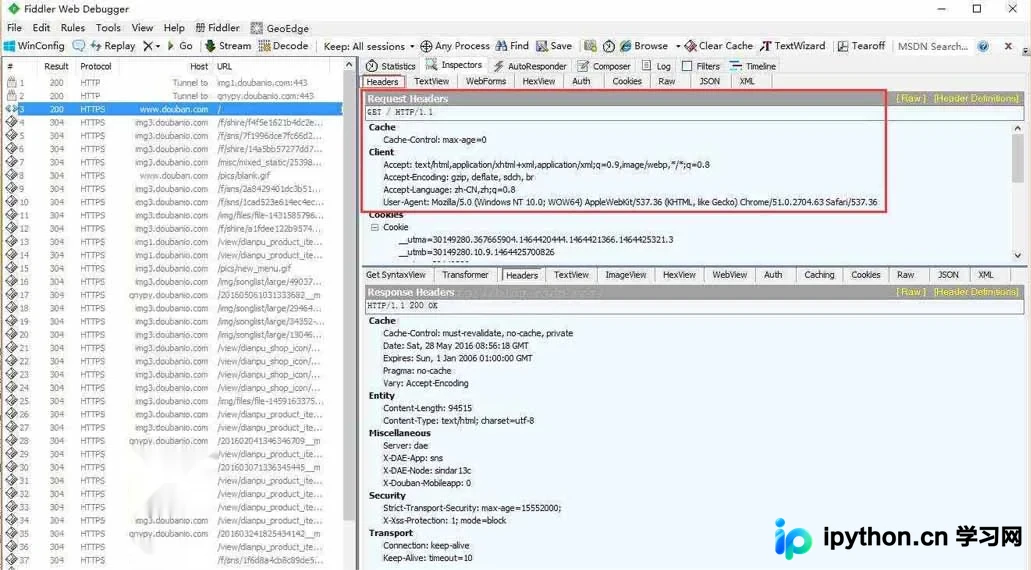
本文详解如何在Python爬虫中伪装浏览器以获取正常响应。通过Fiddler工具抓取豆瓣网站的真实请求头,提取User-Agent等关键信息,并在代码中自定义Request Headers进行模拟。附带完整Python示例代码及运行结果分析,帮助开发者解决反爬限制问题。
本文介绍如何利用Python语言编写一个简单的网络爬虫,从段子网(ishuo.cn)批量抓取搞笑段子。通过解析URL规律并结合urllib与re模块,实现对段子内容的自动提取与本地存储,为聊天机器人或内容发布提供数据支持。