

Python3使用Requests和BeautifulSoup抓取赶集网列表数据教程
本文详细介绍如何使用Python3结合Requests和BeautifulSoup模块爬取赶集网列表数据。文章涵盖环境配置、模块安装及核心代码实现,通过构造请求头模拟浏览器访问,解析HTML并提取标题信息,帮助开发者快速掌握基础爬虫技巧。
2026-10-13
6

本文详细介绍如何使用Python3结合Requests和BeautifulSoup模块爬取赶集网列表数据。文章涵盖环境配置、模块安装及核心代码实现,通过构造请求头模拟浏览器访问,解析HTML并提取标题信息,帮助开发者快速掌握基础爬虫技巧。
本文详细讲解如何使用Python3配合Fiddler工具抓取手机APP接口数据。内容涵盖Fiddler安装配置、手机代理设置、证书信任及抓包测试,并以王者荣耀盒子APP为例,演示如何解析英雄与装备接口数据,最终提供完整的Python爬取代码供参考。
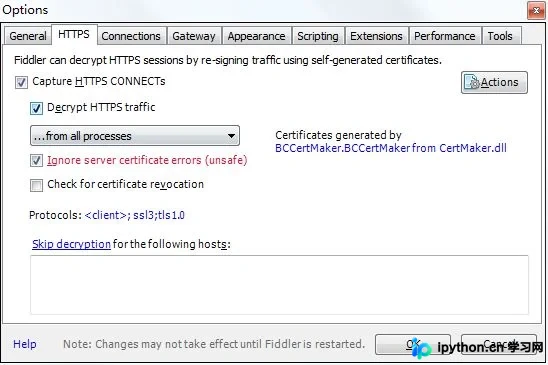
本文介绍如何利用Python编写脚本爬取淘宝商品销量信息。通过指定关键词和分页参数,程序可自动获取商品列表并计算总销量。支持在代码中通过特定标记约束作者、时期等属性,适用于电商数据分析场景。
本文提供一段Python代码,演示如何抓取网易云音乐歌曲的热评。通过构造请求头与参数,利用requests库获取数据,并解析JSON提取用户昵称及评论内容,最终保存至本地文本文件。
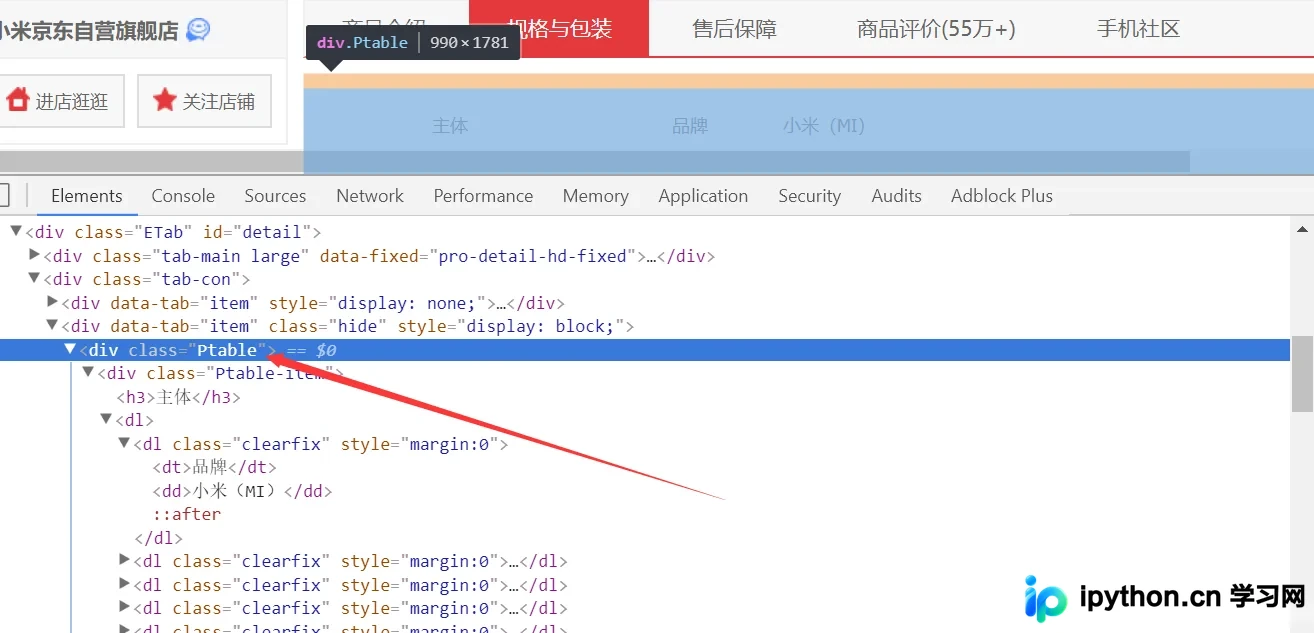
本文演示如何使用Python的requests库获取京东商品页面源码,并结合BeautifulSoup解析HTML结构。通过定位特定class的div容器,提取dl、dt和dd标签中的键值对数据,最终使用pandas构建DataFrame存储商品参数信息。
本文介绍如何利用Python的requests、lxml及xlsxwriter库,通过构造高德地图API接口批量抓取水果店等POI数据。教程涵盖环境配置、请求参数构造、分页循环逻辑及Excel表格写入实现,帮助开发者快速掌握地图数据抓取与本地存储技巧。
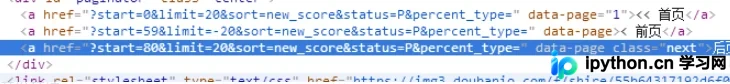
本文详细介绍使用Python抓取豆瓣影评数据的两种方法。首先通过PC端网页分析URL参数,利用Requests和BeautifulSoup解析HTML并递归获取评论;随后介绍更高效的移动端模拟策略,通过修改User-Agent直接调用豆瓣移动端API接口获取JSON数据,简化解析流程并提高抓取效率。
本文介绍了8个适合Python业余项目或快速原型的优秀第三方库。涵盖Dataset用于数据库即时存储、Beautiful Soup处理HTML、Requests简化HTTP交互、Click构建CLI、Python Slugify生成SEO友好链接、Pluggy实现插件系统、DataSette转换CSV为API以及Envparse管理环境变量。这些工具能显著缩短开发周期,提升代码质量与可维护性。
本文分享使用Python爬取微信公众号文章的完整代码示例。通过构建IP代理池、多线程并发抓取页面链接及内容,并存储至MySQL数据库,实现了高效的数据采集方案。代码包含详细的请求处理、异常捕获及线程同步逻辑,供开发者参考学习。
本文介绍如何利用Python分析Ajax请求来抓取今日头条的街拍图集。通过解析返回的JSON数据获取图片列表,并结合多线程与MongoDB存储实现自动化抓取。文章提供了完整的代码示例及关键参数配置说明,帮助开发者掌握动态网页数据抓取技巧。
本文介绍了一个基于Python的小型爬虫系统实现,涵盖URL管理、HTML下载、解析及输出模块。通过正则表达式提取链接,利用BeautifulSoup解析文本内容,并支持将抓取结果保存为HTML表格或TXT文件。代码展示了从初始URL到批量文档下载的全流程,适合Python初学者理解爬虫架构与核心逻辑。
本文介绍利用Python和BeautifulSoup4技术,从足球直播吧网站抓取五大联赛积分榜数据的完整流程。通过解析HTML结构并处理URL请求,实现对各联赛排名信息的自动化采集,为数据分析提供基础素材。