Python面向对象爬取百度贴吧:requests库实现前1000页数据抓取
本文介绍如何使用Python的requests库结合面向对象思想,编写程序批量抓取百度贴吧指定吧前1000页的网页内容。通过封装URL生成、请求发送及HTML保存等方法,实现高效的数据采集流程,适合初学者理解爬虫基础逻辑与代码结构。
2026-10-13
6

本文介绍如何使用Python的requests库结合面向对象思想,编写程序批量抓取百度贴吧指定吧前1000页的网页内容。通过封装URL生成、请求发送及HTML保存等方法,实现高效的数据采集流程,适合初学者理解爬虫基础逻辑与代码结构。
本文详细解析如何使用Python的Requests库结合正则表达式,抓取某段子网站的前20页文本数据。文章从抓包分析入手,梳理URL翻页规律,通过对比正则匹配结果优化提取逻辑,最终实现面向对象风格的完整爬虫代码,将内容保存至本地。
本文介绍如何使用Python库wxpy对接微信接口,实现自动化管理微信公众号及获取个人微信数据。通过调用itchat底层指令,可批量导出好友信息、自动归档聊天记录(含音视频图片)并建立本地数据库。文章提供了基于wxpy.register()实现自动回复、消息转发及特定对象互动的具体代码示例,适用于个人数据备份与基础公众号运营场景。
本文介绍如何使用仅50行Python代码批量抓取高考志愿信息。通过结合requests-html解析网页与openpyxl处理Excel,实现从URL列表读取、网页内容提取到数据写入的全流程。文中详细讲解了处理非结构化HTML、正则表达式分割学校名称及表格切片等关键技术点,并提供了完整的错误处理与代码示例,帮助开发者快速完成数据自动化任务。
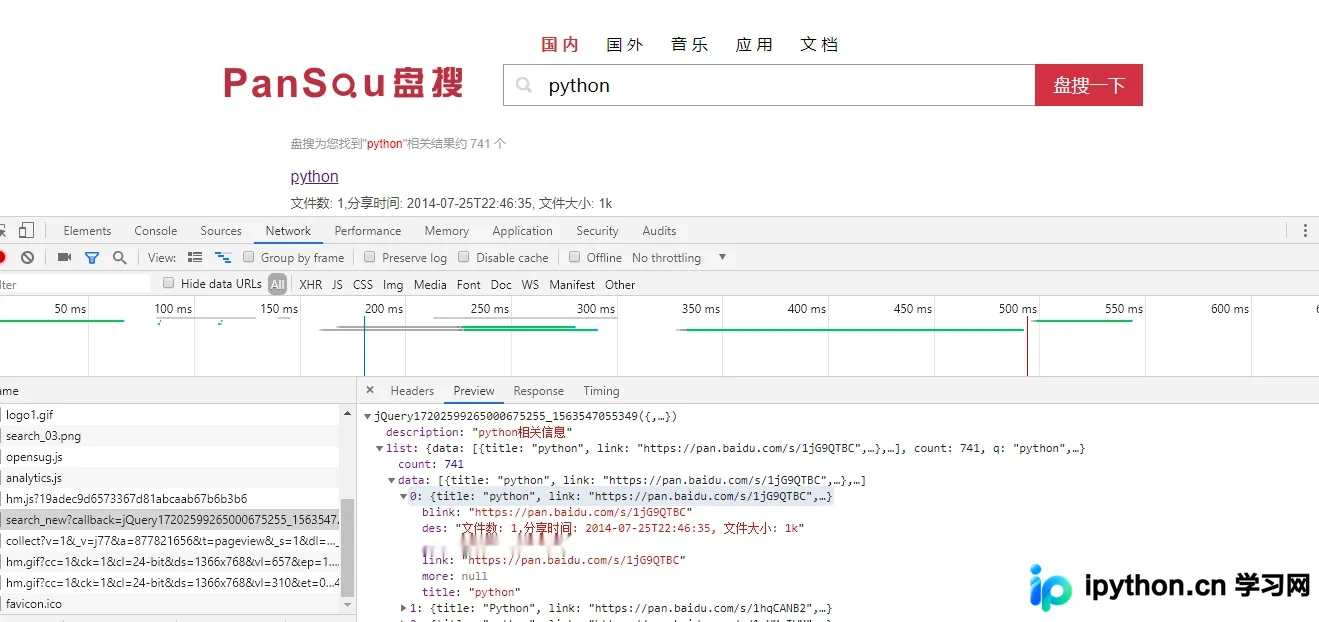
本文介绍如何使用Python编写爬虫,从盘搜网站筛选出有效的网盘链接。通过解析接口获取JSON数据,结合多线程技术提高爬取效率,并保存结果至CSV文件。代码包含详细的请求头设置、异常处理及文件写入逻辑,适合初学者练习网络爬虫开发。
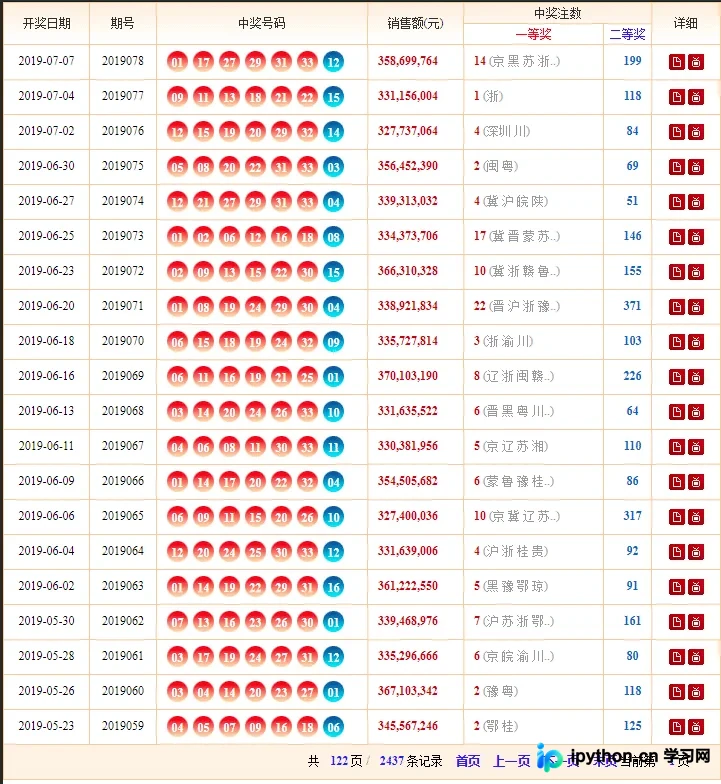
本文基于Python语言,演示如何抓取双色球历史开奖数据,并通过统计红蓝球出现频率来预测下一期号码。文章涵盖环境配置、网页解析、数据清洗及排序算法,提供完整代码示例。需注意的是,彩票具有随机性,本文方法仅基于历史数据统计,不构成中奖保证。
本文详解如何利用Python的requests库爬取包含复杂参数的Post接口。针对部分网站要求同时传递Query字符串参数与空的JSON Body以触发反爬机制的特殊场景,提供了具体的代码实现方案。文章分析了请求头配置、参数序列化及raw格式提交的关键点,帮助开发者解决此类逆向工程难题。
本文演示如何使用Python的urllib库获取基金网站网页内容,并利用BeautifulSoup库解析HTML结构。通过具体代码示例,展示如何读取网页源码、处理编码问题,并提取基金编码、名称及净值等关键信息,供Python开发者参考学习。
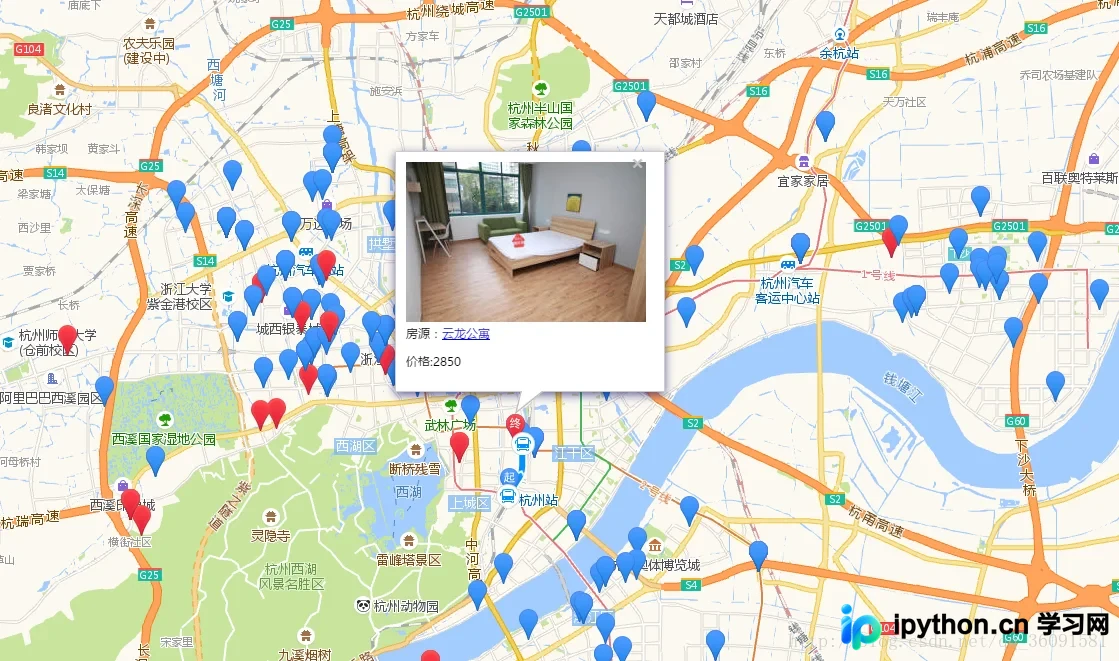
本文介绍使用Python爬虫技术抓取58同城杭州地区特定价格段的公寓房源数据,并通过高德地图API将房源位置、价格等信息可视化展示在地图上。文章包含Python后端抓取逻辑与前端HTML/JS交互代码,支持工作地点筛选及通勤方式计算,帮助开发者快速实现房源地图展示功能。
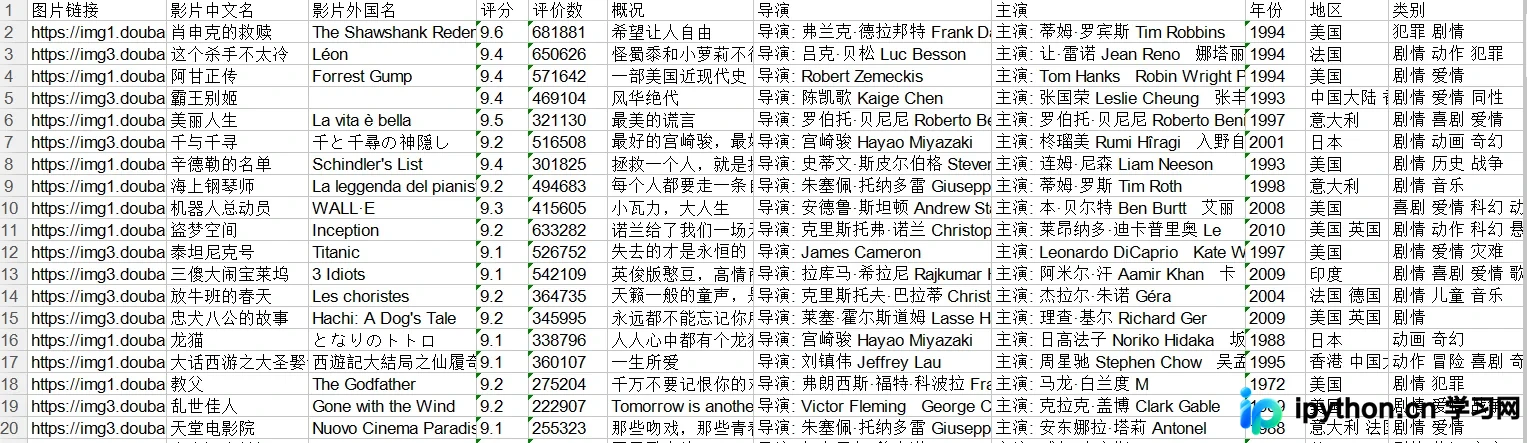
本文详细演示如何使用Python爬取豆瓣电影Top250的12项关键信息,包括链接、评分、主演及年份等。通过正则表达式解析HTML,利用BeautifulSoup和xlwt库将数据整理并写入Excel文件,提供完整代码供参考。
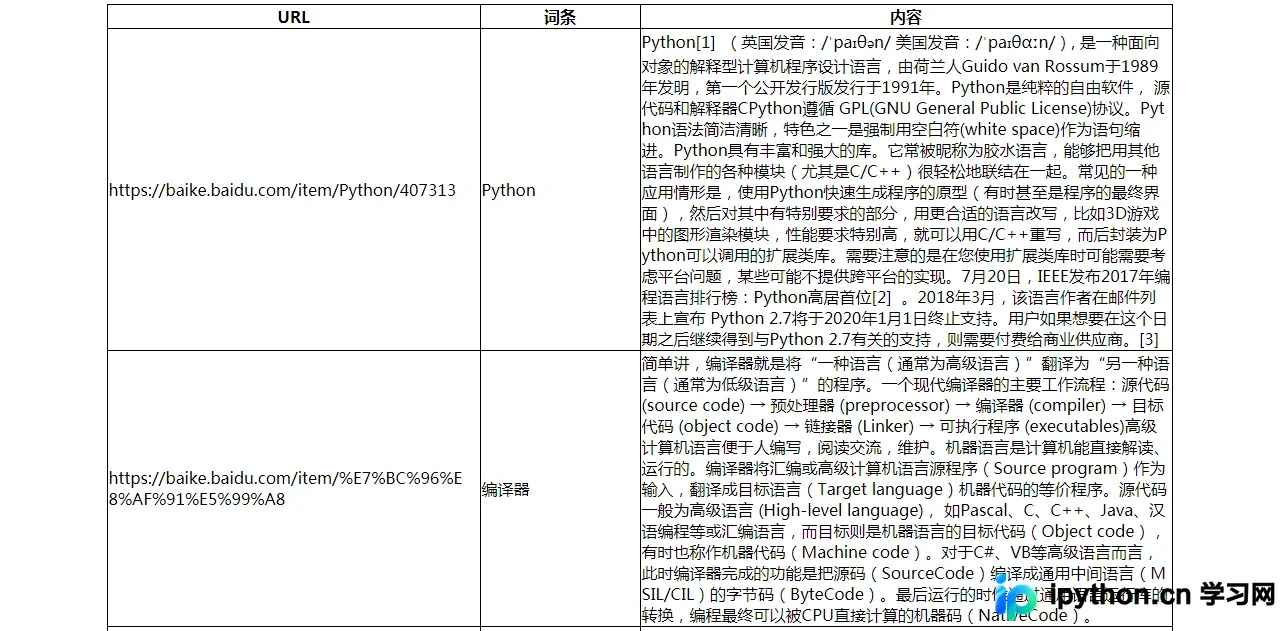
本文详细介绍如何使用Python编写一个完整的网页爬虫程序,重点解析URL管理器、网页下载器、网页解析器和输出处理器四大核心组件的实现逻辑。通过具体代码示例,演示如何从百度百科抓取词条数据,包括链接提取、HTML解析及结果存储,适合Python初学者理解爬虫工作原理。
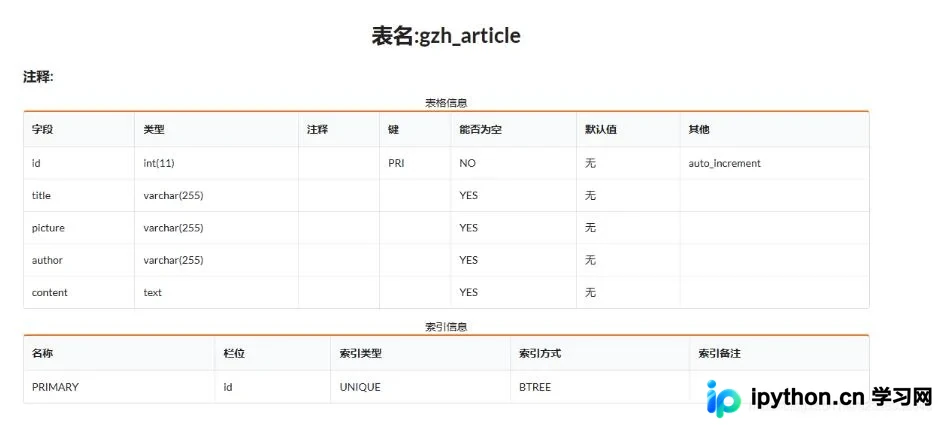
本文介绍如何使用Python编写爬虫程序,通过搜狗微信搜索接口抓取公众号文章标题、封面及正文内容,并利用pymysql库将数据持久化存储到MySQL数据库中。代码示例展示了数据库连接、数据去重检查及插入逻辑,供初学者参考学习。