
TensorFlow入门:从基础概念到模型训练与评估实战
本文详解TensorFlow作为第二代深度学习框架的核心机制,涵盖数据流图、张量及Session执行原理。通过Python代码示例,逐步演示变量定义、占位符使用、权重初始化、交叉熵损失函数构建、梯度下降优化以及模型准确率评估的完整流程,帮助开发者快速掌握TensorFlow基础应用。
2026-10-13
6


本文详解TensorFlow作为第二代深度学习框架的核心机制,涵盖数据流图、张量及Session执行原理。通过Python代码示例,逐步演示变量定义、占位符使用、权重初始化、交叉熵损失函数构建、梯度下降优化以及模型准确率评估的完整流程,帮助开发者快速掌握TensorFlow基础应用。
本文深入解析TensorFlow中反向传播的实现原理,通过回归与二分类两个具体案例,展示如何定义计算图、声明优化函数及最小化损失。重点介绍GradientDescentOptimizer的使用及学习率对收敛的影响,结合代码输出验证模型参数的动态调整过程,帮助开发者理解自动微分与变量更新机制。
本文介绍如何使用TensorFlow实现弹性网络回归算法。通过加载鸢尾花数据集,构建包含L1和L2正则项的损失函数,并利用占位符和变量定义模型。代码展示了从数据预处理、模型训练到可视化损失收敛的全过程,旨在帮助读者理解多变量回归中的正则化技术应用。
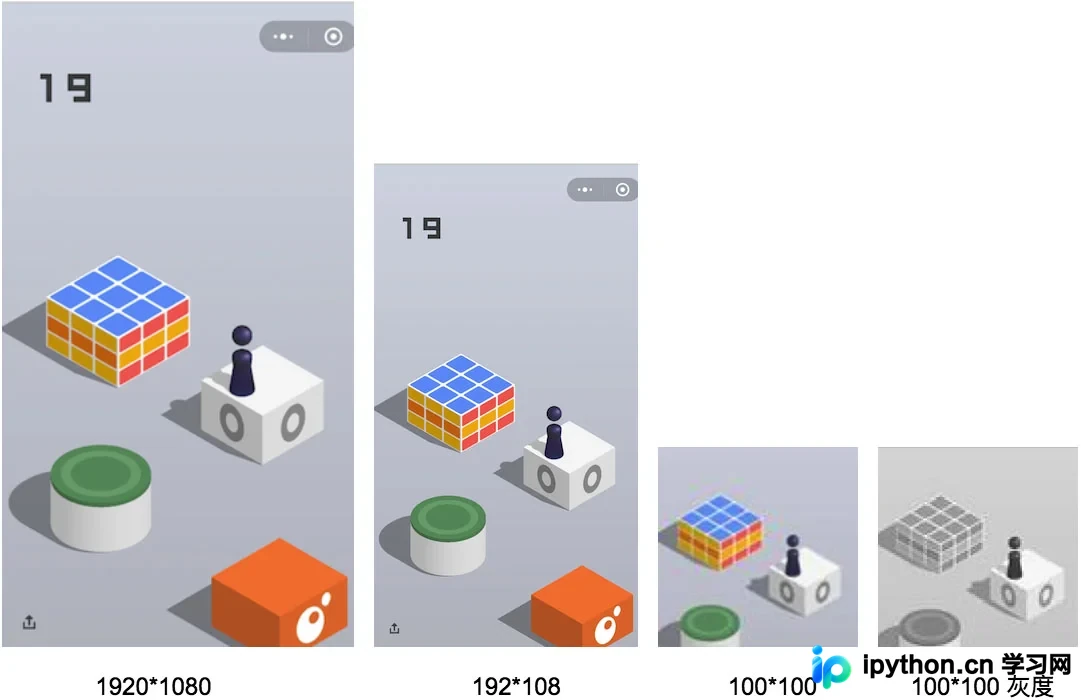
本文详解如何利用TensorFlow构建卷积神经网络,结合ADB自动化截屏与点击,实现微信跳一跳游戏的AI自动通关。通过采集800组样本数据训练模型,解析从图像预处理、CNN架构搭建到参数优化的完整流程,帮助开发者掌握AI在游戏自动化中的应用。
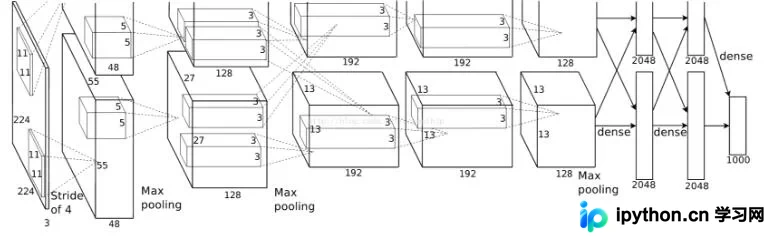
本文详细解析如何使用TensorFlow复现经典的AlexNet模型。重点还原了论文中双GPU并行的原始网络结构,而非常见的单GPU合并版本。文章涵盖模型定义、参数加载及测试流程,通过具体代码示例展示如何对渣土车等常见物体进行图像分类识别,适合希望深入理解AlexNet架构及熟悉TensorFlow操作的开发者参考。
本文详解 Python 多核并行计算方案。针对 CPython 的 GIL 限制,对比 threading 与 multiprocessing,推荐 Pool 及 imap 系列函数实现高效并行。重点解析在 TensorFlow 等 GPU 工具中,因父进程导入导致的 CUDA 初始化错误,并提供通过 Process target 或 Pool initializer 在子进程内延迟导入的两种修复策略。
本文深入解析13个主流Python深度学习库,涵盖Caffe、Theano、TensorFlow、Keras、mxnet等框架。从初学者友好的高层封装到高性能底层实现,详细对比各库在模型构建、分布式训练及特征提取方面的优劣,助你在计算机视觉与模型训练中做出最佳技术选型。
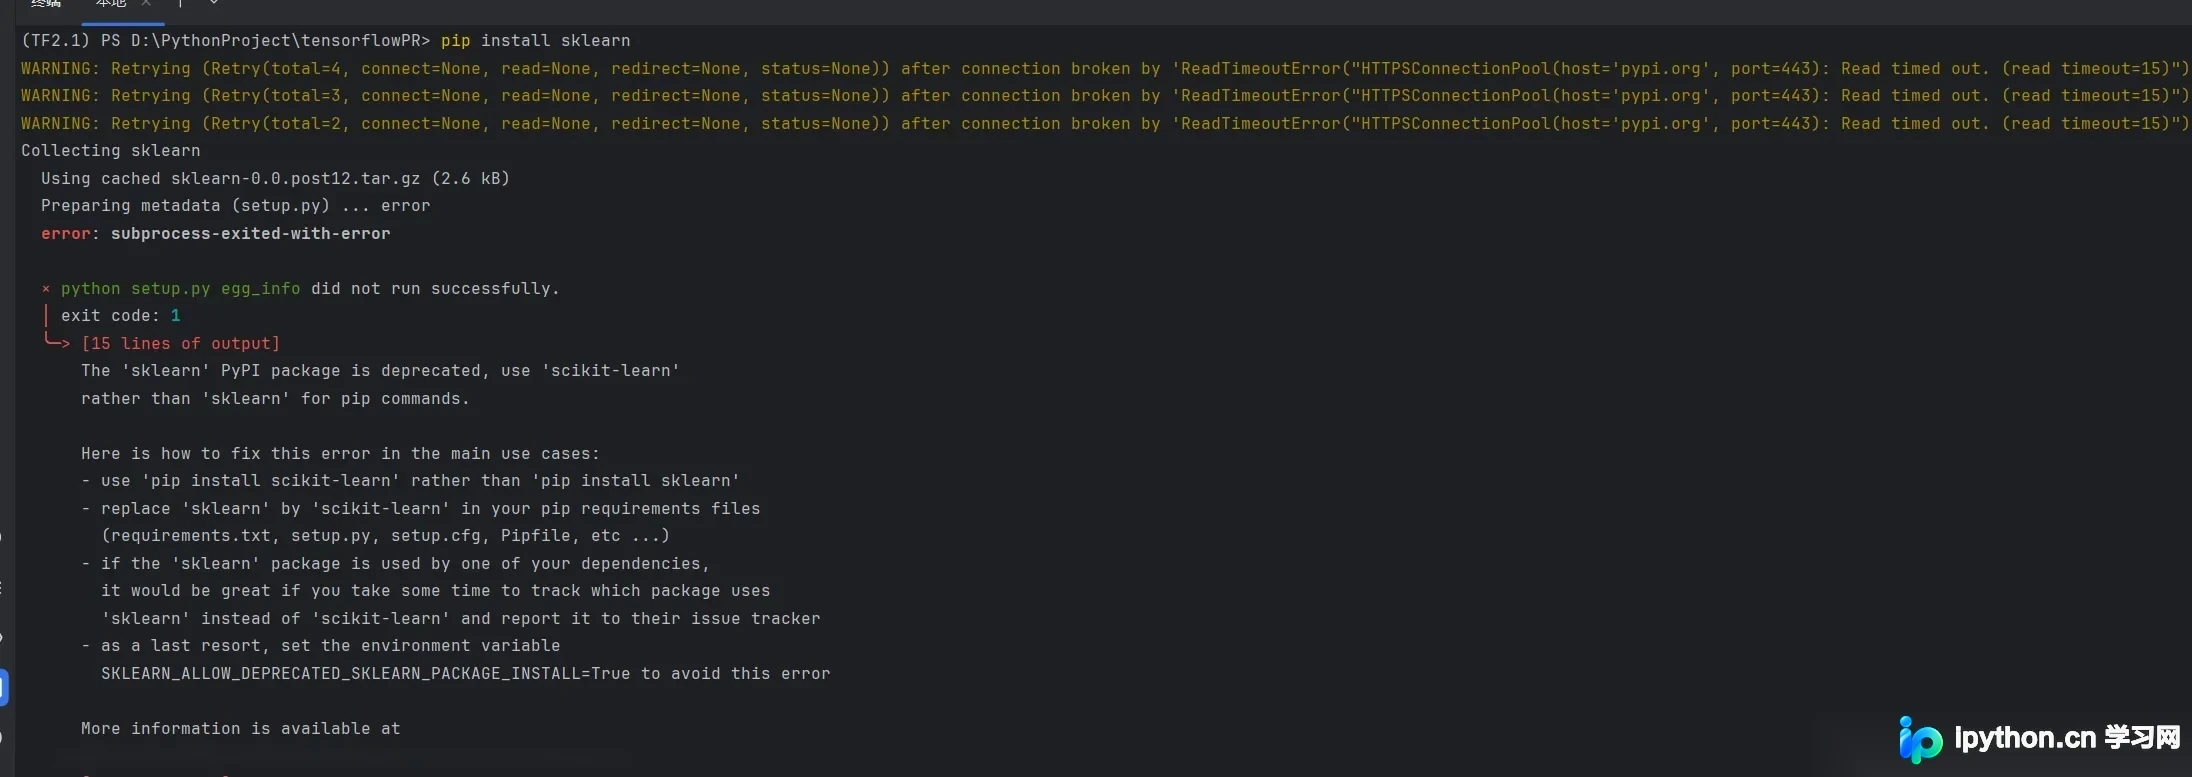
本文针对学习TensorFlow时遇到的sklearn包安装失败问题,指出sklearn已弃用并应使用scikit-learn。针对国内网络环境下载困难的情况,提供了使用清华大学PyPI镜像源成功安装scikit-learn的具体命令与解决方案。
本文详细介绍将TensorFlow模型转换为ONNX格式的具体流程。首先通过Python代码冻结动态图生成PB文件,随后利用tf2onnx工具进行转换。重点解析命令行参数,特别是针对TF默认NHWC与ONNX NCHW布局差异的--inputs-as-nchw选项,并提供直接通过API转换Keras模型的方法,适用于模型部署场景。
本文深入解析TensorFlow中tf.name_scope与tf.variable_scope的核心区别,重点阐述变量共享机制。通过对比tf.Variable()与tf.get_variable()的行为,详解reuse参数及AUTO_REUSE模式在变量复用中的作用,帮助开发者正确管理模型参数。
本文深入解析TensorFlow中tf.while_loop的执行机制,重点探讨全局变量和类成员变量在循环体内的行为。通过代码案例说明,非loop_vars指定的变量不会参与图循环,且print等操作在定义时即执行。文章指出,只有传入loop_vars并返回的变量才会真正随循环迭代更新,其他变量仅能只读或重置,帮助开发者避免常见的状态管理错误。
本文介绍在TensorFlow中如何实现基于阈值的张量转换。通过tf.where函数,可轻松将大于指定值的元素设为1,小于该值的元素设为0。示例展示了利用tf.ones_like和tf.zeros_like构建全1或全0张量,并结合tf.where完成条件赋值的具体代码。