
Python降级至3.6的终极解决方案:Homebrew与Conda操作指南
针对Tensorflow不支持Python 3.7的问题,本文提供将Python降级至3.6的完整解决方案。内容涵盖使用Homebrew移除现有版本并通过指定公式安装3.6.5,以及利用Conda直接安装指定版本的命令。适用于Mac用户解决环境兼容性问题,确保开发环境稳定运行。
2026-10-13
6


针对Tensorflow不支持Python 3.7的问题,本文提供将Python降级至3.6的完整解决方案。内容涵盖使用Homebrew移除现有版本并通过指定公式安装3.6.5,以及利用Conda直接安装指定版本的命令。适用于Mac用户解决环境兼容性问题,确保开发环境稳定运行。
本文介绍了在TensorFlow项目中从TXT文件读取数据的两种主流方法:使用numpy的loadtxt函数和pandas的read_csv函数。文章详细展示了两种方法的代码实现,并重点强调了读取后的数据形状必须与模型定义的placeholder保持一致,以确保后续训练流程的顺利进行。
本文分析TensorFlow训练过程中因动态创建未注册节点导致的内存持续增长及进程被杀问题。通过示例说明在run中直接操作非图节点(如x+y或切片test[0])会触发节点重复创建,建议先运行图节点再处理结果以规避内存溢出。
本文详解如何在TensorFlow中将8x8个32x32图像块重组为256x256图像。核心步骤包括利用tf.reshape调整维度,通过tf.concat进行行列拼接,以及处理batch_size维度时结合list与tf.stack。文章还指出了TensorFlow中直接赋值报错的解决方案,提供完整代码示例供深度学习开发者参考。
本文介绍如何在TensorFlow中通过自定义损失函数来优化商品销量预测模型。传统均方误差可能忽略成本与利润差异,本文通过设定不同预测偏差的惩罚系数,使模型更贴合实际商业利益。结合具体代码示例,展示如何利用tf.greater和tf.where构建非对称损失函数,并验证其对预测结果的影响。
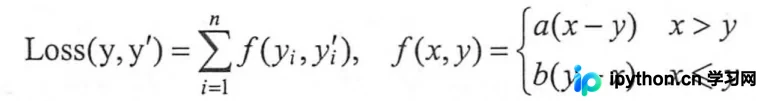
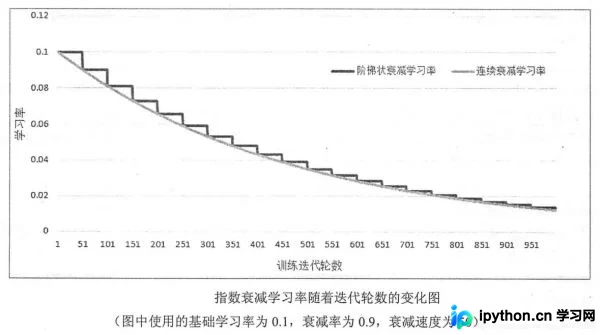
本文介绍TensorFlow中tf.train.exponential_decay函数的用法。该函数通过设置初始学习率、衰减系数和衰减步数,实现学习率的指数级下降。文章详细解析了staircase参数对连续衰减与阶梯状衰减的影响,并展示了global_step作为变量自动更新和作为占位符手动feed的两种典型应用形态,帮助开发者优化模型训练过程。
本文通过商品销量预测实例,详解如何在TensorFlow中自定义损失函数。针对均方误差无法反映预测偏差成本差异的问题,通过设定预测偏高与偏低的惩罚权重,构建分段损失函数。代码展示如何利用tf.where实现非对称惩罚,并对比不同权重设置对模型最终参数的影响,帮助开发者优化特定业务场景下的模型表现。
本文针对TensorFlow在批量测试时因sess.run导致的内存溢出问题,分析发现根源在于for循环内部动态创建tf操作节点,导致计算图无限膨胀。通过将resize_bilinear和argmax等Op移出循环至初始化阶段,可有效防止图节点重复增加,显著降低内存占用并提升推理速度。
本文介绍TensorFlow中两种自定义反向传播梯度的方法。第一种通过tf.RegisterGradient注册新梯度并使用gradient_override_map覆盖原操作,适用于不可导节点如符号函数的平滑近似。第二种利用tf.stop_gradient阻断前向梯度传播,实现前向与反向函数的解耦,常用于梯度反转场景。文章提供具体代码示例及注意事项,帮助开发者灵活控制梯度流。

本文深入解析TensorFlow中两种常用的梯度下降优化技术:指数衰减学习率与滑动平均参数更新。通过tf.train.exponential_decay函数实现学习率的动态调整,结合tf.train.ExponentialMovingAverage保持模型稳定性,帮助开发者提升模型收敛速度与泛化能力。
本文介绍如何在 TensorFlow 中实现自定义 Layer 并将其整合进多层计算图。通过定义滑动窗口平均操作及后续线性变换与激活函数,展示从占位符定义、卷积层构建到自定义逻辑层添加的完整流程,最终执行计算图获取结果。
本文通过TensorFlow代码实例,演示如何使用tf.gradients函数计算梯度。以矩阵乘法为例,解析变量w1对结果res的导数计算过程,并展示梯度裁剪的实现方式,帮助开发者理解梯度反向传播的基本原理。