
TensorFlow中tile函数详解:维度复制与使用示例
本文详细介绍TensorFlow中tile函数的核心功能,即复制张量的指定维度。通过具体代码示例解析参数含义,展示如何对多维数据进行行列扩展,帮助开发者掌握该函数的实际应用。
2026-10-13
6


本文详细介绍TensorFlow中tile函数的核心功能,即复制张量的指定维度。通过具体代码示例解析参数含义,展示如何对多维数据进行行列扩展,帮助开发者掌握该函数的实际应用。
本文详解TensorFlow中tf.ConfigProto()的核心用法,涵盖log_device_placement日志打印、inter/intra_op线程数设置及soft_placement自动分配机制。深入解析GPU模式下的显存增长策略(allow_growth)与固定比例限制(per_process_gpu_memory_fraction),并提供CUDA检测与设备指定代码示例,助力模型训练性能优化。
本文详细介绍TensorFlow中tf.dynamic_partition函数的使用方法,通过基础整数矩阵和One-Hot编码两个实例,演示如何根据索引列表将张量动态拆分为多个子张量。涵盖reshape操作、分区索引指定及结果验证,适用于需要动态处理多维数据分组的场景。
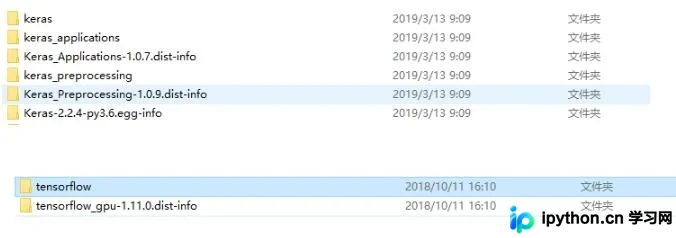
本文针对在Anaconda环境中安装TensorFlow-GPU后,Keras仍调用CPU进行计算的问题,分析了因同时存在tensorflow和tensorflow-gpu文件夹导致的默认调用冲突。通过彻底卸载现有库并重新在PyCharm中安装tensorflow-gpu和keras,成功实现GPU加速。
本文针对TensorFlow在使用GPU训练时出现CPU占用率过高且无法调用显卡的问题,分析其原因为TensorFlow GPU版本与服务器CUDA及CuDNN版本不匹配。通过检查当前CUDA和CuDNN版本,并在官网下载对应版本的TensorFlow-GPU进行重新安装,从而解决该兼容性问题,确保模型训练能正常利用GPU加速。
本文介绍在Python中使用TensorFlow时如何精确控制GPU资源。通过设置CUDA_VISIBLE_DEVICES指定可用GPU,利用per_process_gpu_memory_fraction限制显存使用百分比,以及通过allow_growth=True实现按需最小化占用。适用于多GPU环境下的资源分配与显存优化场景。
本文详细解析TensorFlow中出现的uninitialized value错误。主要涵盖两个原因:一是误用tf.metrics.mean_squared_error需初始化局部变量,二是节点错误定义在tf.Session内部。提供替换为tf.losses或添加初始化器的具体修复代码,帮助开发者快速定位并解决变量未初始化导致的运行异常。

本文介绍如何在TensorFlow中将训练好的模型保存为pb文件,并演示如何从该文件中恢复模型进行推理。通过graph_util.convert_variables_to_constants将变量转换为常量,实现模型的序列化存储与加载,适用于模型部署场景。
本文针对TensorFlow模型恢复时出现的“Attempting to use uninitialized value input_producer/input_producer/limit_epochs/epochs”错误进行解析。该错误通常由调用tf.train.slice_input_producer方法引起,系统将其识别为未初始化的Tensor。解决方案是在会话中获取batch前,先执行tf.global_variables_initializer()和tf.local_variables_initializer()进行初始化。
本文详解TensorFlow中tf.Variable的创建、类型形状固定机制及值修改方法。介绍global_variables_initializer全局初始化与initialized_value依赖初始化的使用场景,结合代码示例说明如何在Session中正确启动Graph并完成变量赋值操作。
本文介绍在 TensorFlow 中如何仅初始化未初始化的变量。通过 tf.global_variables() 获取全局变量列表,利用 tf.is_variable_initialized 判断状态,筛选出未初始化变量,最后使用 tf.variables_initializer 进行批量初始化。
本文介绍如何在运行TensorFlow Python程序时限制对GPU和CPU的占用。通过设置环境变量CUDA_VISIBLE_DEVICES指定可见GPU,或在代码中配置gpu_options.allow_growth实现显存按需分配。同时,提供了限制CPU线程数的方法,帮助优化资源使用,避免霸占所有GPU资源。