
TensorFlow生成常量、序列与随机值完整指南
本文详细介绍TensorFlow中生成常量、序列及随机值的核心函数。涵盖tf.zeros、tf.ones、tf.fill等常量创建方法,tf.linspace与tf.range序列生成技巧,以及uniform、normal和truncated_normal随机分布的使用。通过具体代码示例解析参数设置与输出结果,助力开发者高效构建神经网络初始数据。
2026-10-13
6


本文详细介绍TensorFlow中生成常量、序列及随机值的核心函数。涵盖tf.zeros、tf.ones、tf.fill等常量创建方法,tf.linspace与tf.range序列生成技巧,以及uniform、normal和truncated_normal随机分布的使用。通过具体代码示例解析参数设置与输出结果,助力开发者高效构建神经网络初始数据。
本文介绍在TensorFlow中读取并输出已保存模型权重数值的方法,主要用于将模型权重转换为其他框架格式。通过pywrap_tensorflow库读取Checkpoint文件,获取变量名及对应张量数据,并循环打印输出所有权重信息。
本文介绍如何利用 TensorFlow 的 pywrap_tensorflow 模块读取保存的 CKPT 模型文件。通过 NewCheckpointReader 获取变量形状映射,并遍历打印变量名称及具体张量值,适用于模型训练后的调试与验证场景。
本文介绍了在TensorFlow中查看.pb模型文件内部输入和输出节点名称的具体方法。通过加载GraphDef并遍历节点列表,可以获取模型的所有节点名称,从而确定输入和输出的具体标识。
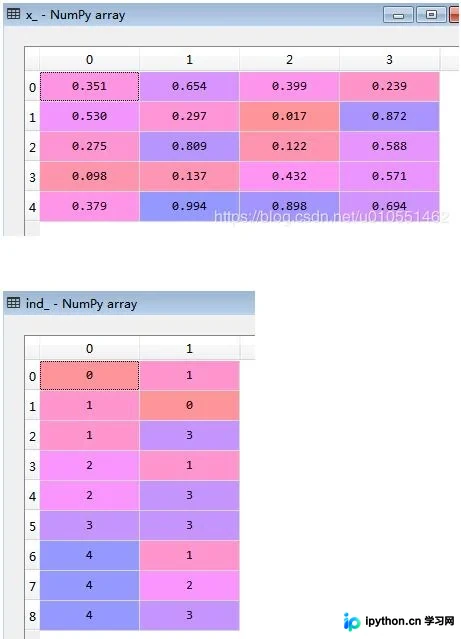
本文介绍在TensorFlow中提取满足特定条件数值的方法。由于无法直接通过索引引用,需结合tf.where获取索引,再使用tf.gather_nd或tf.gather将对应元素重组为新Tensor。重点解析二维索引下tf.gather_nd的正确用法及与tf.gather的维度差异。
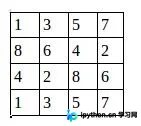
本文详细解析TensorFlow中tf.nn.conv2d及池化函数里的strides参数。strides作为滑动窗口的移动步长,需为长度不小于4的整数列表。默认情况下,batch和channels维度步长为1,而height和width维度可自定义调整,直接影响特征图尺寸与计算效率。
本文详细解析TensorFlow中tf.nn.conv2d函数的核心参数,包括input、filter、strides和padding的具体含义及形状要求。通过8个逐步递进的代码示例,演示了单通道、多通道、不同步长及填充方式下的卷积输出变化,帮助开发者深入理解Feature Map的生成机制。
本文详细介绍 TensorFlow 中 tf.nn.max_pool 函数的用法,涵盖参数说明(value, ksize, strides, padding)及返回值格式。通过双通道图像的最大值池化示例,展示不同步长下的计算结果,帮助理解卷积神经网络中的池化操作。
本文详细讲解在 Windows 10 系统下搭建 TensorFlow 2.0 开发环境的完整流程。内容涵盖 Anaconda 与 PyCharm 的安装、CUDA 10.0 及 cuDNN 的下载与配置、NVIDIA 驱动更新,以及通过命令行创建 Conda 虚拟环境并安装 GPU 版 TensorFlow。最后演示如何在 PyCharm 中关联该环境,确保开发者能顺利开始模型训练与部署工作。
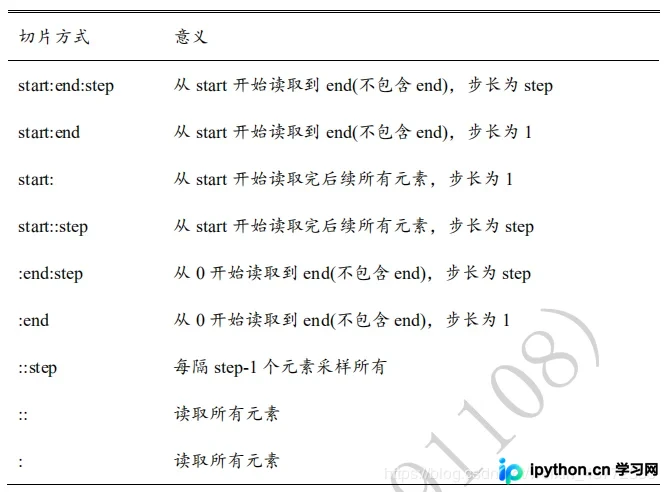
本文深入解析TensorFlow中索引与切片的核心机制。涵盖标准索引、逗号分隔索引及start:end:step切片语法,详解省略参数、负步长逆序读取及Ellipsis符号的高级应用。通过具体代码示例,帮助开发者高效提取张量数据,优化模型处理流程。
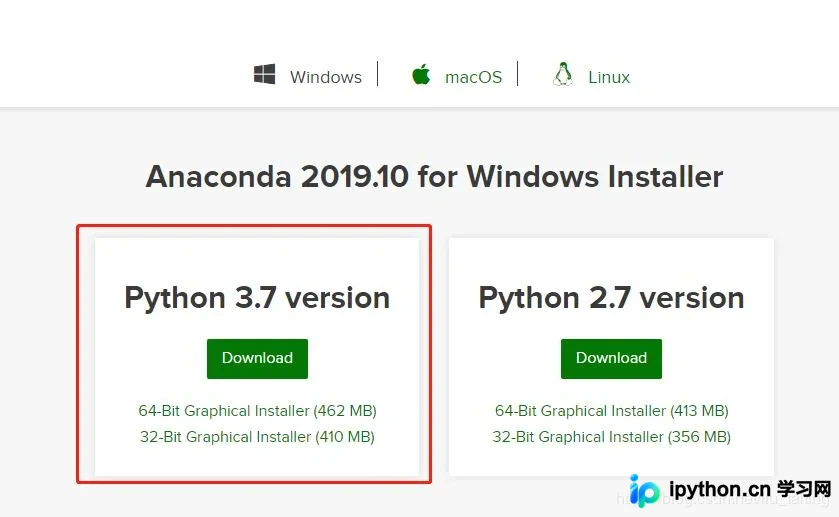
本文详细讲解在Windows 10系统中为Python 3.7环境安装TensorFlow和Keras的步骤。重点强调必须使用64位Python,提供通过官方渠道或非官方预编译包(如UCI LFD)安装的方法,并包含使用cmd命令行切换目录及更新pip的操作指引,帮助开发者顺利完成深度学习环境搭建。
本文详解在Python脚本中接收命令行参数的三种主流方式:sys.argv基础解析、argparse高级解析以及TensorFlow提供的tf.app.run封装。通过对比三者的代码实现、参数类型处理及默认行为,帮助开发者根据项目需求选择最合适的参数传递方案,特别指出了argparse与tf.app在布尔值及命名解析上的差异。