
TensorFlow 显存管理:按比例分配与自适应增长配置指南
本文详解在 TensorFlow 中通过 ConfigProto 配置 GPU 显存占用策略。涵盖按比例固定分配(per_process_gpu_memory_fraction)与自适应增长(allow_growth)两种模式,并介绍如何利用 CUDA_VISIBLE_DEVICES 环境变量在多台 GPU 环境中指定计算设备,帮助优化内存使用并避免 OOM 错误。
2026-10-13
6


本文详解在 TensorFlow 中通过 ConfigProto 配置 GPU 显存占用策略。涵盖按比例固定分配(per_process_gpu_memory_fraction)与自适应增长(allow_growth)两种模式,并介绍如何利用 CUDA_VISIBLE_DEVICES 环境变量在多台 GPU 环境中指定计算设备,帮助优化内存使用并避免 OOM 错误。
本文通过TensorFlow代码示例,深入解析梯度下降法中var_list参数的作用。默认情况下,优化器会同时更新权重矩阵W([784,10])和偏置b。实验对比显示,若仅更新权重W,模型准确率约为0.9187,影响有限;而若仅更新偏置b,准确率骤降至0.1135,效果显著变差。这证明了在Softmax回归中,合理分配W和b的更新策略对模型性能至关重要。
本文详细介绍 TensorFlow 中函数求导与梯度计算的具体实现方法。内容涵盖使用 eager execution 进行一阶导数计算、通过嵌套梯度函数求解高阶导数,以及利用 GradientTape 持久化特性处理多变量函数的二阶偏导数。通过完整代码示例,展示如何获取函数值及其各阶导数值,适用于机器学习模型训练中的自动微分场景。
本文介绍如何将TensorFlow保存的CKPT格式模型权重导出为H5文件,以便兼容Caffe、Keras等其他框架。通过tf.train.NewCheckpointReader读取CKPT文件,结合h5py库遍历变量并写入H5格式,实现跨框架模型权重的迁移与复用。
本文介绍如何利用TensorFlow加载.pb格式的预训练模型,并通过Python脚本提取其计算图结构。通过配置SummaryWriter将图信息写入日志目录,随后启动TensorBoard服务,用户可在浏览器中直观查看模型的所有网络节点及连接关系,适用于模型调试与结构分析。
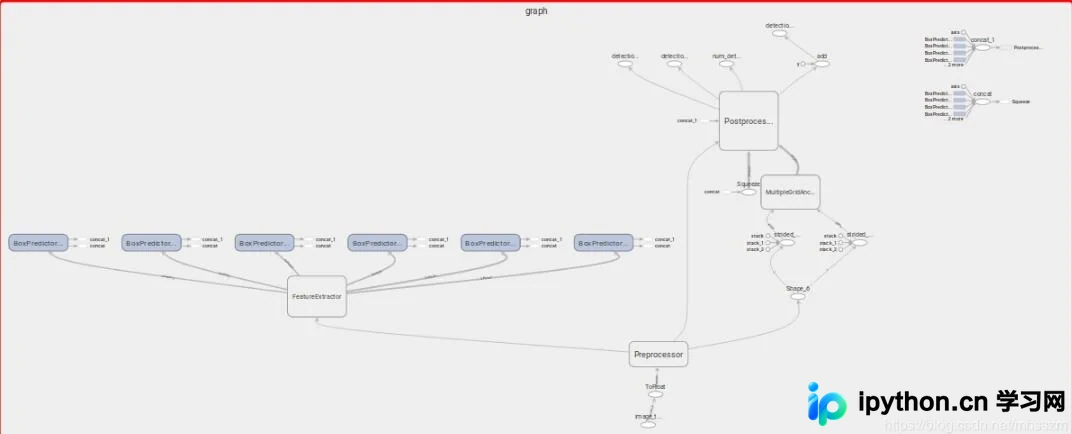
本文介绍如何利用TensorFlow和TensorBoard查看模型图结构。通过Python代码加载Graph定义并保存为事件文件,随后在Anaconda环境中启动TensorBoard服务。重点解决Windows路径斜杠导致的Graph不显示问题,指导用户在浏览器中访问本地端口查看可视化结果。
本文介绍如何在 TensorFlow 中加载 .pb 格式的冻结模型文件,并通过遍历 GraphDef 节点列表来打印所有节点名称。提供了基于 Python 的完整代码示例,适用于模型结构分析与调试场景。
本文介绍通过 Conda 工具安装 TensorFlow GPU 版本的简便方法。该方法无需手动下载和配置 NVIDIA CUDA 及 cuDNN 库,Conda 会自动处理相关依赖。教程涵盖从 Anaconda 安装、Python 环境创建、激活到验证 TensorFlow 成功加载的完整步骤,适合希望简化深度学习环境搭建的用户。
TensorFlow基于静态图机制,直接print无法查看张量数值。本文详解tfPrint函数的参数用法,重点解析如何在未返回主函数的内部函数中利用数据流机制输出中间变量。通过对比不同代码结构,阐明tfPrint节点被触发执行的条件:只有当数据流经该节点时才会打印,且受first_n和summarize参数限制。
本文介绍在TensorFlow中通过生成带权重的PB文件或冻结CKPT文件,利用get_tensor_by_name函数获取指定层输出的方法。通过加载模型图定义并导入数据,可提取中间层特征值并保存至文本文件,适用于模型调试与分析。
本文介绍如何使用TensorFlow查看CKPT文件中各节点变量的名称。通过Python脚本读取模型文件,获取变量到形状映射,并打印出所有节点名称。
本文详解TensorFlow中如何处理长度不一的变长数据(如语音、视频或NLP样本)。通过对比直接padding写入与使用padded_batch方法,重点解析padded_batch的参数配置及tf.VarLenFeature配合sparse_tensor_to_dense的使用,结合MNIST示例展示完整代码实现。