

Python遍历含汉字字符串的正确方法:编码与Unicode处理
本文详解Python中遍历含汉字字符串时因编码不同导致的字符长度差异。分析UTF-8(3字节)与GBK(2字节)环境下直接遍历的问题,提供通过切片按字节读取的方法,并推荐将字符串转换为Unicode格式以实现统一字符遍历的最佳实践。
2026-10-13
6

本文详解Python中遍历含汉字字符串时因编码不同导致的字符长度差异。分析UTF-8(3字节)与GBK(2字节)环境下直接遍历的问题,提供通过切片按字节读取的方法,并推荐将字符串转换为Unicode格式以实现统一字符遍历的最佳实践。
本文详解Python中字符串的多种定义方式,包括单引号、双引号及三引号的使用场景。重点解析自然字符串(Raw String)忽略转义的特性,以及利用反斜杠、括号实现多行字符串拼接的技巧,配合代码实例展示字符串自动连接与格式化输出的具体效果。
本文深入解析 Python Beautiful Soup 库的搜索功能,涵盖 find() 与 find_all() 的核心用法。详细讲解如何通过标签名、属性、文本及正则表达式精准定位元素,并演示处理自定义属性和 CSS 类属性的技巧。此外,还介绍了利用父级、同级及下级标签进行关联搜索的高级策略,帮助开发者高效提取网页数据。
本文详细介绍Python中Beautiful Soup模块修改HTML/XML文档的方法。涵盖修改标签名称与属性、添加新标签、修改及删除字符串内容、移除节点以及使用wrap/unwrap等方法包裹或解包标签。通过具体代码示例,帮助开发者掌握动态修改网页内容的技巧。
本文通过Python中re.split函数的实际运行结果,解析了正则表达式中括号分组对匹配结果的影响。当使用带括号的模式如'(\W+)'时,分组内的匹配内容会被单独提取并保留在返回列表中,导致非单词字符出现在结果里。对比无括号模式可知,这是正则表达式标准行为,旨在允许用户获取分隔符信息。
本文介绍如何利用Python的re库进行简单的字符串匹配。通过构建正则表达式模式并编译为对象,调用其方法即可获取匹配结果。文章结合具体代码示例,展示了从导入模块到打印匹配内容的完整流程,适合数据分析与算法工作者参考。
本文详细介绍 Python 中如何使用反斜杠处理特殊字符,列出常用转义字符及其功能。同时讲解如何利用 r 或 R 前缀定义原始字符串,使转义字符失效以显示原始内容,适用于需要精确输出字符串的场景。
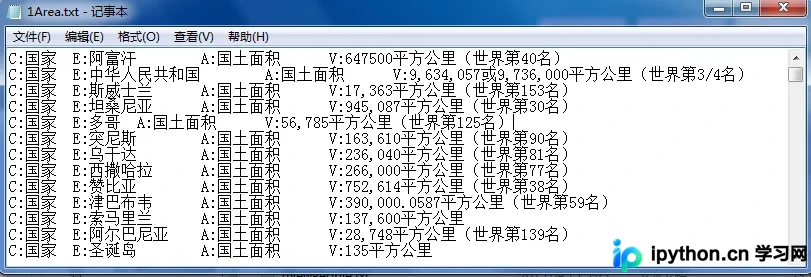
本文介绍Python中列表的基础操作,重点讲解二维列表的排序方法。通过对比list.sort()与sorted()的区别,演示如何利用lambda表达式按指定关键字排序。同时,结合从TXT文件读取国土面积数据的实例,详细阐述字符串清洗、正则匹配及数值转换技巧,帮助读者掌握实际数据处理流程。
本文介绍了Python中字符串(str)与字节数组(bytes)相互转换的几种常用方法。主要包含使用内置函数bytes()和str()进行转换,以及利用str.encode()和bytes.decode()方法进行编码和解码操作。通过具体示例展示了如何在UTF-8编码下实现两者的无缝转换,帮助开发者处理文本与二进制数据间的交互问题。
本文详解Python标准库string模块中的字符串常量,并深入剖析Template类的用法。通过对比Template、%格式化及format()方法,展示Template类的优势。重点讲解如何通过继承Template类并重写delimiter和idpattern属性,利用正则表达式自定义变量名匹配规则,实现更灵活的字符串模板替换。
本文介绍Python中字典与字符串相互转换的两种常见方式。字典转字符串可通过遍历元素拼接实现;字符串转字典则推荐使用eval或exec函数解析。文章提供了具体代码示例及操作技巧,帮助开发者快速掌握相关数据处理方法。
本文介绍Python中两种常用的字符串截取方法:利用split函数按分隔符分割提取,以及通过切片操作结合rfind定位提取。通过具体代码示例演示如何从完整URL路径中精准获取文件名及去除后缀,帮助开发者快速掌握字符串处理技巧。