

Python中输出整数的两种实现方式
本文介绍Python中输出整数的两种常用方法。第一种通过str()将数字转为字符串并检查是否包含小数点来筛选整数;第二种利用浮点数精度格式化(如%.0f)实现四舍五入输出。文章包含具体代码示例及执行结果分析,帮助开发者根据需求选择合适方案。
2026-10-14
6

本文介绍Python中输出整数的两种常用方法。第一种通过str()将数字转为字符串并检查是否包含小数点来筛选整数;第二种利用浮点数精度格式化(如%.0f)实现四舍五入输出。文章包含具体代码示例及执行结果分析,帮助开发者根据需求选择合适方案。
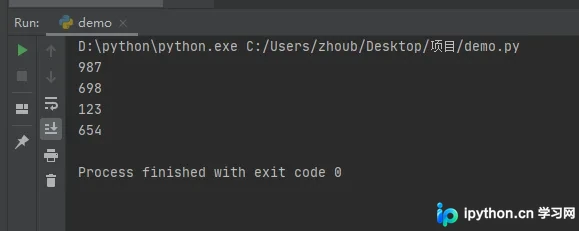
本文详细介绍Python中字符串的大小写转换与判断方法。重点解析upper()、lower()和title()三个核心函数的功能与返回值机制,涵盖全大写、全小写及首字母大写的转换逻辑。同时介绍isalnum()、isalpha()等字符串判断方法,帮助开发者高效处理文本数据。
本文详解Python中数字、字符串、列表、字典及元组的空值初始化方式,重点辨析None与空字符串的区别。通过代码示例说明None是特殊常量Nonetype,而空字符串为str类型,两者在布尔判断中均视为False,但比较方式不同,帮助开发者正确选择初始化方案。
本文系统梳理Python爬虫的核心知识点,涵盖从Python基础语法、urllib/urllib2网络请求库,到正则表达式数据提取,再到Scrapy高级框架的完整学习路径。同时解析爬虫背后的HTTP请求、DNS解析及服务器响应机制,帮助初学者建立完整的爬虫知识体系。
本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
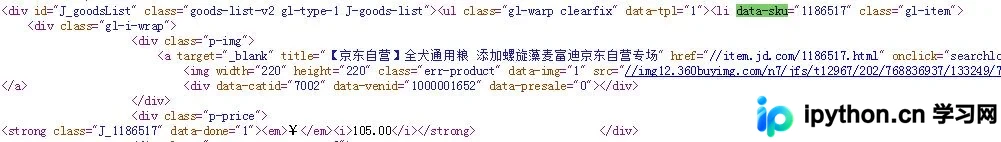
本文详解使用Python实现密码验证程序的完整思路。程序需处理多行输入,对每行密码进行三项核心校验:长度必须超过8位;需包含大小写字母、数字及特殊符号中的至少三种;严禁存在长度超过2的重复子串。通过结合循环遍历与正则表达式,可有效判断密码是否符合规范并输出OK或NG结果。
本文介绍如何使用Python脚本批量去除指定文件夹中所有Python文件的注释。通过结合正则表达式匹配单行及多行注释,并读取INI配置文件指定源与目标路径,实现自动化清理。脚本支持忽略特定格式的注释行,并将处理后的文件保存至新目录,适用于代码优化或清理场景。
本文深入解析Python中四种字符串格式化方式:传统的%运算符、str.format()方法、Python 3.6引入的f-string以及Template类。通过对比各方法的语法特性、优缺点及适用场景,帮助开发者根据代码可读性、性能和维护需求选择最佳方案,特别推荐在Python 3.6+环境中优先使用f-string。
本文详解Python串口通信中数据格式转换方法。通过Pyserial库,演示如何将十六进制指令转为bytes发送,以及利用binascii模块将接收到的十六进制数据还原为字符串或明文。涵盖encode、hex编码及ASCII解析等核心操作,解决串口调试中数据可视化的难题。
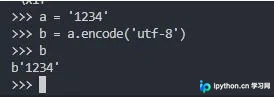
本文详解Python中Unicode字符串与普通字符串的相互转换方法,包括encode与decode的具体用法。同时提供利用json模块解决Python列表输出时Unicode编码未正确显示为中文的问题,通过设置ensure_ascii=False实现格式化输出,并介绍如何反向解析恢复数据。
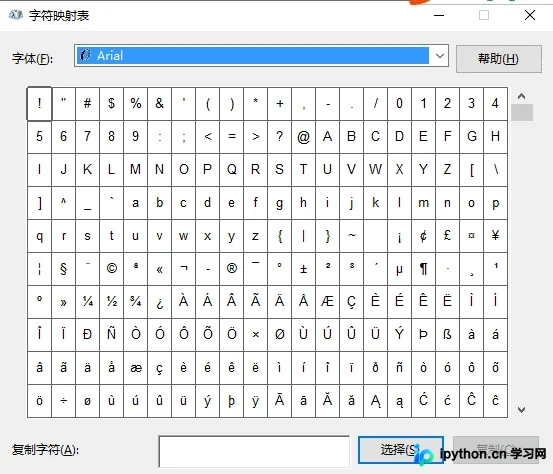
本文介绍了在Python中打印特殊符号的两种方法。一是通过Windows系统自带的字符映射表(charmap)查找并输入符号;二是利用Python内置的chr()函数,根据Unicode编码值直接打印出如Σ、箭头及❋等特定符号。
本文详细介绍 Python 3.6 引入的 f-string 字符串格式化功能。通过具体示例演示如何在 f-string 中指定字段宽度、实现左对齐与右对齐、控制小数点后位数以及使用零填充不足位数的方法,帮助开发者编写更直观、整洁的代码。