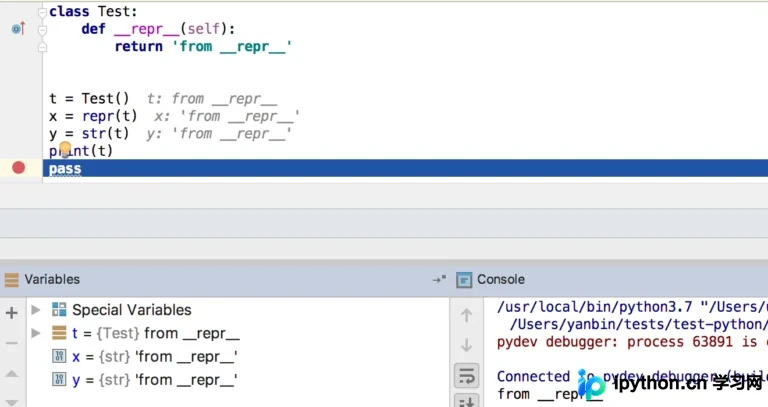
Python 中 __str__ 与 __repr__ 方法的区别与调用机制详解
本文深入解析 Python 中 __str__ 和 __repr__ 两个魔术方法的定义与调用时机。通过对比内置类型与自定义类的行为,阐明 repr 作为正式表示在调试和交互环境中的优先级,以及 str 在用户友好输出中的作用。文章还探讨了当仅定义其中一个方法时的回退机制,以及字符串格式化、print 和调试器显示的具体调用逻辑,帮助开发者正确实现对象的可读性与可重现性。
2026-10-14
6

本文深入解析 Python 中 __str__ 和 __repr__ 两个魔术方法的定义与调用时机。通过对比内置类型与自定义类的行为,阐明 repr 作为正式表示在调试和交互环境中的优先级,以及 str 在用户友好输出中的作用。文章还探讨了当仅定义其中一个方法时的回退机制,以及字符串格式化、print 和调试器显示的具体调用逻辑,帮助开发者正确实现对象的可读性与可重现性。
本文介绍如何使用Python正则表达式自动从非结构化文本中提取时间信息,重点解决dateutil和datefinder模块对中文及特殊格式支持不足的问题。通过自定义正则模式匹配,实现了对中文年月日、相对时间(如“3小时前”)及多种分隔符格式的精准识别,并附带完整测试用例与运行结果分析。
本文整理了Python标准库中9个常被忽视但极具实用价值的技巧。涵盖字符串规范化、迭代器切片与跳过、关键字参数限制、上下文管理器实现、内存优化(__slots__)、CPU与内存限制、模块导出控制及比较运算符简化。这些技巧均基于标准库,无需第三方依赖,能显著提升代码质量与执行效率。
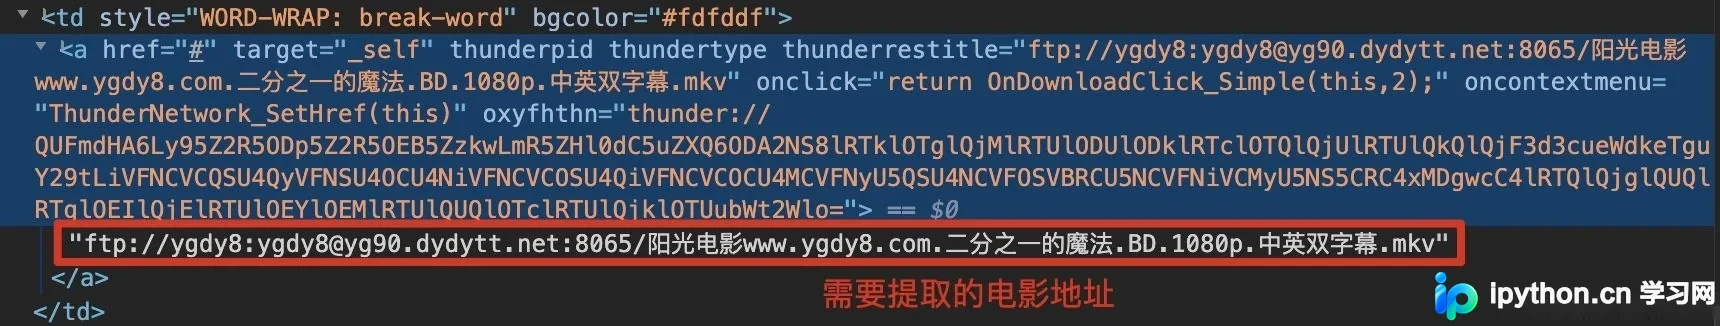
本文介绍如何利用 Python 的 re 和 requests 模块,通过正则表达式从网页 HTML 中快速提取电影 FTP 下载地址。相比繁琐的标签遍历,正则匹配能显著减少代码量并提高提取效率。文章包含完整的代码示例、编码处理技巧及运行结果分析,帮助开发者掌握高效的网页信息抓取方法。
本文深入解析Python中print()函数使用的%格式化输出机制。详细讲解转换说明符(如%d、%s、%f)作为占位符的工作原理,以及如何通过指定最小输出宽度、对齐方式(左/右/居中)和小数精度来精确控制输出格式。包含整数、浮点数及字符串的具体代码示例与执行结果分析,帮助开发者掌握Python早期的字符串格式化技巧。
本文介绍Python中将字符串转换为datetime对象的标准方法,重点分析strptime在大量数据处理时的性能瓶颈,并提供一种基于字符串分割的自定义解析函数。实测表明该方案比内置方法快7倍以上,适合对日期处理性能有严格要求的场景。
本文详解Python中正则表达式的贪婪匹配机制及其导致的错误结果,通过引入问号修饰符将模式转换为非贪婪模式,从而精确获取分隔符间的最短文本。文章提供具体代码示例与原理分析,帮助开发者避免常见匹配陷阱,提升正则处理的准确性。
本文详细介绍PyCharm中的多种全局搜索方式,包括按文件名搜索文件的Ctrl+N、搜索所有类型文件的Ctrl+Shift+N(支持路径搜索)、全局字符串查找Ctrl+Shift+F(Find in Path)以及综合搜索的双Shift。内容涵盖快捷键冲突解决、精细设置选项及双Shift的多功能汇总特性,帮助开发者高效定位代码资源。
本文详解 Python 中正则表达式处理多行文本的常见陷阱。当使用点号(.)匹配任意字符时,默认无法匹配换行符。文章介绍了两种解决方案:一是通过非捕获组(?:.\n)显式包含换行符;二是利用 re.compile 的 re.DOTALL 标志,使点号能匹配包括换行符在内的所有字符。同时对比了两种方法的适用场景,建议复杂模式优先使用标志位以提高代码可读性和维护性。
本文详细解析Python中字符串方法strip()的工作原理。该函数用于移除字符串头部和尾部的指定字符或序列,默认去除空白符。通过具体代码示例,展示了不带参数及带参情况下的不同处理逻辑,强调其仅作用于首尾且忽略顺序的特性,帮助开发者准确掌握字符串清洗技巧。
本文介绍Python中字符串的upper()方法,该方法用于将字符串中的所有小写字母转换为大写字母。文章详细说明了其语法结构、参数说明(无参数)、返回值类型,并通过具体代码实例展示了upper()函数的实际调用方式与输出结果,帮助开发者快速掌握字符串大小写转换的基本操作。
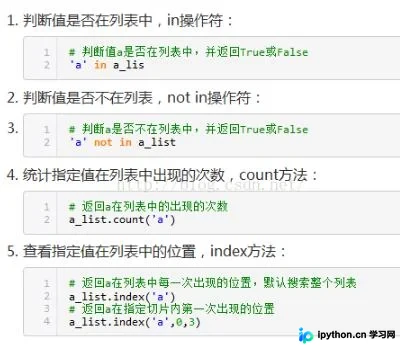
本文详解Python中查找列表元素的五种方式。首先介绍保留字in/not in及列表方法count、index和字符串find的区别。重点分析index抛出ValueError的处理,推荐使用in预检或try/except。针对多次出现的情况,演示利用enumerate、itertools.count及NumPy获取所有索引的高效写法,并提供性能对比与完整代码示例。