

Python使用re模块爬取豆瓣Top250电影实战指南
本文详细介绍使用Python爬取豆瓣电影Top250的完整流程。通过requests发送请求并设置User-Agent避免封禁,利用re模块正则表达式精准提取电影名称、评分及评价人数,最后将结果保存至本地文件。代码包含完整的请求、解析与保存逻辑,适合Python初学者学习网络爬虫基础。
2026-10-14
6

本文详细介绍使用Python爬取豆瓣电影Top250的完整流程。通过requests发送请求并设置User-Agent避免封禁,利用re模块正则表达式精准提取电影名称、评分及评价人数,最后将结果保存至本地文件。代码包含完整的请求、解析与保存逻辑,适合Python初学者学习网络爬虫基础。
本文深入解析Python中的字符串Intern(驻留)机制,解释其通过共享不可变对象提升性能的原理。重点探讨自动Intern的限制条件,如仅包含字母、数字和下划线的短字符串(通常小于20字符)会被自动驻留。同时对比Shell交互式环境与PyCharm等IDE在字符串处理上的差异,并分析编译期与运行期字符串拼接对Intern效果的不同影响。
本文介绍如何利用Python批量修改动漫视频文件名。通过导入os和re模块,结合正则表达式提取文件名中的集数信息,实现自动重命名。主要涉及os.listdir获取文件列表、os.chdir切换目录、os.path.abspath获取绝对路径以及os.rename执行重命名操作,适用于需要整理大量文件命名的场景。
本文介绍如何使用Python判断字符串中括号是否闭合。核心思路是利用列表模拟栈结构:遇到左括号入栈,右括号则与栈顶元素匹配并出栈。通过遍历字符串并检查最终栈是否为空,可验证括号对称性。文章提供完整代码示例,涵盖正确闭合、不对称及多余括号三种情况的处理逻辑。
本文详解Python中三种字符串格式化输出方式:传统的%占位符、Python 2.6引入的format方法以及Python 3.6引入的f-string。通过对比三者的语法特点、性能差异及适用场景,帮助开发者选择最适合的格式化方案,涵盖对齐、进制转换及表达式计算等进阶用法。
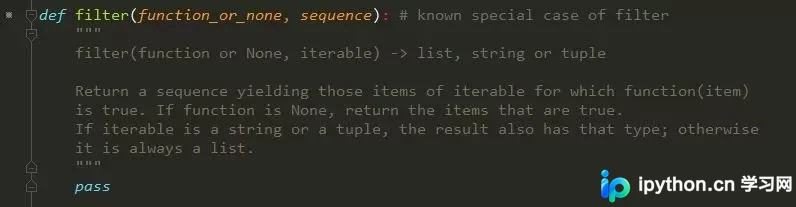
本文介绍如何在Python中实现类似Shell awk工具的多空格分割效果。默认split方法会将连续空格视为多个分隔符,导致结果包含空字符串。通过不加参数的split()或结合filter(None, ...)处理,可自动忽略多余分隔符,返回纯净的分段结果。
本文介绍了在Python中对文件列表进行排序的两种常用方法。首先演示使用sorted()函数按字符顺序排列文件名,适用于一般字符串排序场景;其次展示利用sort()结合lambda匿名函数,通过截取文件后缀名提取数字部分,实现按数字大小排序。文章包含具体代码示例及运行效果分析,帮助开发者处理如图片文件等需要特定排序逻辑的任务。
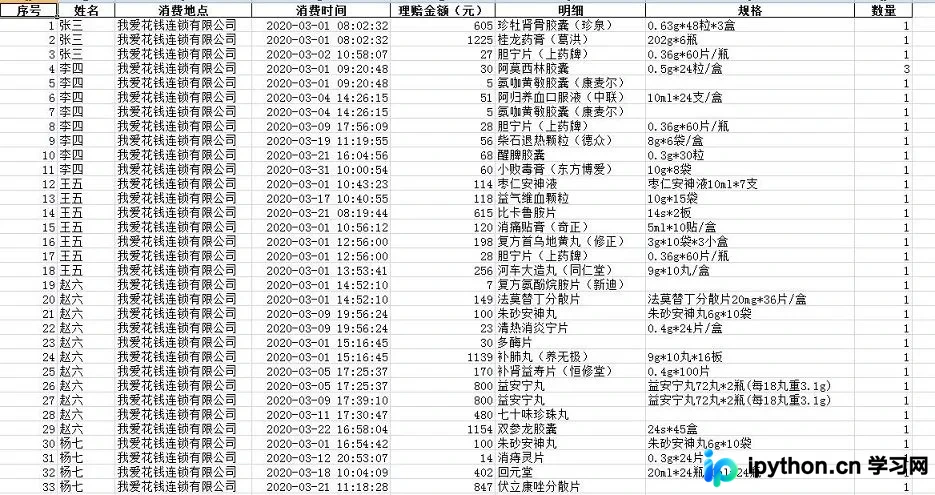
本文详细讲解Python Pandas库中extract和contains两个字符串处理方法的实际应用。通过具体代码案例,演示如何利用extract结合正则表达式从复杂字段中提取明细与规格,以及如何使用contains进行字符串模糊匹配与数据筛选,帮助开发者高效处理DataFrame中的文本数据。
本文深入解析Python中字符串搜索、替换及格式化的常用方法。重点介绍如何使用str.replace()处理简单模式,利用re.sub()结合正则表达式处理复杂文本替换,并通过re.IGNORECASE标志实现忽略大小写的匹配。此外,还涵盖了利用ljust/rjust/center及format()函数进行字符串对齐格式化的具体技巧,帮助开发者高效处理文本数据。
本文详细介绍在Python3中定义跨越多行字符串的三种常用方法。通过三引号保留换行符,利用反斜杠实现逻辑换行,以及使用小括号进行隐式连接。文章包含具体代码示例与f-string格式化应用,帮助开发者根据实际需求选择最合适的字符串处理方式。
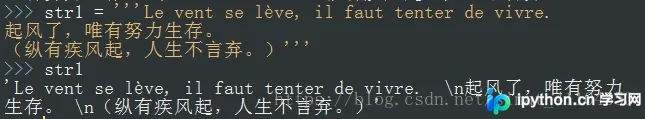
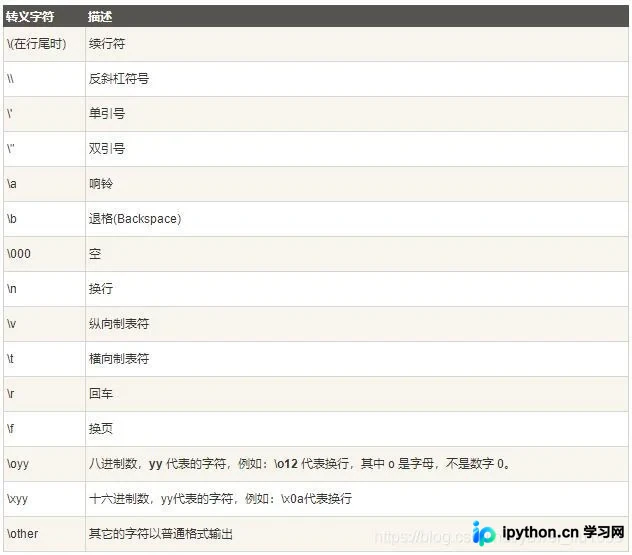
本文深入解析Python中的转义字符机制,详细讲解反斜杠\在定义换行、制表符及引号嵌套时的具体用法。通过对比直接引用与转义引用的差异,阐明如何避免语法错误。同时介绍使用双反斜杠\\表示普通反斜杠,以及利用原始字符串前缀r简化复杂转义序列的最佳实践,帮助开发者写出更清晰、健壮的字符串代码。
本文介绍如何在Python中判断一个字符串是否为合法的标识符。首先明确标识符需以字母或下划线开头,由字母、数字或下划线组成且非保留字。通过导入keyword模块获取保留字列表,结合字符串处理逻辑实现校验功能,并提供Python2与Python3的兼容代码示例及运行结果分析。