


在 PostgreSQL 16 中,UPDATE ... FROM 常被用来把一张表的数据回填到另一张表,但它最危险的地方恰恰在于:很多写法不会直接报错,而是悄悄产生错误结果。尤其是目标表重复出现在 FROM、漏写显式关联条件,或者一对多关系没有先收敛时,执行结果很容易偏离预期。
下面按实际写 SQL 时最容易踩坑的顺序来拆解这些规则:先看哪些写法在 PostgreSQL 16 中本身就不成立,再看为什么必须写清楚表间关联,接着说明 FROM 子查询的正确组织方式,最后给出一套更新前的验证方法,帮助你在正式执行前先确认影响范围和匹配唯一性。
目标表只能在 UPDATE 后声明一次
PostgreSQL 16 延续了旧规则:目标表只能在 UPDATE 关键字后声明,不能再出现在 FROM 子句里。
像下面这种写法:
UPDATE a FROM a JOIN b问题不在于语法看起来奇怪,而在于它可能不是直接报错,而是让你误以为 JOIN 生效了。根本原因是目标表 a 已经在 UPDATE 后声明过一次,再放进 FROM 中会形成自引用歧义。
在 PostgreSQL 16 里,FROM 中应该只放两类内容:
- 其他表
- 封装好的子查询或带别名的源结构
如果确实需要基于目标表自身的派生结果来更新,通常应先把那部分逻辑写进子查询或 WITH,再把它作为来源参与 FROM。
为什么必须显式写出关联条件
真正高风险的情况,是 UPDATE ... FROM 写出来能执行,但没有建立目标表与来源表之间的明确关系。
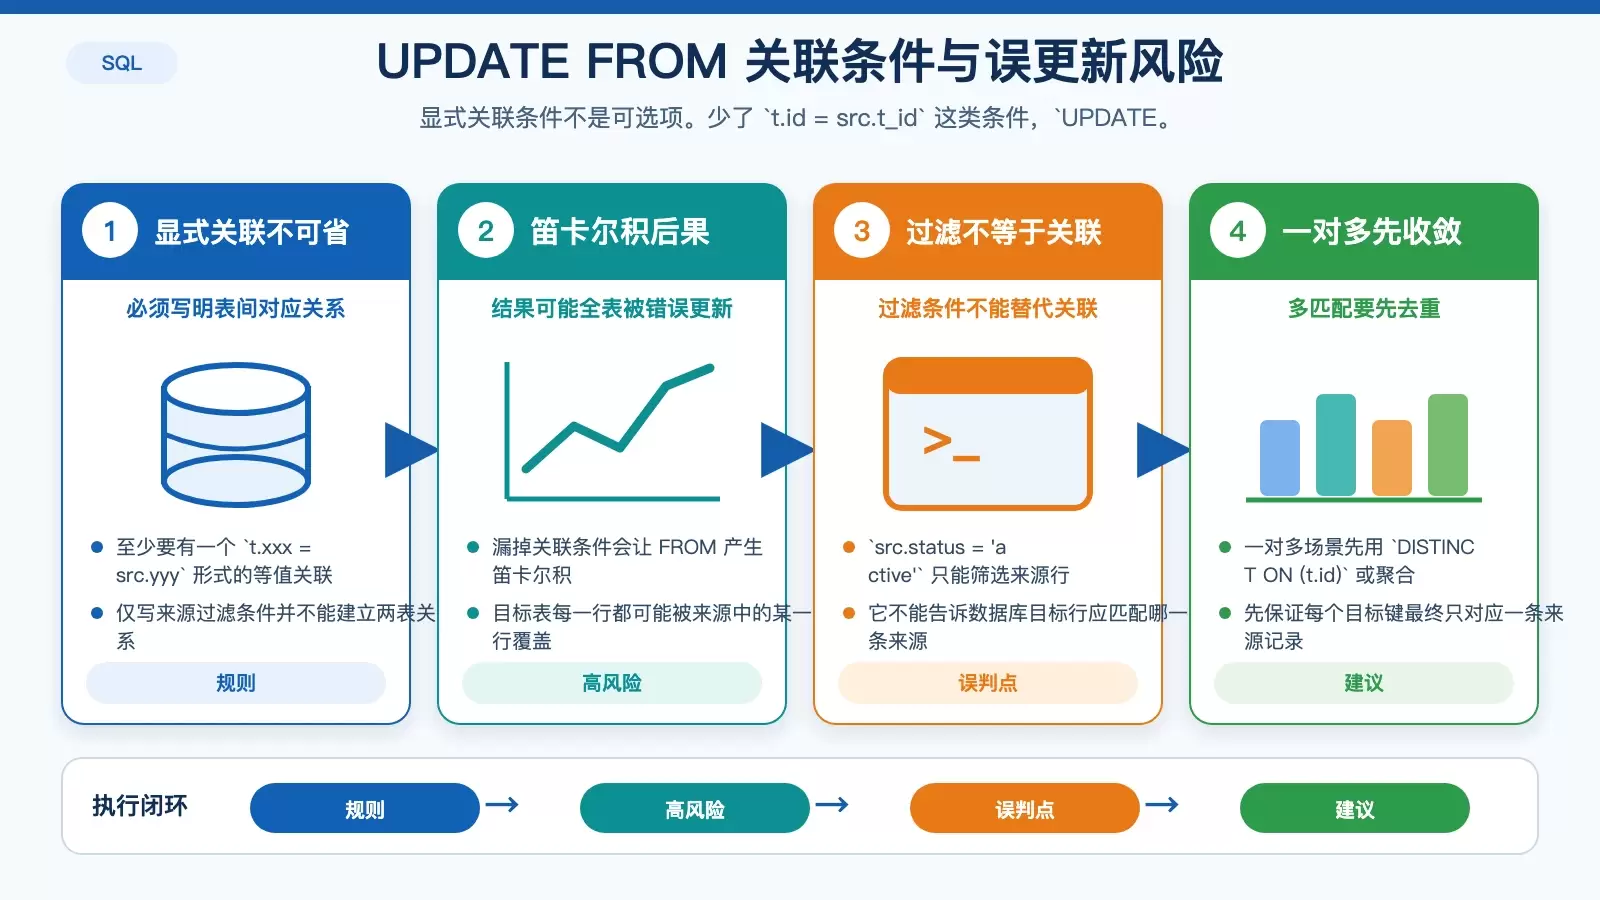
例如漏掉类似下面的条件:
WHERE t.id = src.t_id这时 FROM 子句会产生笛卡尔积,UPDATE 会把目标表的每一行都拿去和来源数据组合。最终结果通常是:目标表每一行都被更新成某一条来源记录的值,而返回结果却还是类似 UPDATE 1000,看上去像是一次正常更新。
这里要特别区分“过滤条件”和“关联条件”。
过滤条件不能替代表间关联
像 src.status = 'active' 这样的条件,只是在筛选来源数据,并没有建立两张表之间的对应关系。它可以缩小来源范围,但不能告诉 PostgreSQL “目标表这一行应该对应来源表哪一行”。
因此,WHERE 中至少要有一个明确的等值关联,例如:
t.xxx = src.yyy一对多匹配要先收敛
如果存在多对一或一对多关系,比如一个用户对应多条订单,那么即便你写了关联条件,更新结果仍然可能不稳定,因为目标表一行会匹配到多条来源记录。
这类场景建议先把来源结果收敛成“每个目标键只保留一行”,常见做法包括:
- 使用
DISTINCT ON (t.id) - 先做聚合后再参与更新
- 把来源逻辑提前整理到子查询或
WITH
FROM 里怎么放来源结构才是正确写法
FROM 后面本质上只能提供一个可解析的“源结构”。复杂来源可以存在,但最好被整理成明确的子查询或带别名的结构,而不是把逻辑摊平到难以辨认的层级里。
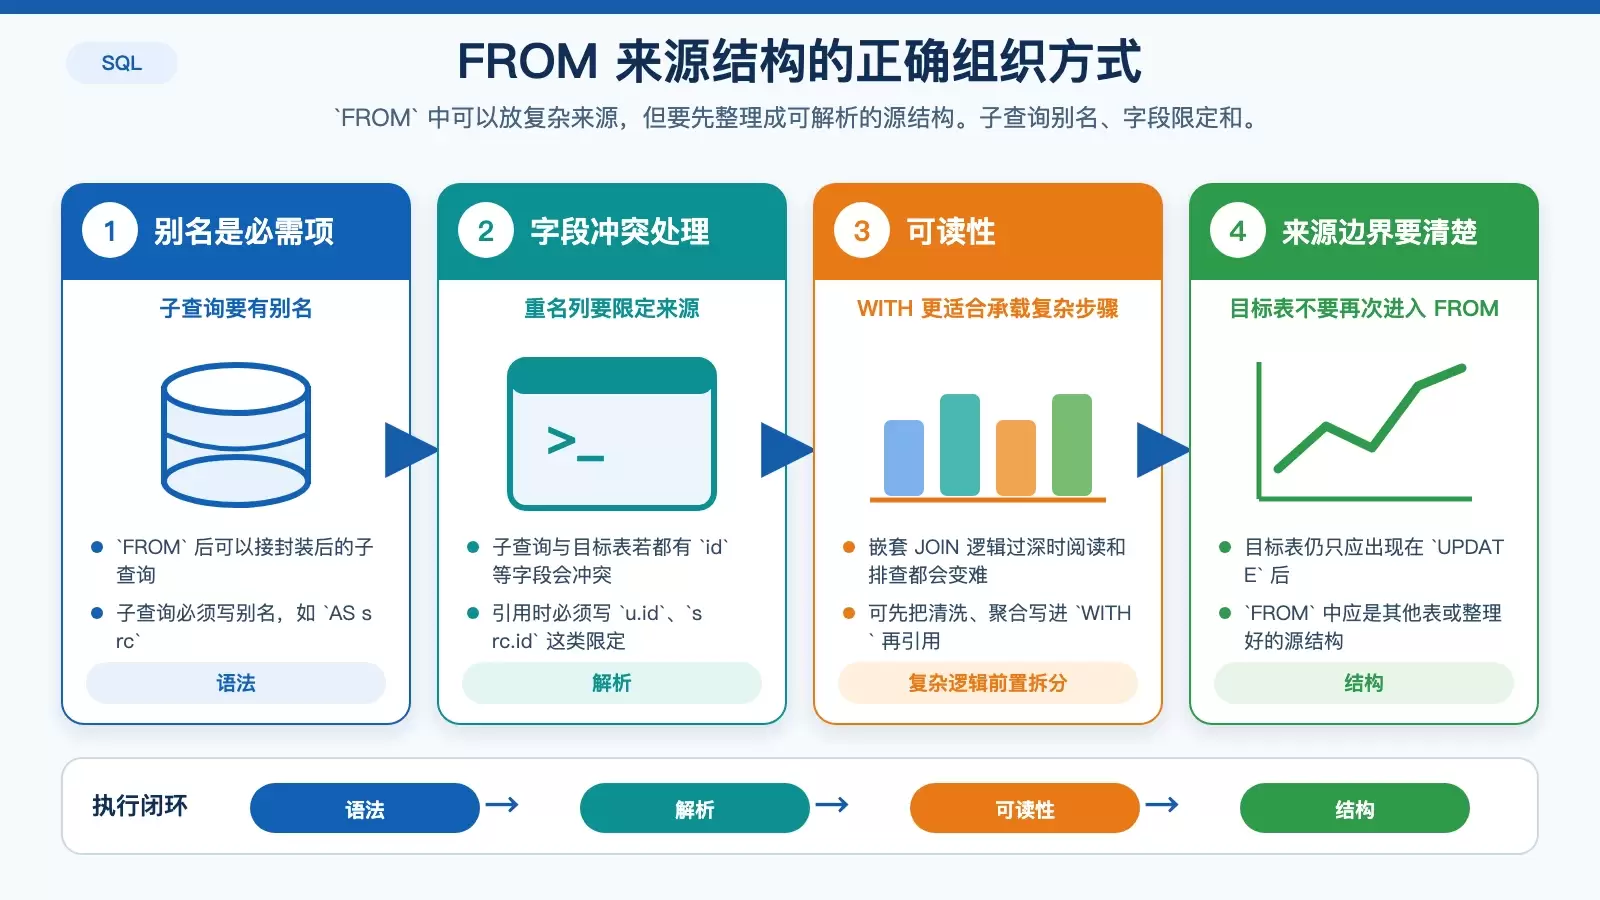
文中的推荐写法如下:
UPDATE users u
SET email = src.email, updated_at = NOW()
FROM (
SELECT user_id, email
FROM new_contacts
WHERE is_valid
) AS src
WHERE u.id = src.user_id;
这段 SQL 的关键点有三个。
子查询必须有别名
FROM 后如果接的是子查询,必须显式写别名,例如 AS src。否则会报错 missing FROM-clause entry。
重名字段必须限定来源
如果子查询和目标表里都有同名字段,例如都叫 id,那么引用时必须带上别名限定。否则 PostgreSQL 无法判断你指的是哪一列,解析就会失败。
复杂逻辑优先交给 WITH
当嵌套层级越来越深时,可读性会迅速下降。对于清洗、聚合、去重这类前置步骤,通常更适合先写进 WITH,再在 FROM 中引用整理好的结果。这样更容易检查每一步输出,也更方便后续排查问题。
更新前先改写成等价 SELECT 验证
验证更新范围最稳妥的方法,不是直接执行 UPDATE 看返回值,而是先把 FROM + WHERE 拆出来,改写成一条等价的 SELECT。
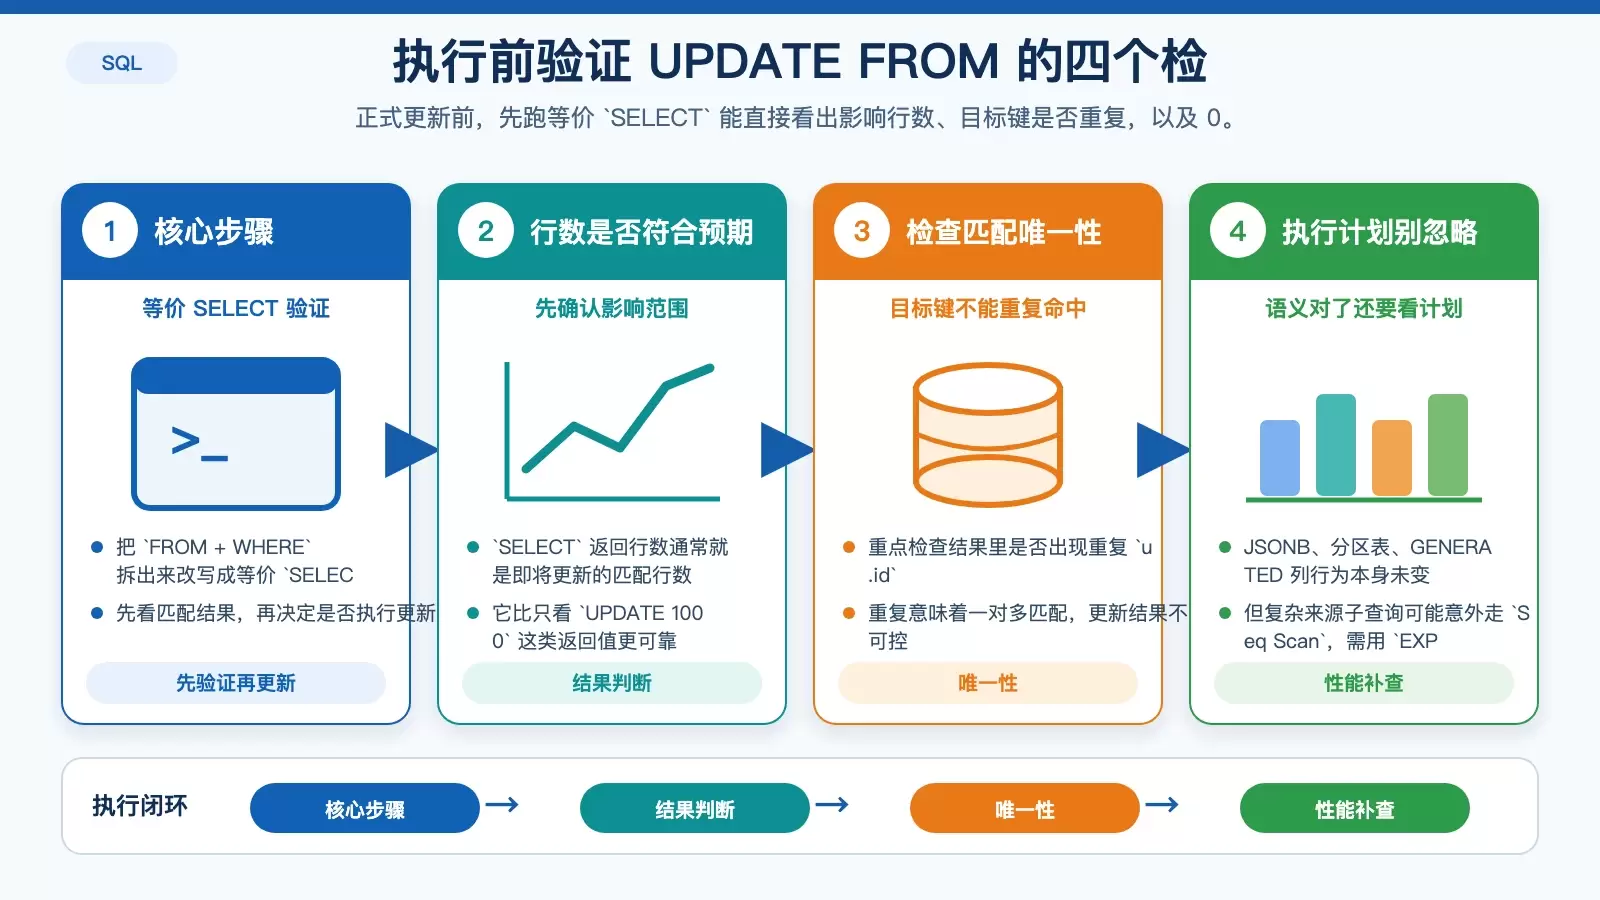
例如:
SELECT u.id, src.email
FROM users u
JOIN new_contacts src ON u.id = src.user_id
WHERE src.is_valid;
这一步能提前暴露大多数风险。
先看返回行数
这条 SELECT 返回多少行,通常就表示你的 UPDATE 将匹配到多少条记录。它是判断更新范围最直接的依据。
再查目标键是否重复
重点不是只有“有没有结果”,还要看目标键是否唯一。检查结果里是否出现重复的 u.id,如果有,说明存在一对多匹配,更新结果不可控,必须先做去重、聚合或收敛。
返回 0 行时优先排查关联条件和数据
如果 SELECT 返回 0 行,但你原本预期应该命中数据,问题通常不在 UPDATE 本身,而在关联条件或原始数据。例如:
- 关联键值本身不一致
- 存在
NULL,导致等值比较不成立 - 来源过滤条件过严
执行计划与特殊字段仍要额外留意
还有一个容易被忽略的点是:PostgreSQL 16 对 JSONB 字段、分区表和 GENERATED 列的更新行为本身没有变化,但如果你把这些特性放进 FROM 子查询里,执行计划可能意外走 Seq Scan。
这意味着 SQL 语义未必错,但执行代价可能与你预期不同。尤其是更新范围较大、来源子查询又比较复杂时,最好配合 EXPLAIN 看实际路径,确认没有因为子查询结构或条件写法而触发不理想的扫描方式。
写 UPDATE FROM 时可以按这份清单自查
- 目标表是否只在
UPDATE后出现一次 WHERE中是否写了明确的t.xxx = src.yyy关联- 一对多来源是否先用
DISTINCT ON (t.id)或聚合收敛 FROM子查询是否带了别名- 同名字段是否都加了表别名限定
- 正式更新前,是否已经跑过等价
SELECT验证行数和唯一性 - 复杂场景下,是否用
EXPLAIN检查了执行计划
对 PostgreSQL 16 来说,UPDATE ... FROM 的关键不在于语法是否能跑通,而在于你是否明确控制了“谁更新谁、按什么关系更新、每个目标键最终只对应几条来源记录”。把这些条件先验证清楚,才是避免误更新的真正办法。









