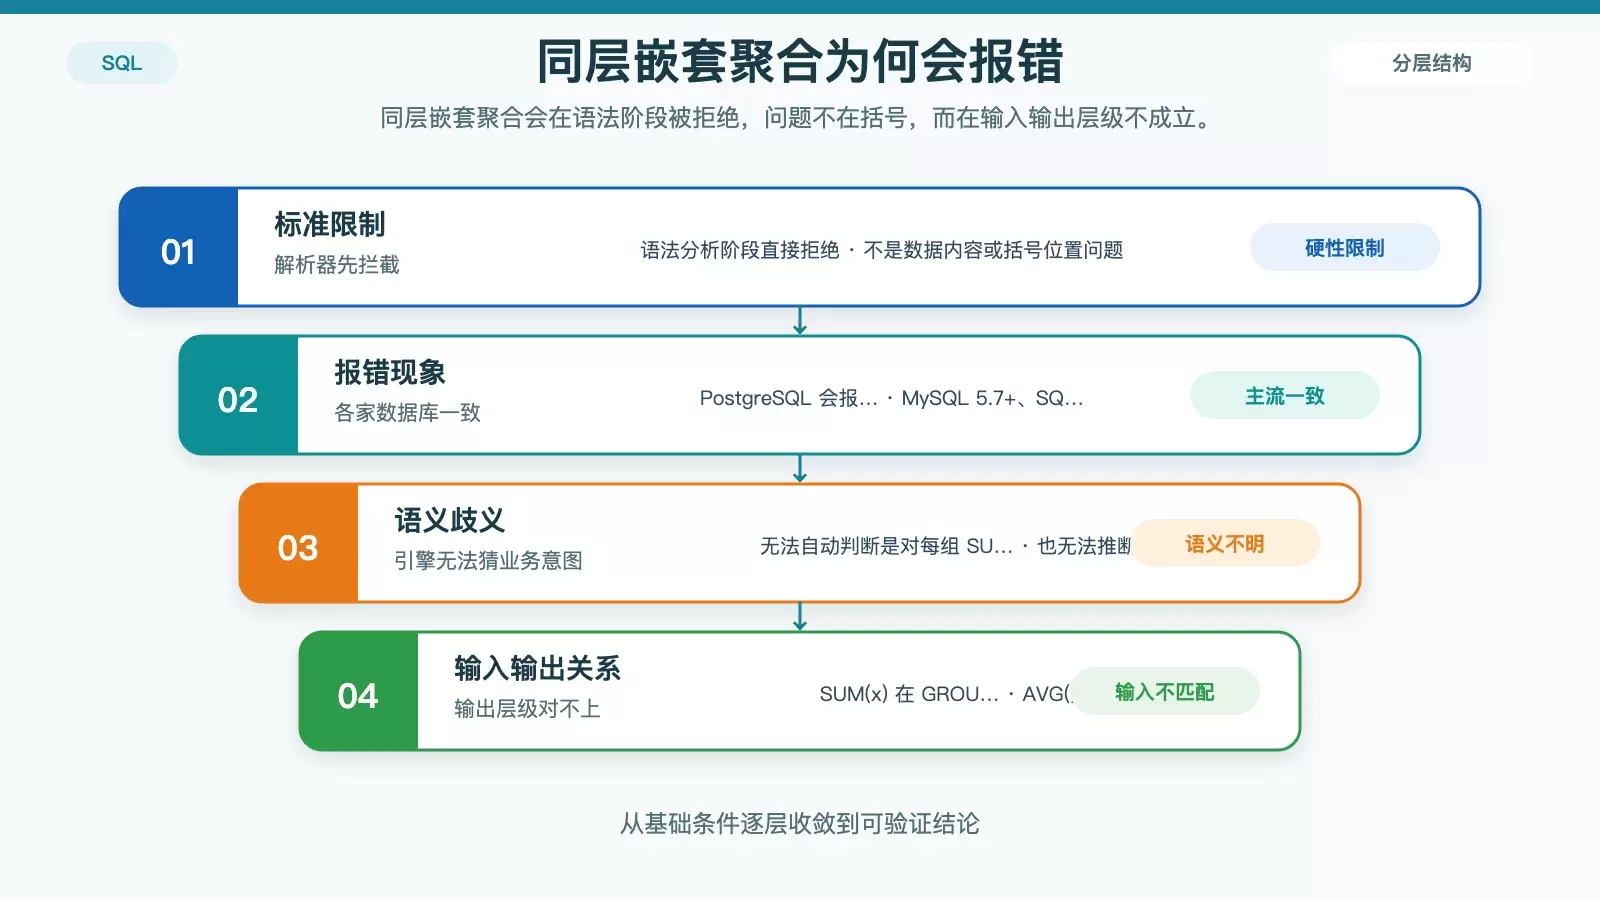
SQL 中聚合函数为什么不能直接嵌套使用?
SQL 里像 `AVG(SUM(x))` 这样的写法不是“括号套错了”,而是标准层面就被禁止。本文从语法限制、语义歧义、子查询与 CTE 的正确改写方式,再到窗口函数边界和平均值口径偏差,梳理为什么会报错,以及怎样写出结果可信的两层聚合查询。
2026-08-24
23

SQL 里像 `AVG(SUM(x))` 这样的写法不是“括号套错了”,而是标准层面就被禁止。本文从语法限制、语义歧义、子查询与 CTE 的正确改写方式,再到窗口函数边界和平均值口径偏差,梳理为什么会报错,以及怎样写出结果可信的两层聚合查询。
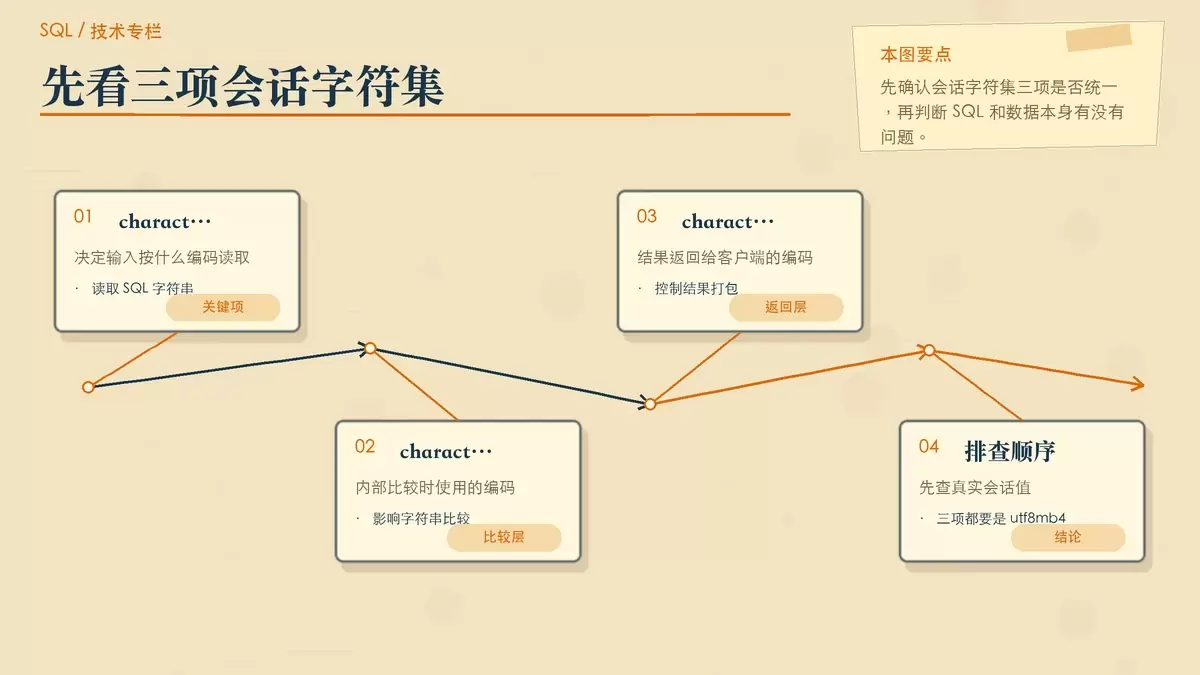
SQL JOIN 中文字段“看起来一样却匹配不上”,常见根因不在表结构,而在连接层字符集和校对规则不一致。本文按排查顺序梳理三项连接字符集、各语言连接写法、COLLATE 差异及错误修复方式,帮你快速判断问题到底出在连接、比较规则,还是存储层。
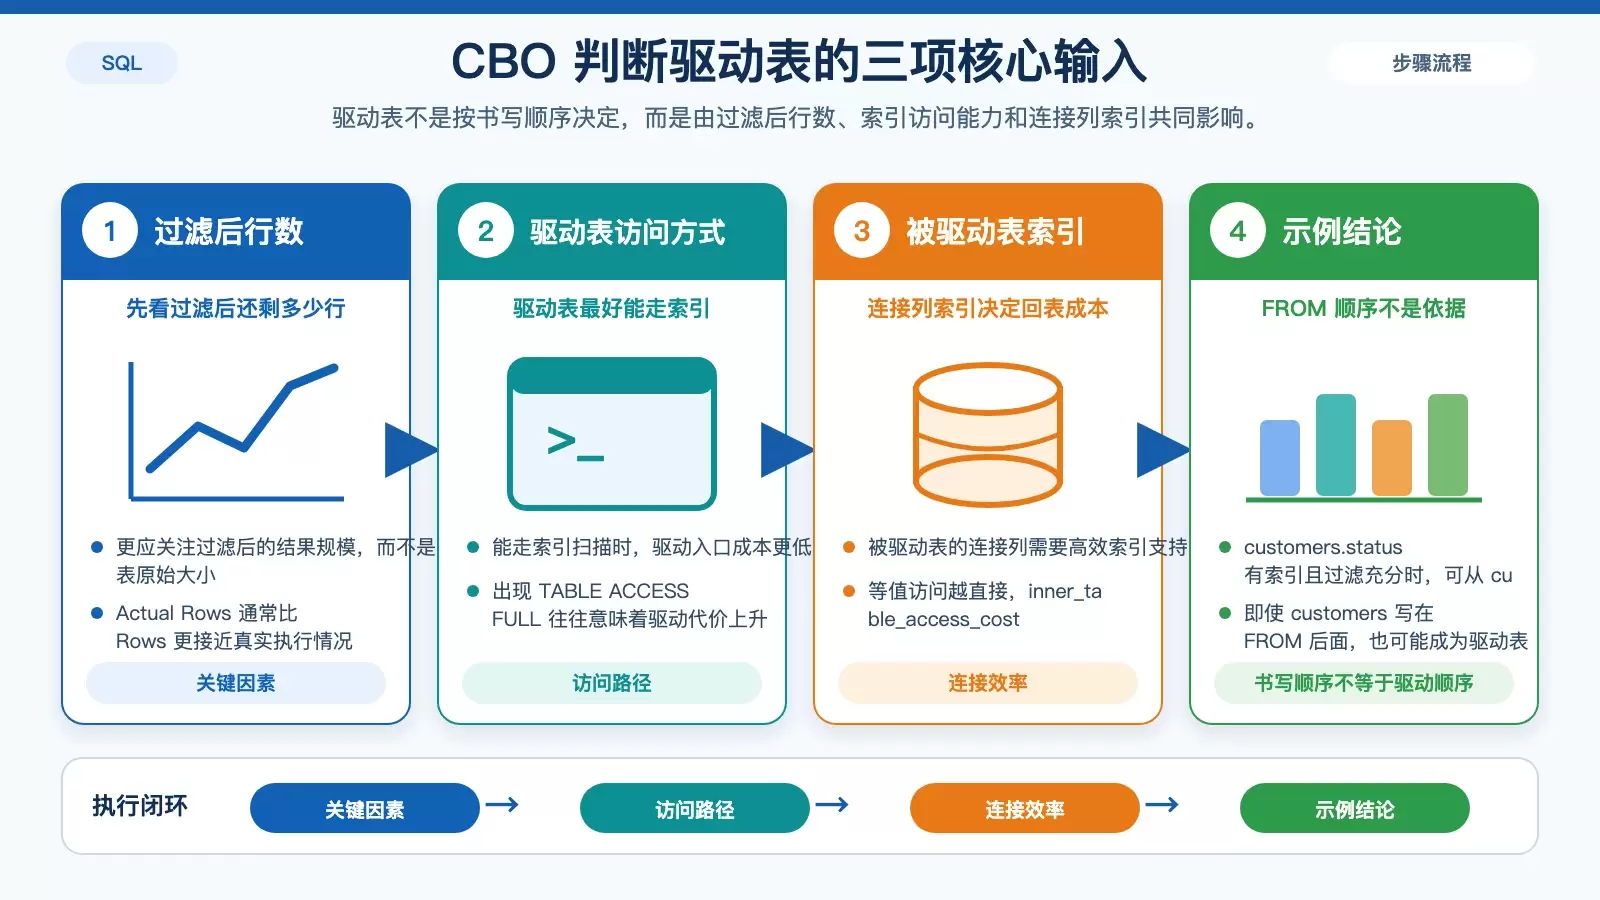
Oracle 19c 里的 SQL JOIN 驱动表并不是按 FROM 顺序决定,而是 CBO 根据统计信息、索引和过滤后行数计算成本后自动推导。本文从驱动表判断逻辑、LEADING 与 ORDERED 的差异、LEFT JOIN 的限制,以及执行计划验证方法四个方面,梳理实际调优时真正能动手的关键点。
WHERE 和 HAVING 都能“筛数据”,但作用对象和执行时机完全不同:前者筛原始行,后者筛分组结果。把条件写错位置,不仅容易报错,还会让聚合查询白白多做一轮计算,性能差距在大表上尤其明显。
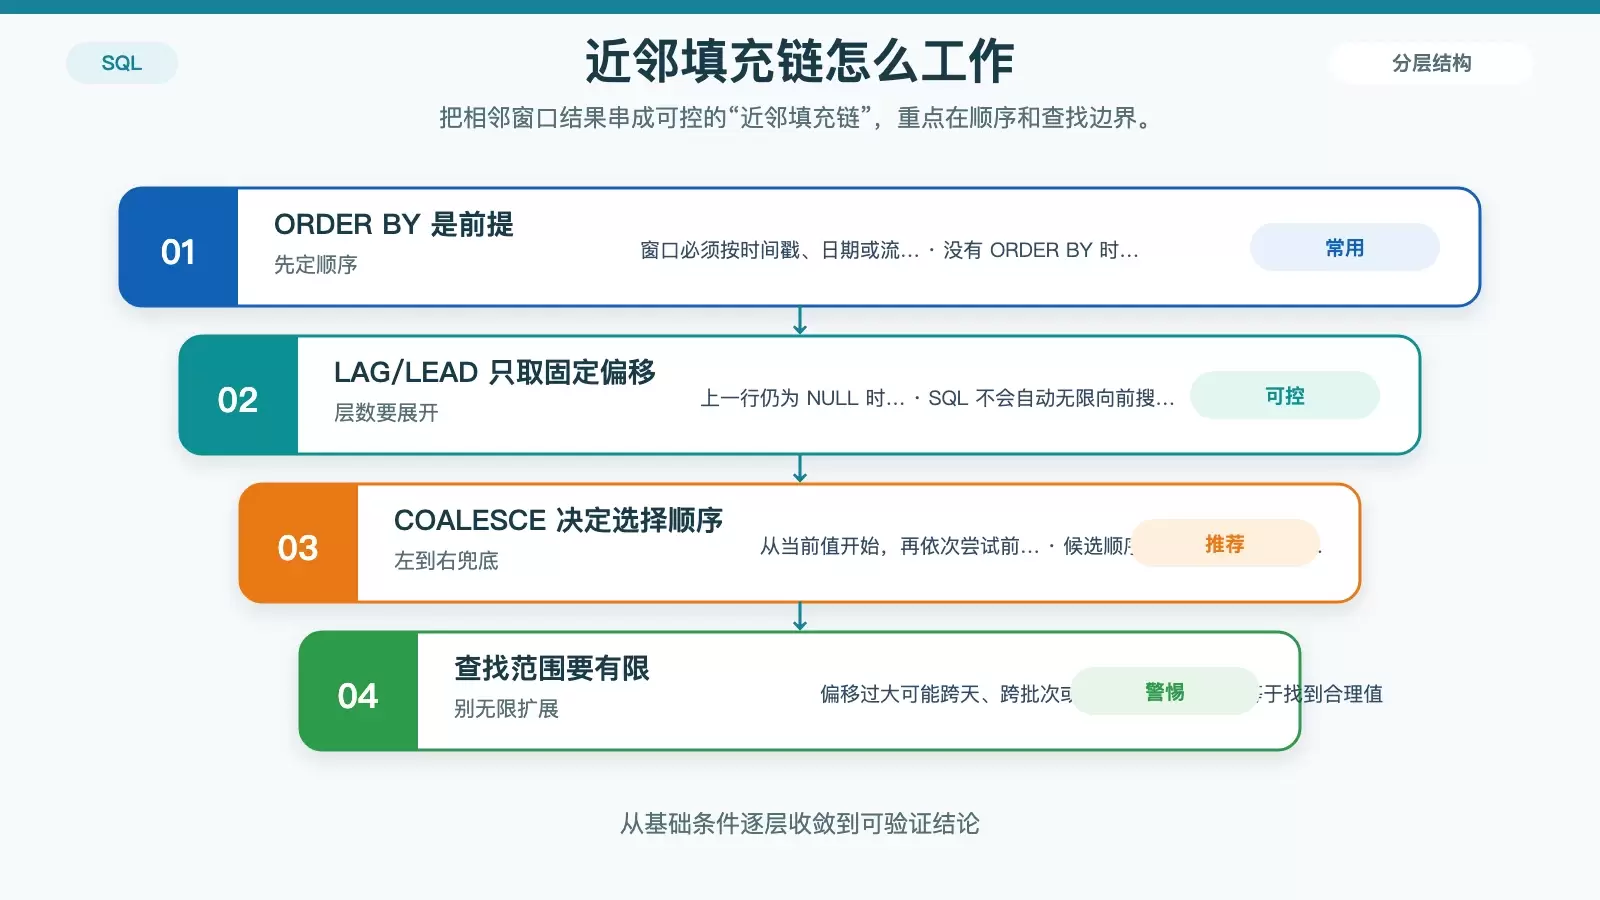
SQL 里填充缺失值,重点不是“补上就行”,而是按有序数据和业务语义选对方式。常见做法包括用 LAG()/LEAD() 取相邻有效值、用 COALESCE() 组合近邻候选,以及在支持 IGNORE NULLS 的数据库里用 FIRST_VALUE() 做前向填充。 在 SQL 里处理缺失值,最容易犯的错不是不会写函数,而是把“补出一个值”和“补对一个值”混为一谈。
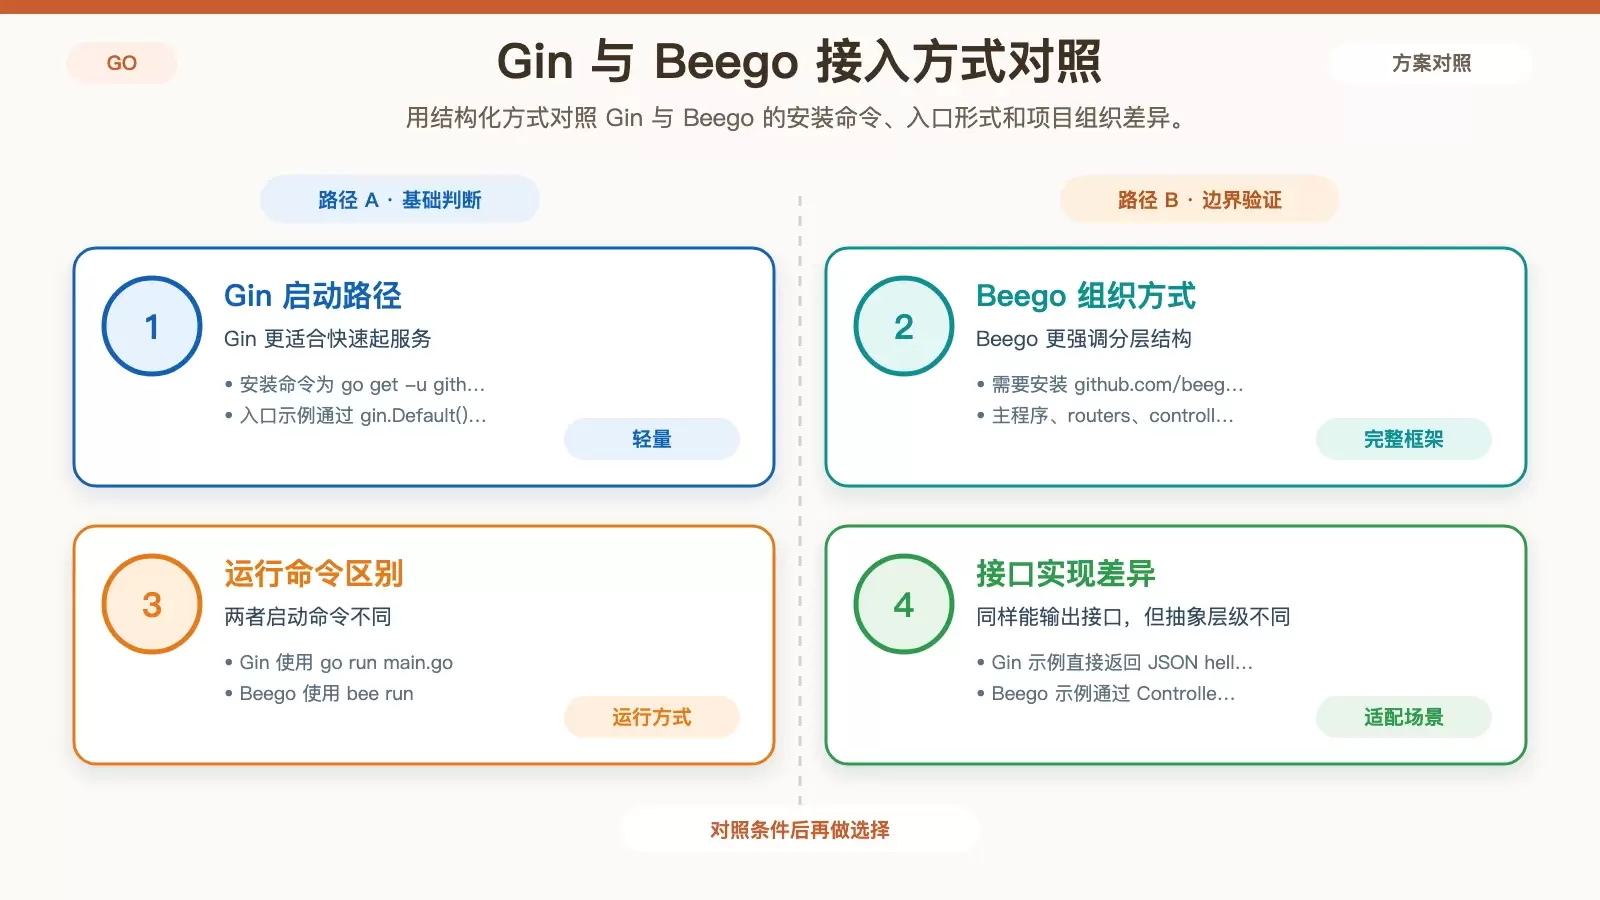
这篇文章从 Debian 上搭建 Go 开发环境开始,依次梳理环境变量配置、Gin 与 Beego 接入、PostgreSQL 与 MySQL 连接,以及 RabbitMQ 消息收发示例。适合想把 Go 服务端常见配套一次跑通的读者快速对照实践。 在 Debian 上搭一套可用的 Go 技术栈,难点通常不在某一条命令,而在于环境、Web 框架、数据库和消息队列要怎么顺下来接通。
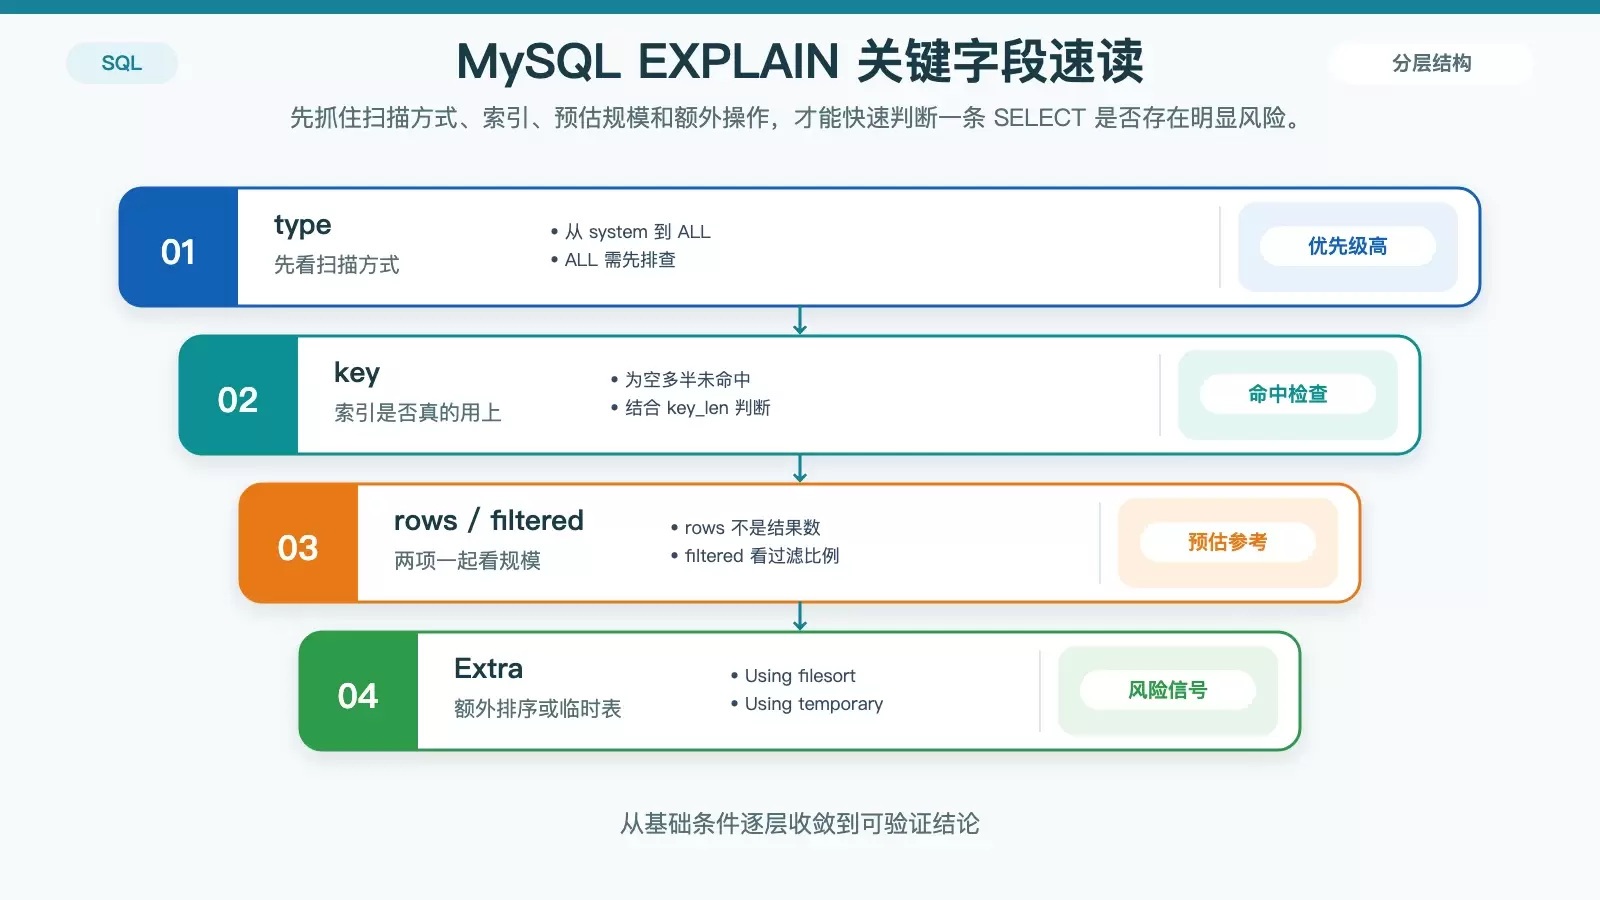
看 MySQL 的 EXPLAIN,真正有判断价值的字段并不多,核心是 type、key、rows、filtered 和 Extra。本文按“先看什么、为什么要用 JSON、哪些结论必须二次验证、跨数据库怎么避免误判”四个问题展开,帮助你把执行计划从“会看”变成“能据此定位问题”。
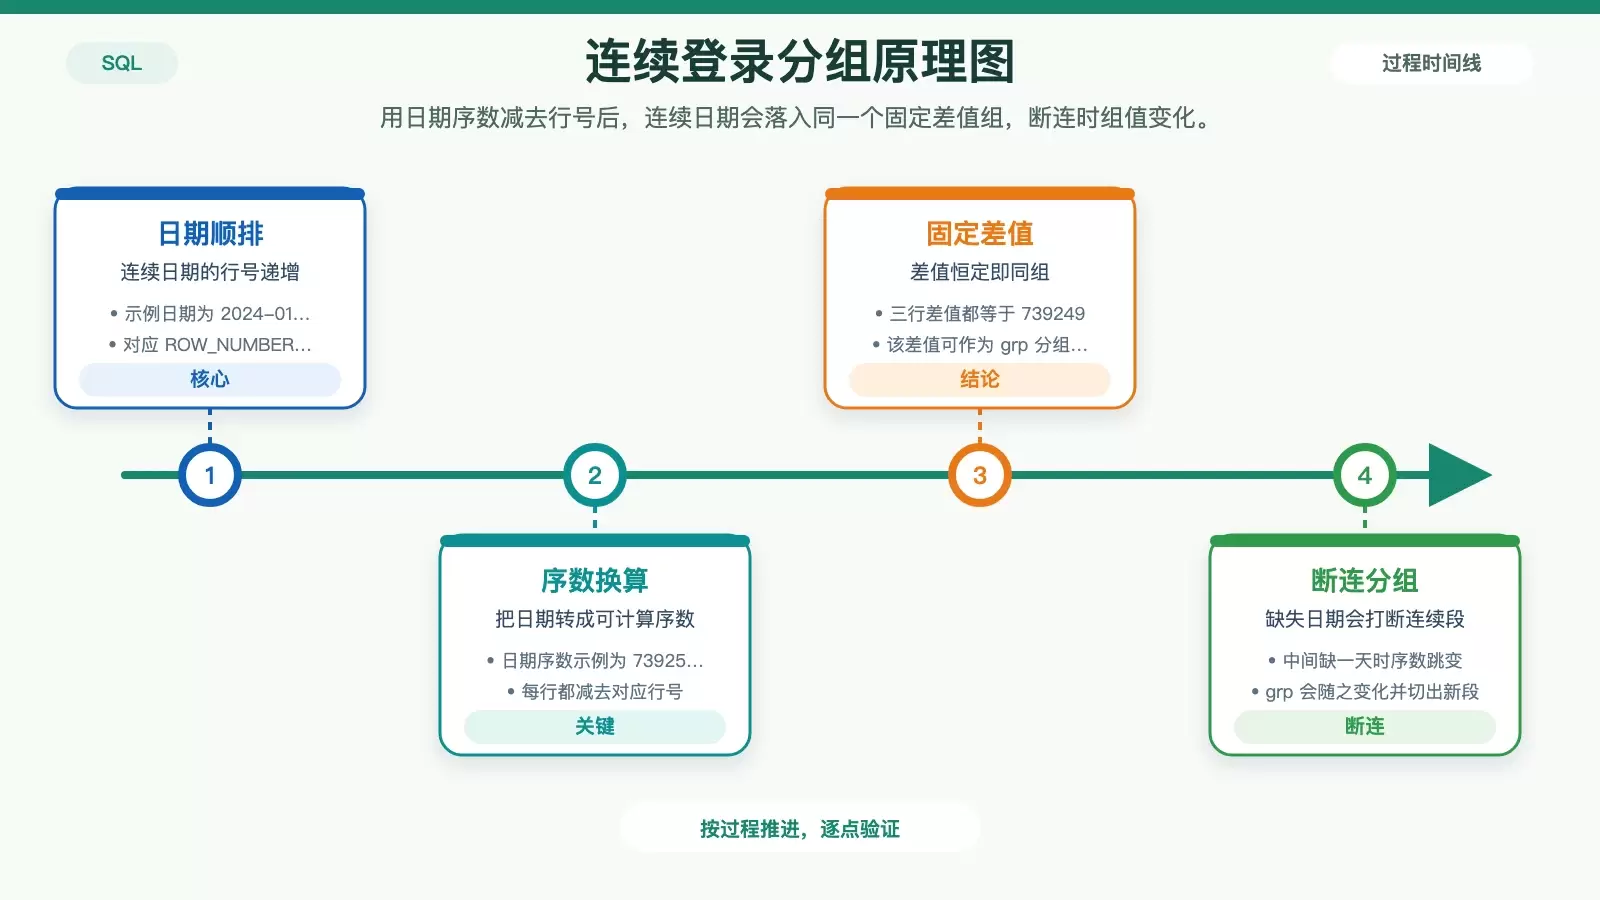
统计连续登录天数,常见做法是用 `ROW_NUMBER()` 配合日期序数打出连续段分组,再按组聚合得到每段长度,最后取最长值。实际落地时还要处理跨库日期函数、同日重复登录、`LAG()` 的适用边界,以及时区和时间精度带来的误判。
本教程详细介绍在 CentOS 或 RHEL 系统下使用 RPM 包安装 MySQL 8.0 的完整流程。涵盖清理旧版 MySQL/MariaDB、下载适配内核的安装包、按依赖顺序安装组件、解决 Data Dictionary 冲突报错,以及修改默认临时密码等内容,助你快速在 Linux 服务器部署数据库。
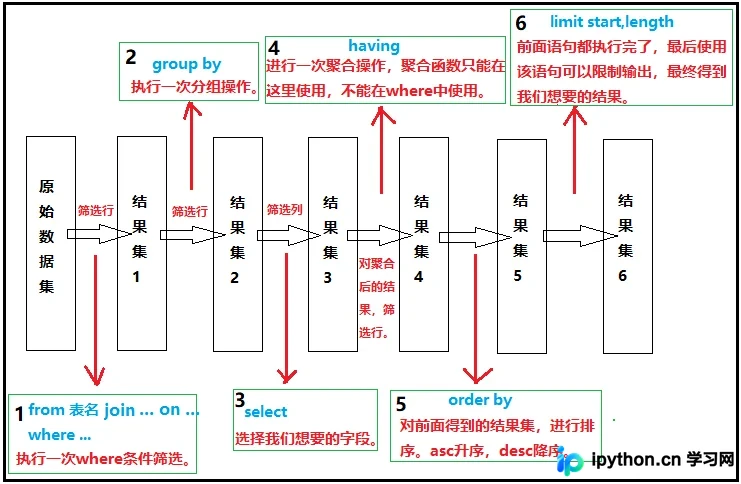
本文详细解析MySQL SQL查询语句的书写顺序与底层执行顺序。通过对比 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY 和 LIMIT 关键字,阐明两者为何不同及其背后的逻辑。同时重点探讨 HAVING 与 SELECT 的执行先后争议及优化建议,帮助开发者写出更高效的SQL代码。
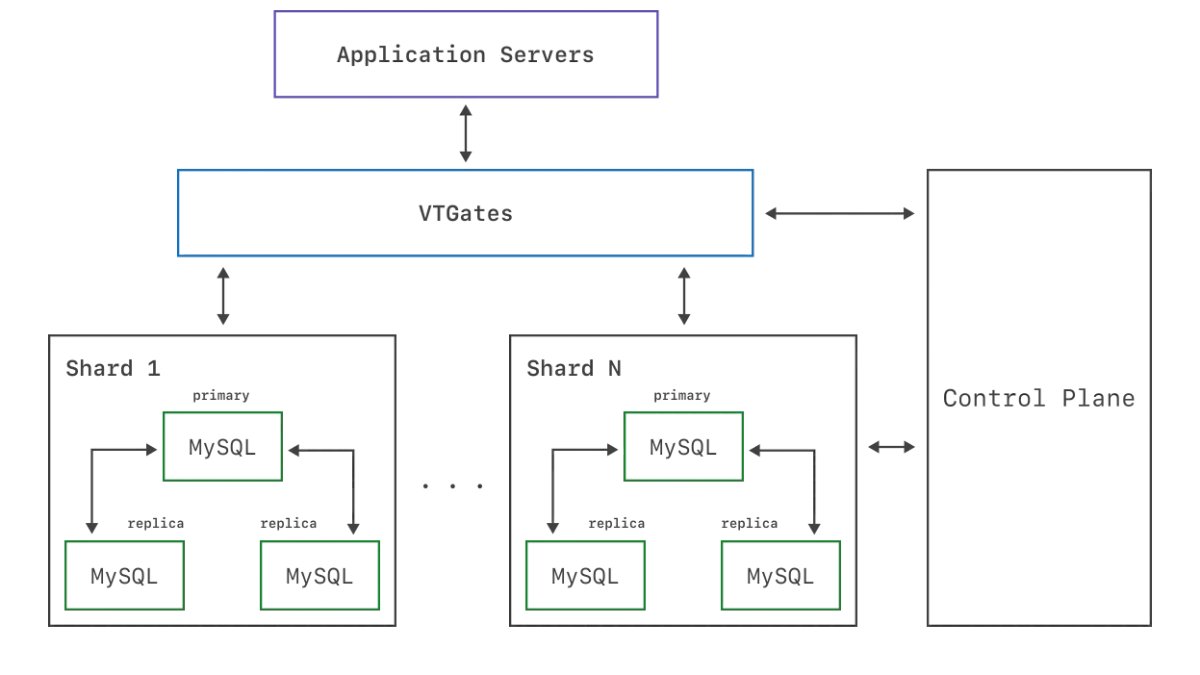
从分库分表的核心概念出发,对比 ShardingSphere 与 Vitess 的架构、分片路由、部署接入、扩容迁移与适用场景,帮助读者完成技术选型并规避常见坑。
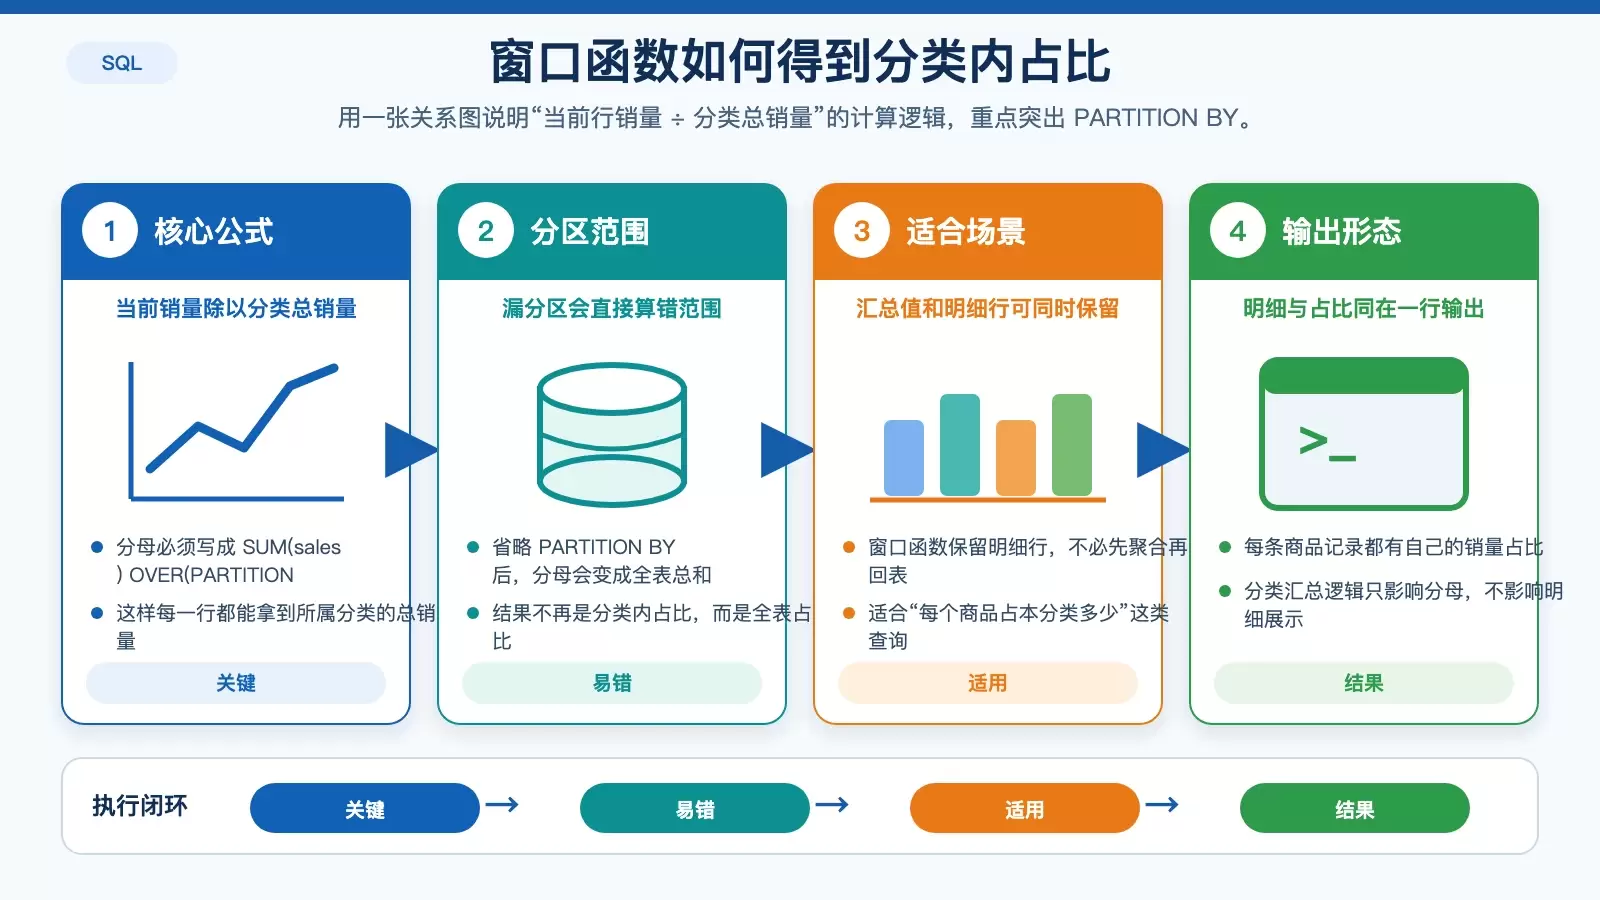
计算商品销量占分类总量的比例,核心是把分母写成 `SUM(sales) OVER(PARTITION BY category)`,再处理好整数除法、零值分母和版本兼容。本文按“正确写法、避坑、防精度误判、旧版替代方案”梳理,方便直接落到查询里。