

SQL Server 判断一个字符串是否包含指定字符或子串的方法
在 SQL Server 中,可以利用内置的 CHARINDEX 函数快速判断一个字符串是否包含特定的单字符或子串。本文介绍了两种实用场景:基于分隔符(如逗号)拆分比对和逐字匹配。通过创建自定义标量函数,可以将这些逻辑封装,以便在复杂的表查询中直接调用,提高数据处理效率。
2026-10-15
8

在 SQL Server 中,可以利用内置的 CHARINDEX 函数快速判断一个字符串是否包含特定的单字符或子串。本文介绍了两种实用场景:基于分隔符(如逗号)拆分比对和逐字匹配。通过创建自定义标量函数,可以将这些逻辑封装,以便在复杂的表查询中直接调用,提高数据处理效率。
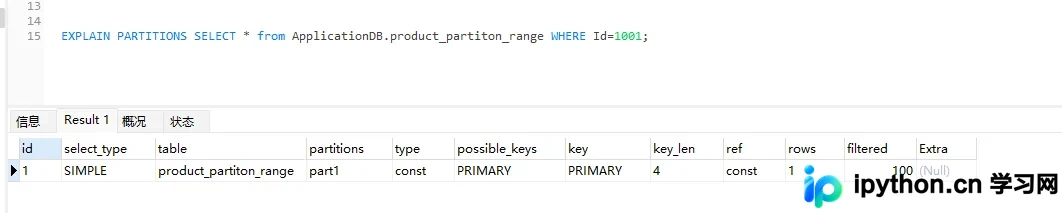
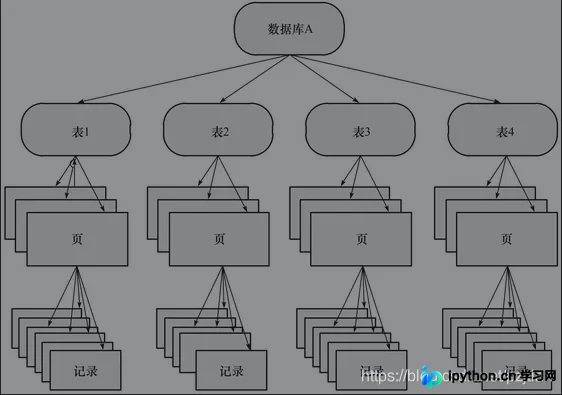
本文详细介绍MySQL中四种主要表分区类型(RANGE、HASH、KEY、LIST)的定义及适用场景,并通过具体代码演示如何创建分区表、插入测试数据以及查看分区状态。重点强调分区字段作为主键的约束条件,并解析如何通过EXPLAIN PARTITIONS验证查询是否命中分区以提升性能。
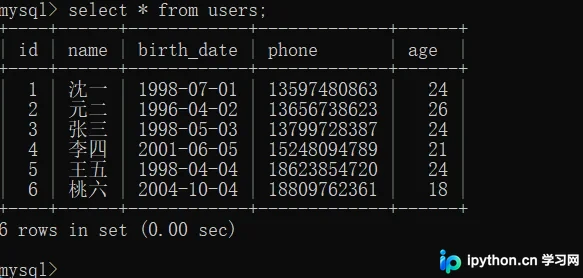
本文详解 MySQL 中如何使用 WHERE 子句进行精准数据筛选。涵盖等于、大于等比较运算符,AND/OR 逻辑组合,IN/BETWEEN 范围匹配,以及区分 NULL 与空字符串的正确写法。结合 LIKE 通配符实现模糊搜索,并说明运算优先级规则,助您高效掌握 SQL 数据提取技巧。
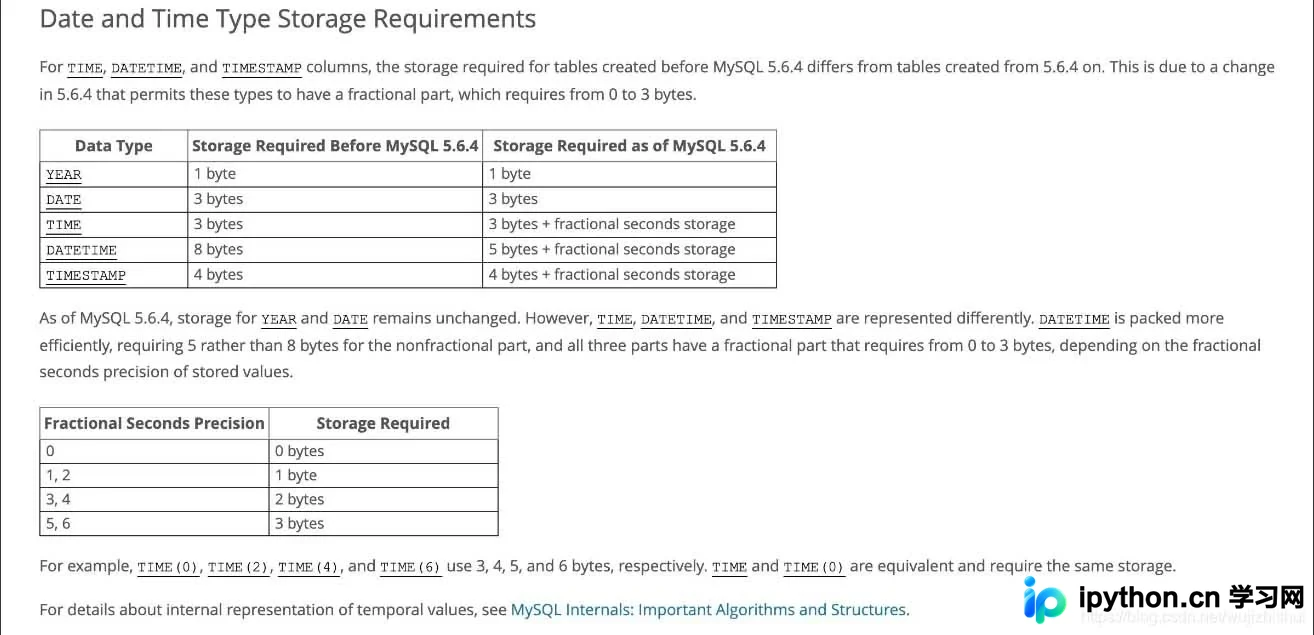
在MySQL中存储时间,严禁使用字符串。DateTime与时区无关且占用8字节;Timestamp自动转换时区且仅占4字节,适合多时区场景。整数时间戳便于跨系统传输但可读性差。本文详细对比三者的性能、空间及使用时机,助你选择最合适的存储方案。
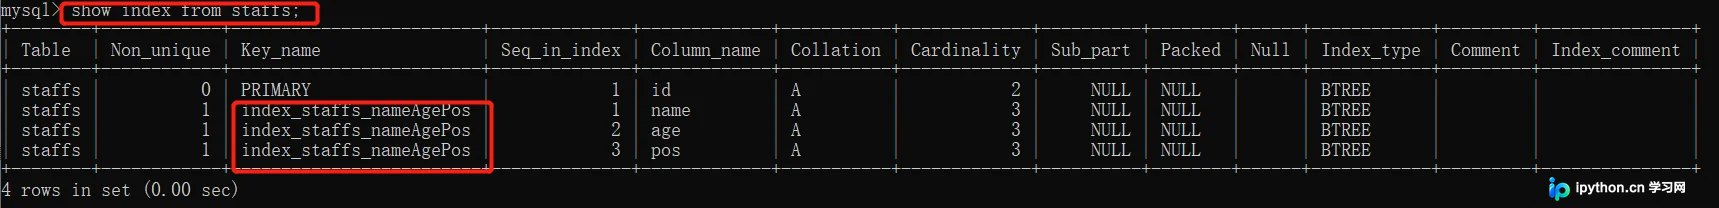
MySQL联合索引基于B+树结构构建,遵循最左前缀匹配原则。本文解析为何查询必须从索引最左侧字段开始,并深入探讨范围查询对后续索引失效的影响、乱序查询的优化器处理机制,以及通过调整列顺序来消除文件排序(Filesort)的具体实战技巧。
本文详细介绍在Linux环境下如何通过源码部署MySQL,并利用mysql_multi工具配置多实例数据库。重点演示如何将多个MySQL实例配置为从库(Slave),同步来自不同Master服务器的数据,构建多主一从的数据备份架构,包含关键的配置文件参数、环境设置及启停命令。
本文深入解析MySQL InnoDB存储引擎的锁机制,涵盖共享锁(S)、排他锁(X)及其兼容性,意向锁(IS/IX)的作用,以及MVCC非锁定读原理。详细对比Record Lock、Gap Lock和Next-Key Lock三种锁算法,阐述其在解决脏读、不可重复读和幻像问题中的应用,并介绍死锁检测与超时处理策略,帮助开发者优化高并发场景下的数据库性能。
本文解决 SQL Server 出现 602 错误(无法在 sysindexes 中找到相关对象)及数据库直接附加失败的问题。通过生成 SQL Server 2000 兼容脚本并配合导出数据向导,实现从 SQL Server 2005 到 2000 的安全数据迁移,确保数据完整性并避开版本兼容性陷阱。
本文详细讲解如何在 Rust 中通过 rusqlite crate 连接并操作 SQLite 数据库。内容包括项目依赖安装、结构体映射、数据库建表逻辑、数据插入、查询读取及完整执行流程。适合希望了解 Rust 处理本地轻量级数据库的开发者参考。
本文介绍如何利用MySQL 5.1及以上版本的EVENT事件调度器实现数据库层面的定时任务,替代外部程序调用。核心步骤包括:开启Event Scheduler、编写用于数据处理的存储过程、创建指定执行频率的EVENT并绑定存储过程。同时涵盖任务的启停控制及状态查询方法,满足定期清理日志或更新数据的业务需求。
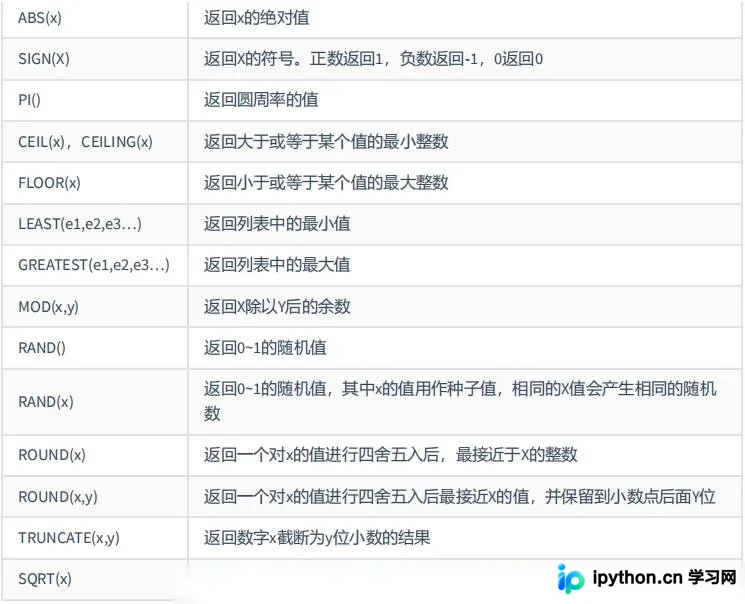
本文系统整理 MySQL 数据库中高频使用的常用函数,涵盖基础数学运算、三角函数与进制转换、字符串处理、日期时间操作、流程控制及加密解密等核心模块。通过具体 SQL 示例代码和图示说明,帮助开发者快速掌握字段清洗、时间戳计算及 MD5/SHA 校验等实战技巧,提升数据查询与处理的准确性。
本文针对MyBatis中SQL关联查询导致的数据重复以及多层括号(>3层)解析失败两个常见问题,提供具体解决方案。通过引入exists替代in、使用XML CDATA包裹特殊字符或深层嵌套SQL,可有效避免语法错误并提升执行效率。