MySQL LOCATE与POSITION函数详解:实现子串位置查找
本文详细介绍MySQL中LOCATE和POSITION函数的用法,涵盖基本语法、参数说明及大小写敏感特性。通过具体SQL示例演示如何查找子串首次出现位置及指定起始位置后的索引,帮助开发者高效处理字符串匹配查询任务。
2026-10-16
2

本文详细介绍MySQL中LOCATE和POSITION函数的用法,涵盖基本语法、参数说明及大小写敏感特性。通过具体SQL示例演示如何查找子串首次出现位置及指定起始位置后的索引,帮助开发者高效处理字符串匹配查询任务。
在MySQL中,CHAR是固定长度字符类型,不足补空格;VARCHAR是可变长度,仅存实际内容加1-2字节头信息。CHAR适合定长且短小的数据如MD5哈希,查询速度快;VARCHAR适合不定长文本以节省空间。合理选择能显著提升存储空间利用率与I/O效率,避免不必要的资源浪费。
在MySQL开发中,处理重复数据插入是常见需求。本文详细解析INSERT IGNORE、ON DUPLICATE KEY UPDATE和REPLACE INTO三种核心语法的使用场景与差异,涵盖主键与唯一索引前提。同时提供基于CASE WHEN的高效批量更新方法,以及百万级数据的批量插入优化策略,帮助开发者避免错误日志并提升数据写入性能。
本文详细解析MySQL中慢SQL优化的完整流程,涵盖如何开启并查看慢查询日志,通过mysqldumpslow分析高频耗时语句,以及SQL编写层面的核心优化规范。同时探讨慢SQL对数据库I/O资源及应用体验的影响,明确主从架构下的治理优先级,为排查和解决数据库性能瓶颈提供实用思路。
MySQL 自增主键出现断号是常见现象,主要由唯一键冲突、事务回滚及批量插入策略导致。InnoDB 引擎将自增值保留在内存中,插入失败或事务回滚时已分配的 ID 不会复用;批量写入时更会成倍预分配 ID。理解这一机制有助于合理设计数据库结构。
本文介绍如何在MySQL中利用内置的全文索引和ngram解析器实现简易版中文搜索引擎,替代ElasticSearch以节省资源。内容涵盖ngram分词原理、索引创建方式(建表时或ALTER TABLE)、自然语言模式与布尔模式的检索语法差异,并通过50万数据对比测试展示其相比LIKE查询的性能优势,适用于中小规模数据快速检索场景。

本文介绍在 CentOS 8 环境下通过二进制包安装 MySQL 5.7 并配置多个实例(如 3306、3307、3308)的完整流程。涵盖数据目录创建、数据库初始化、依赖库解决、my.cnf 多实例配置,以及如何利用 mysqld_multi 脚本实现一键管理与系统开机自动启动,帮助节省服务器资源并统一管理数据库。
本文详解SQL Server中两种常用的表数据复制语句:INSERT INTO SELECT和SELECT INTO。前者需目标表已存在,支持指定列或全部列复制;后者自动创建目标表,但要求目标表不存在且通常只能执行一次。通过具体代码案例对比两者优先级、适用场景及语法细节,帮助开发者高效进行数据备份与迁移。
本文详细讲解MySQL数据库的备份与还原方法。首先介绍mysqldump工具的使用,通过命令行将指定数据库导出为SQL文件;随后演示如何删除库并新建同名库,利用source命令在MySQL客户端内完成数据导入,确保业务数据的安全性与可恢复性。
当MySQL Slave节点的Slave_SQL_Running状态为No导致主从不同步时,可根据数据一致性要求选择不同修复方案。若业务允许短暂数据差异,可通过设置sql_slave_skip_counter跳过报错语句快速恢复;若需严格数据一致,则需锁定主库、备份并重置从库同步点(CHANGE MASTER TO),重新建立复制链路。
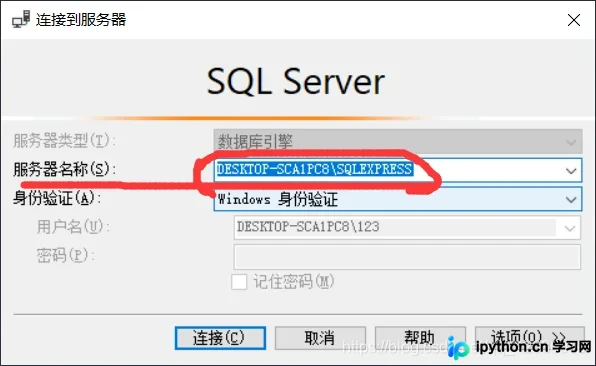
本文介绍如何在SQL Server 2017中通过配置TCP/IP协议,允许使用IP地址作为服务器名进行数据库连接。主要步骤包括:打开SQL Server配置管理器,启用TCP/IP和Named Pipes协议,将IP地址中的端口统一设置为1433并启用相关IP,最后重启SQL Server服务即可完成配置,解决Java等应用通过IP连接数据库时因服务器名限制导致的连接失败问题。
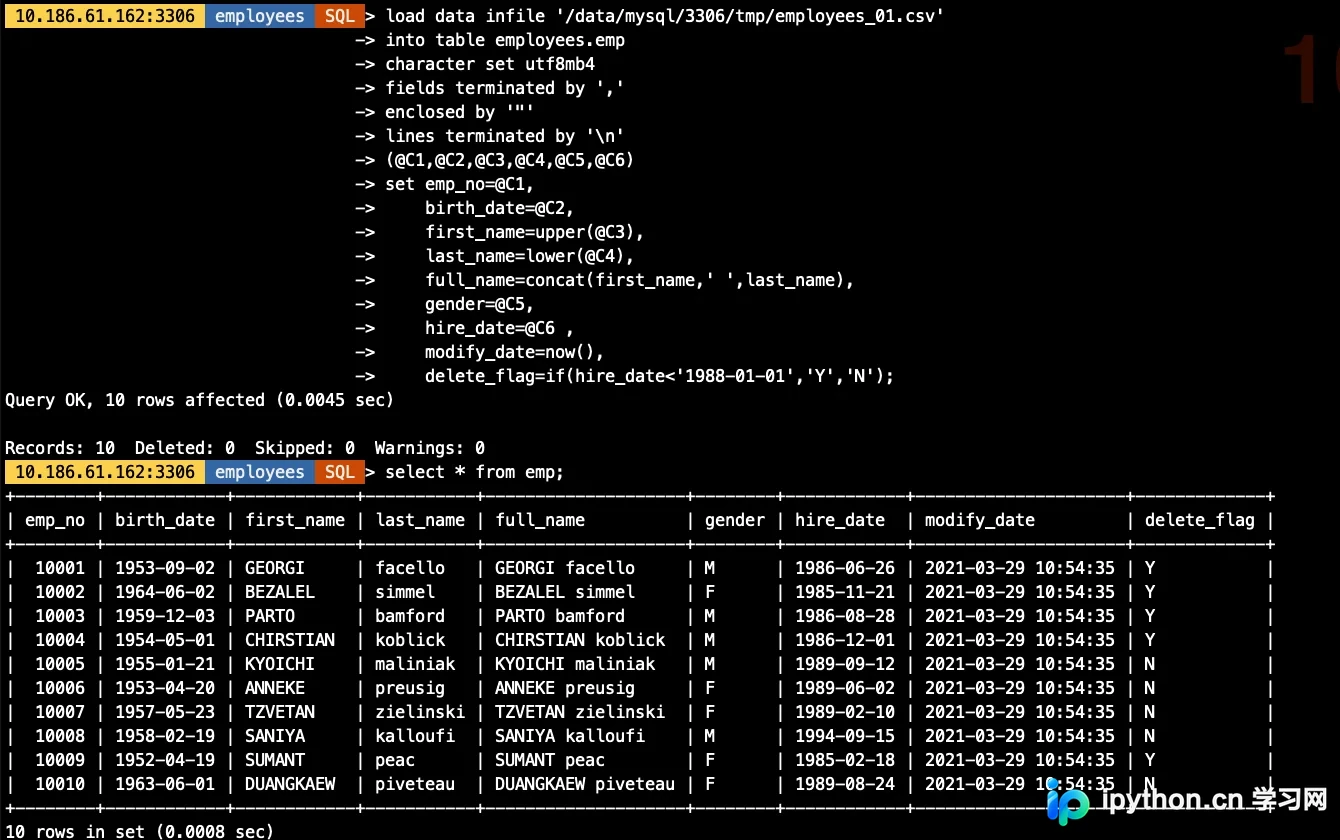
本文详解MySQL Shell中Parallel Table Import Utility(import_table)的使用。该工具支持8.0.23及以上版本,具备并发导入、多文件通配符匹配、限速及压缩文件处理等核心功能。通过具体代码示例,展示如何利用decodeColumns实现字段映射、函数处理及逻辑判断,并与传统LOAD DATA INFILE进行性能对比,证明其在大数据量导入场景下的显著效率优势。