

Mysql使用全文索引实现简易搜索及ngram中文分词配置

面对项目中的关键词搜索需求,在服务器资源受限且无部署ElasticSearch条件的情况下,可利用MySQL自带的全文索引功能快速实现简易搜索引擎。本文基于MySQL 8.0及InnoDB引擎,详解如何使用ngram解析器处理中文分词,包括索引创建、自然语言与布尔检索模式的语法应用,以及通过实测数据证明其性能优于传统LIKE模糊查询。
结果与准备
当需要实现聊天记录等文本的关键词检索,但缺乏额外资源部署分布式搜索引擎时,MySQL全文索引是一个轻量级解决方案。该方案基于倒排索引原理,能高效定位包含特定关键词的文档。本教程针对MySQL 5.7.6及以上版本,特别是支持内置ngram全文解析器的版本,用于解决中文分词问题。
ngram 中文分词原理
ngram 是将文本切分为连续 n 个字符序列的方法。例如对“你好靓仔”进行分词:
n=1: '你', '好', '靓', '仔'
n=2: '你好', '好靓', '靓仔'
n=3: '你好靓', '好靓仔'
n=4: '你好靓仔'
MySQL通过全局变量 ngram_token_size 控制分词大小,取值范围1-10,默认值为2。若需支持单字搜索,必须将值设为1,否则单字搜索将无法返回结果。通常推荐保持默认的2,因为中文词汇多为双字词。
查看当前配置:
show variables like 'ngram_token_size'
设置 ngram_token_size 有两种方式:
- 启动参数指定:运行
mysqld --ngram_token_size=2 - 修改配置文件:在
my.ini或my.cnf中添加ngram_token_size=2,重启服务生效。
创建全文索引
可在InnoDB引擎表中为字符串列添加FULLTEXT索引。以下提供三种创建方式:
第1步:建表时直接创建
目的:在设计表结构时同步建立索引,适合新表开发。
CREATE TABLE `article` (
  `id` bigint NOT NULL,
  `url` varchar(1024) COLLATE utf8mb4_general_ci NOT NULL DEFAULT '',
  `title` varchar(256) COLLATE utf8mb4_general_ci NOT NULL DEFAULT '',
  `source` varchar(32) COLLATE utf8mb4_general_ci DEFAULT '',
  `keywords` varchar(32) COLLATE utf8mb4_general_ci DEFAULT NULL,
  `publish_time` timestamp NULL DEFAULT NULL,
  PRIMARY KEY (`id`),
  FULLTEXT KEY `title_index` (`title`) WITH PARSER `ngram`
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci;
第2步:使用 ALTER TABLE 添加
目的:为已存在但未建索引的表补充全文索引。
ALTER TABLE article ADD FULLTEXT INDEX title_index(title) WITH PARSER ngram;第3步:使用 CREATE INDEX 添加
目的:等同于ALTER TABLE方式的另一种语法标准。
CREATE FULLTEXT INDEX title_index ON article (title) WITH PARSER ngram;检索操作详解
MySQL全文索引主要支持两种检索模式:自然语言模式和布尔模式。
1. 自然语言检索 (NATURAL LANGUAGE MODE)
这是默认检索模式。它自动根据词库分词,不支持复杂逻辑操作符,结果按匹配度降序排列。
-- 显式指定模式
SELECT * FROM article WHERE MATCH(title) AGAINST ('北京旅游' IN NATURAL LANGUAGE MODE);

-- 隐式默认模式(同上)
SELECT * FROM article WHERE MATCH(title) AGAINST ('北京旅游');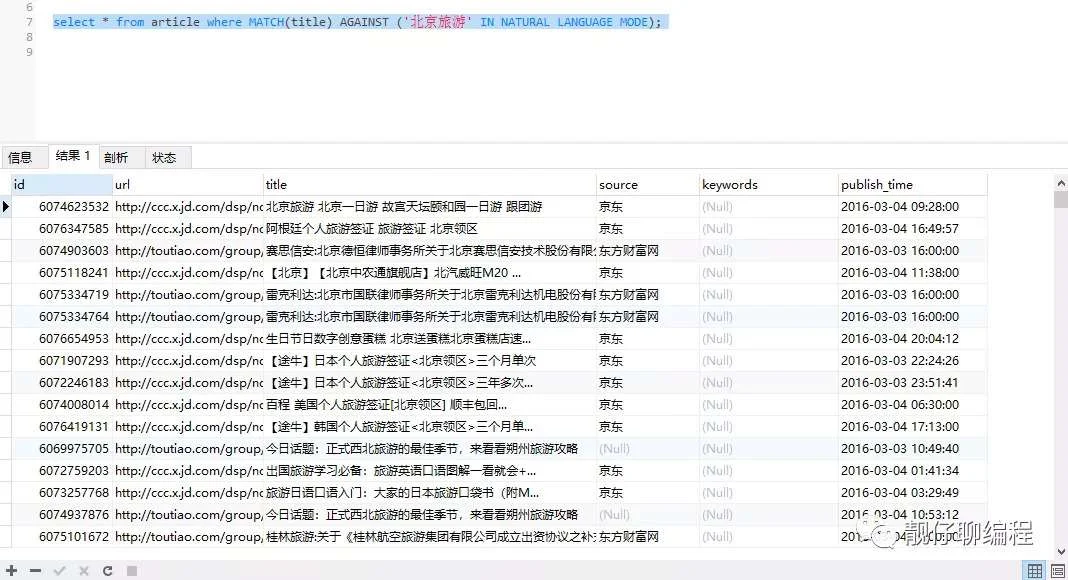
在此模式下,“北京旅游”会被拆分为“北京”和“旅游”,只要标题包含其中任一关键词即可匹配。
如需查看每条结果的匹配得分(浮点数),可加入计算字段:
SELECT *, MATCH(title) AGAINST ('北京旅游') AS score
FROM article
WHERE MATCH(title) AGAINST ('北京旅游' IN NATURAL LANGUAGE MODE);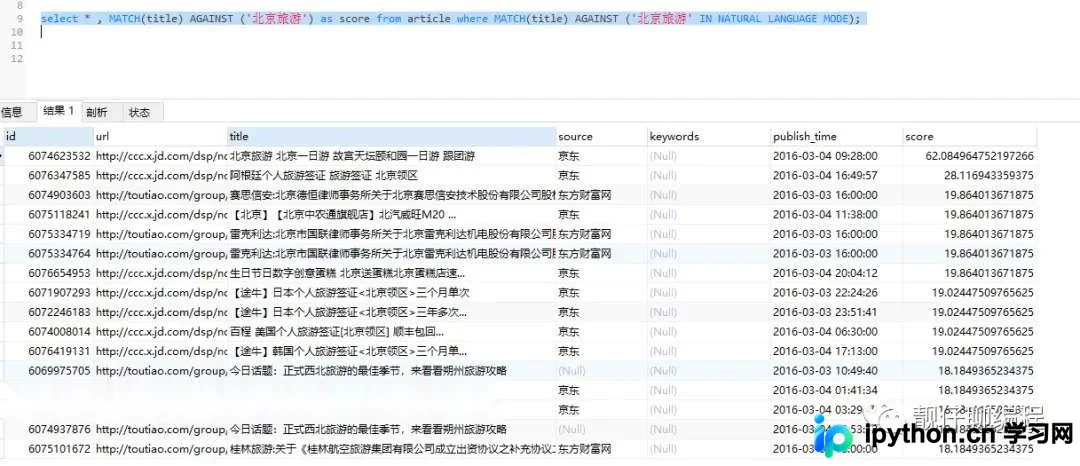
2. 布尔检索 (BOOLEAN MODE)
布尔模式允许使用操作符精确控制关键词的存在与否及权重,适合复杂查询。
-- 包含“约会”或“攻略”(空格默认为OR)
SELECT * FROM article WHERE MATCH(title) AGAINST ('约会 攻略' IN BOOLEAN MODE);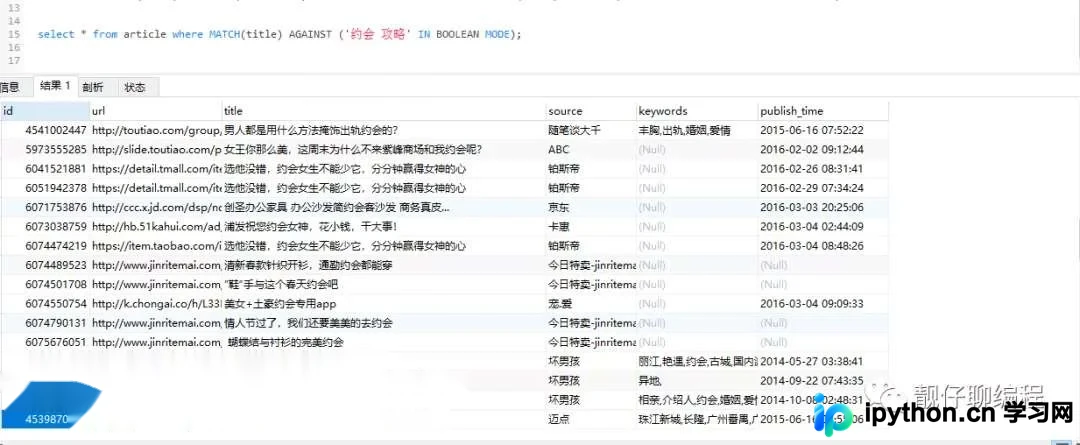
常用操作符示例:
'+约会 +攻略'    -> 必须同时包含两者
'+约会 攻略'     -> 必须包含约会,若包含攻略则加分
'+约会 -攻略'    -> 必须包含约会,且不包含攻略
'+约会 ~攻略'    -> 必须包含约会,若包含攻略会降低相关度排名
'+约会 +(>攻略 <技巧)' -> 必须包含约会和(攻略或技巧),约会+攻略的相关度高于约会+技巧
'约会*'          -> 前缀匹配,如“约会”开头的词
'"约会攻略"'     -> 短语匹配,类似 LIKE '%约会攻略%'
-- 必须包含“约会”,可含“攻略”
SELECT * FROM article WHERE MATCH(title) AGAINST ('+约会 攻略' IN BOOLEAN MODE);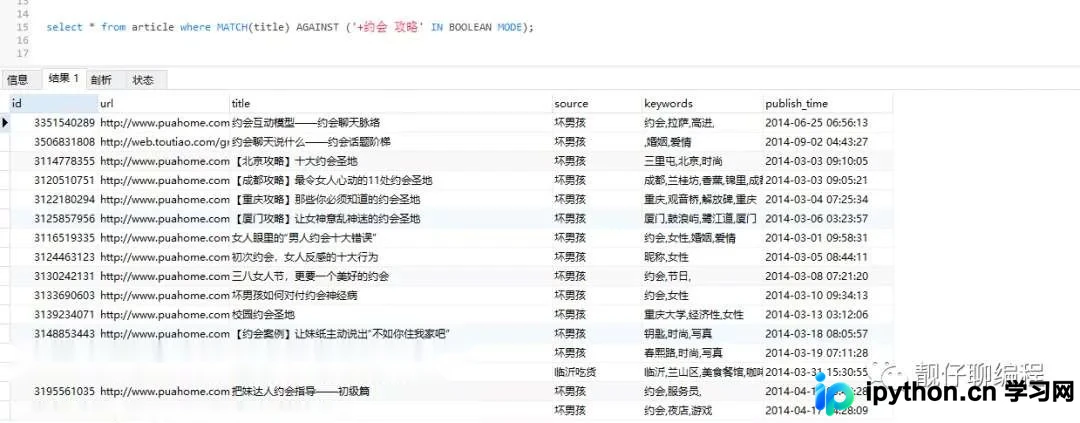
性能对比与结论
相较于传统的 LIKE '%keyword%' 模糊查询,全文索引具有显著优势:
- 语义理解:全文索引会进行分词,而LIKE仅是字符匹配。
- 可配置性:支持自定义最小/最大词长及忽略词。
- 相关性排序:返回匹配得分,便于结果优化。
- 性能极高:基于倒排索引,避免了全表扫描。
在约50万数据的测试环境中:
LIKE 查询耗时:
SELECT * FROM article WHERE title LIKE '%北京%';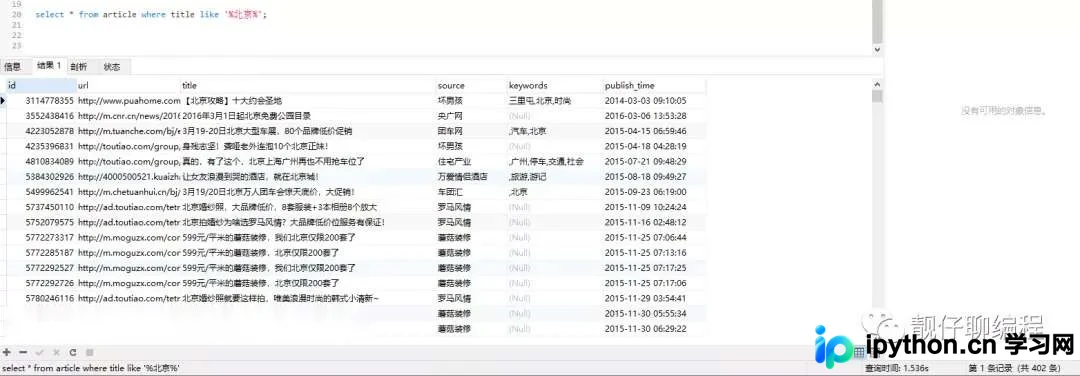
全文索引查询耗时:
SELECT * FROM article WHERE MATCH(title) AGAINST ('北京' IN BOOLEAN MODE);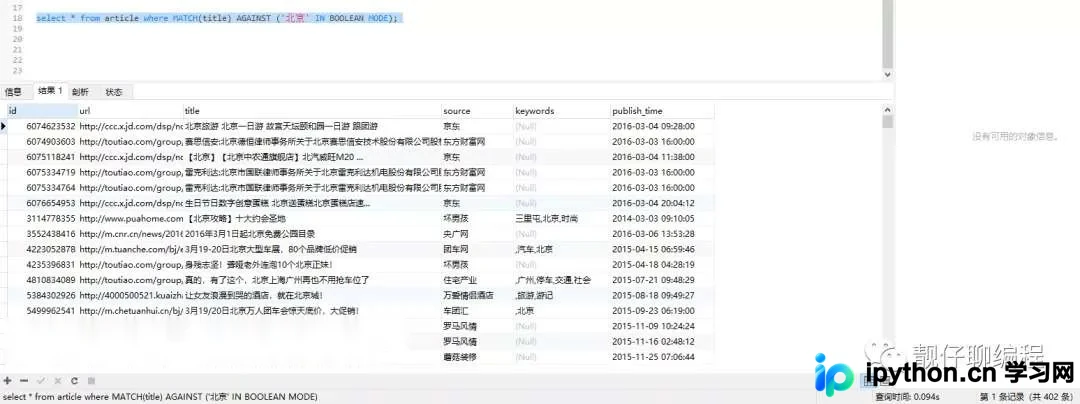
结果显示,全文索引查询速度约为0.094秒,而LIKE查询约为1.536秒,全文索引性能提升约16倍。虽然全文索引会带来一定的DML写入开销和存储空间消耗,但在数据量适中(非海量)的场景下,它是比部署ES更经济高效的搜索方案。
以上就是MySQL使用全文索引和ngram解析器实现简易版中文搜索引擎的详细内容,更多关于MySQL全文搜索配置与优化的资料请关注本站其它相关文章!免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









