

Sa-Token + JWT 集成到 Spring Boot:从登录鉴权到权限控制的完整接入指南
这篇文章用一个 Spring Boot 示例,梳理 Sa-Token 与 JWT 的集成思路:从依赖、配置、拦截器,到登录接口、权限校验和前端携带 token 的请求方式。文中同时补充了明文密码、返回敏感字段和拦截路径划分等落地时最容易踩到的细节。
2026-08-24
8

这篇文章用一个 Spring Boot 示例,梳理 Sa-Token 与 JWT 的集成思路:从依赖、配置、拦截器,到登录接口、权限校验和前端携带 token 的请求方式。文中同时补充了明文密码、返回敏感字段和拦截路径划分等落地时最容易踩到的细节。
本文详细介绍如何使用Python3实现语音合成(TTS)与语音识别(ASR)。通过chr_to_mp3.py生成MP3文件,并自动转换为PCM格式供识别模块使用。文章包含完整代码示例、运行截图及GitHub源码链接,解析Windows与Linux环境下的依赖配置差异,帮助开发者快速搭建本地语音处理流程。
本文详细解析梅尔倒谱系数(MFCC)的提取原理与流程,涵盖预加重、分帧加窗、FFT变换、Mel滤波器组及DCT逆变换等关键步骤。通过对比MATLAB与Python两种主流编程语言的实现代码,展示MFCC在语音识别与声纹分析中的具体应用,帮助开发者快速掌握特征参数提取的核心技术。
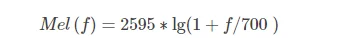
本文详细解析语音识别中MFCC特征的提取原理,涵盖Mel滤波器组设计、频谱转换及离散余弦变换步骤。通过Python代码示例,展示从语音信号读取、分帧处理到最终特征向量生成的完整流程,帮助开发者理解并应用该经典算法。
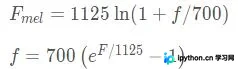
本文介绍如何使用Python的pydub库解决音频格式兼容问题。针对百度语音识别API仅支持pcm、wav等格式,而设备常输出mp3的情况,通过安装pydub及ffmpeg依赖,可轻松实现mp3到wav的转换,从而满足API调用要求。
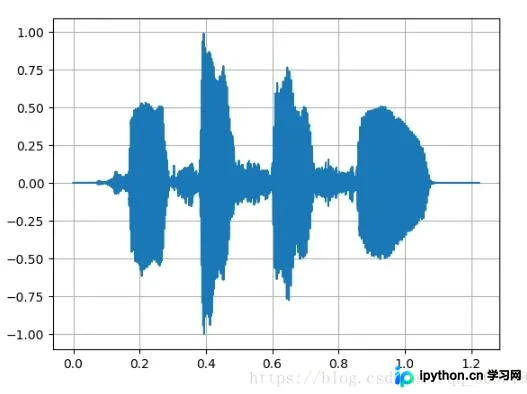
本文介绍利用Python进行语音文件特征提取的完整流程。首先通过pydub库将压缩的MP3文件转换为无损WAV格式,随后使用wave库读取音频参数并进行数据采样与归一化。最后,结合matplotlib绘制声波折线图与频谱图,直观展示音频特征,为后续语音识别模型训练提供数据基础。
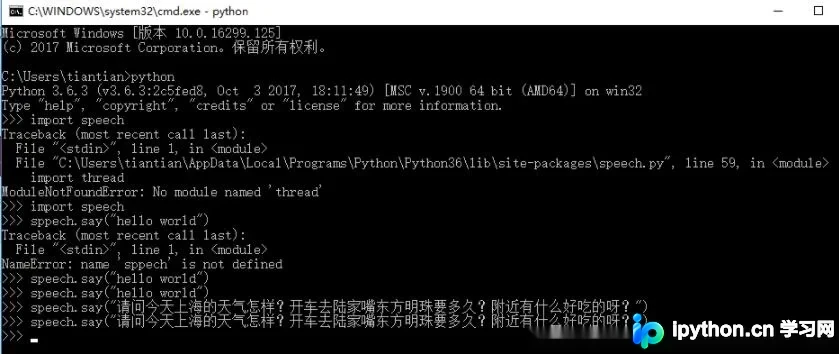
本文介绍在Windows环境下为Python3安装speech模块的完整流程。首先需安装pywin32以提供Windows底层接口,随后通过pip安装speech模块。针对Python3兼容性问题,需手动修改speech.py文件第59行的thread引用为threading。该模块支持文本转语音及语音识别功能,适用于本地语音应用开发。
本文介绍基于 Python 和 Windows SAPI 接口的语音识别与合成实现方法。通过 win32com 库调用系统组件,构建包含特定指令的语法规则,实现语音指令监听与对应的语音反馈功能,适用于简单的桌面语音控制场景。
本文详解Python调用百度语音API的完整流程,重点解析音频预处理技巧。针对MP3格式需转换为单声道16K采样率的PCM编码,提供了GoldWave与ffmpeg两种处理方法。同时探讨了长语音分割策略以规避连接错误,并附带完整的Python代码示例及API配置说明。
本文详解如何使用Python调用百度语音REST API实现语音合成与识别功能。通过获取Token、提交数据及处理返回结果三步流程,结合pyaudio库录制麦克风音频,提供完整代码示例,帮助开发者快速集成语音处理能力。
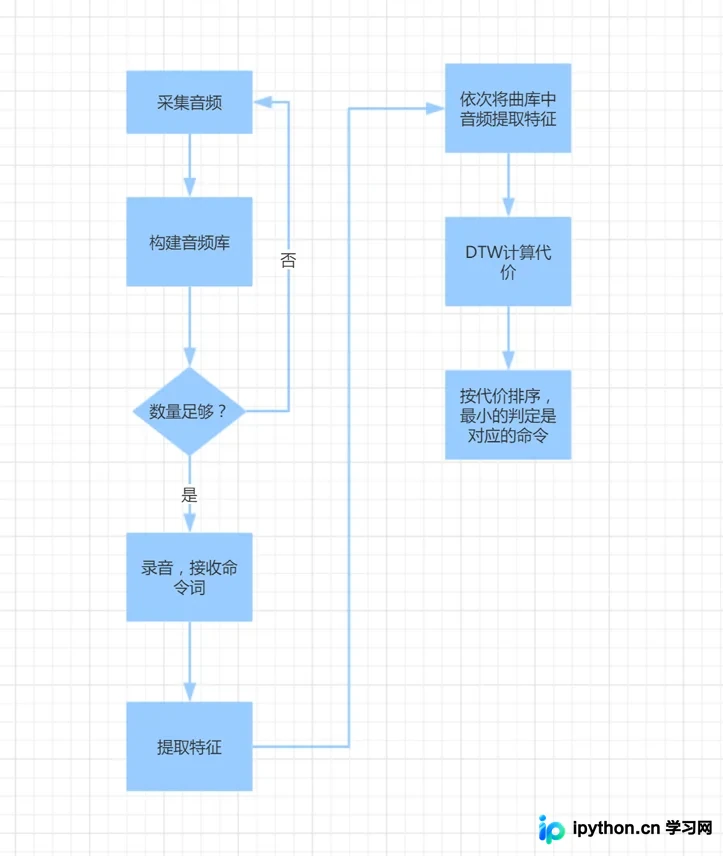
本文介绍如何使用Python在百行代码内实现简易语音命令识别系统。核心流程包括将音频分段进行傅里叶变换提取特征向量,并采用动态时间归整(DTW)算法计算不同发音长度下的最小匹配代价。通过欧氏距离衡量特征差异,实现了对“芝麻开门”等命令词的鲁棒性识别,适用于本地化语音控制场景的入门学习。
本文深入解析 TensorFlow 的核心优势与应用场景,提供详细的安装配置指南,涵盖 CPU 与 GPU 版本验证。通过张量操作、计算图构建及 Dataset API 使用,展示模型训练全流程。重点演示基于 MNIST 数据集的卷积神经网络(CNN)实战,包括数据预处理、模型构建、训练评估及预测,助力开发者掌握 AI 开发技能。