

Python3实现语音合成与识别:从文字到音频的完整流程

本文详细介绍如何使用Python3实现语音合成(TTS)与语音识别(ASR)。通过chr_to_mp3.py生成MP3文件,并自动转换为PCM格式供识别模块使用。文章包含完整代码示例、运行截图及GitHub源码链接,解析Windows与Linux环境下的依赖配置差异,帮助开发者快速搭建本地语音处理流程。
首先展示代码的实际运行效果截图。
语音合成模块实现
1. 语音合成模块
------->
执行以下命令即可运行:
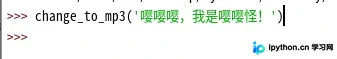
运行结果如下:
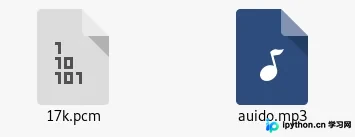
输入需要转换的文本内容后,程序会自动生成并输出对应的MP3文件。由于后续的语音识别模块需要.pcm格式的文件,程序会同步执行格式转换操作,生成名为17k.pcm的文件供下一步使用。用户无需手动干预此过程,当然也可以通过修改默认参数来自定义输出文件的位置、名称以及是否执行PCM转换。
语音处理与识别流程
2. 语音处理模块
为了简化操作流程,我们可以直接运行语音处理程序,对前一步生成的17k.pcm文件进行识别:
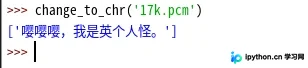
识别结果中可能存在少量误差,但经过数百次测试验证,整体效果仍能满足大多数应用场景的需求。
<----
上述代码演示已完成,有需要的开发者可直接前往GitHub仓库获取源码,无需客气。
GitHub仓库地址:maker_training_camp
最后提醒一点:语音合成与识别功能分别对应chr_to_mp3.py和mp3_to_chr.py两个脚本(从文件名即可大致判断其功能)。需要注意的是,在Windows环境下运行程序可能无法直接输出17k.pcm文件(需安装特定依赖),但这不影响语音合成的基本功能;而在Linux环境下,只要安装好相关依赖(代码中已体现),一切均可正常运行。
至此,关于Python3实现语音转文字(语音识别)和文字转语音(语音合成)的介绍完毕。如需了解更多相关内容,欢迎查阅本站往期文章或继续浏览后续内容,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









