

基于MATLAB与Python的MFCC特征提取实战详解

本文详细解析梅尔倒谱系数(MFCC)的提取原理与流程,涵盖预加重、分帧加窗、FFT变换、Mel滤波器组及DCT逆变换等关键步骤。通过对比MATLAB与Python两种主流编程语言的实现代码,展示MFCC在语音识别与声纹分析中的具体应用,帮助开发者快速掌握特征参数提取的核心技术。
MFCC概述
MFCC概述
在语音识别与说话人识别领域,梅尔倒谱系数(Mel-scale Frequency Cepstral Coefficients,简称MFCC)是最核心的语音特征之一。依据人耳听觉机理研究,人耳对不同频率声波的敏感度存在差异。研究表明,200Hz至5000Hz频段的语音信号对语音清晰度影响显著。当两个响度不同的声音同时作用于人耳时,响度较高的频率成分会产生掩蔽效应,导致人耳难以察觉响度较低的低频成分。由于低频声音在内耳蜗基底膜上的行波传递距离长于高频声音,通常表现为低音易掩蔽高音,而高音掩蔽低音较为困难。此外,低频处的临界带宽小于高频处。因此,人们从低频到高频按临界带宽由密到疏排列一组带通滤波器对输入信号进行滤波,并将各滤波器输出的信号能量作为基本特征。经进一步处理后,这些特征可作为语音输入参数。由于该特征不依赖信号性质,无需对输入信号做假设或限制,且结合了听觉模型研究成果,因此相比基于声道模型的LPCC具有更好的鲁棒性,更贴合人耳听觉特性,且在信噪比降低时仍能保持较好的识别性能。
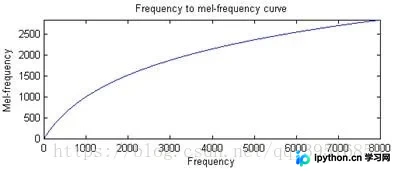
梅尔倒谱系数是在Mel标度频率域提取的倒谱参数。Mel标度描述了人耳频率响应的非线性特性,其与线性频率的关系可通过近似公式表示。
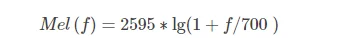
式中f为频率,单位为Hz。下图展示了Mel频率与线性频率的对应关系:
MFCC特征参数提取流程详解
MFCC特征参数提取流程详解
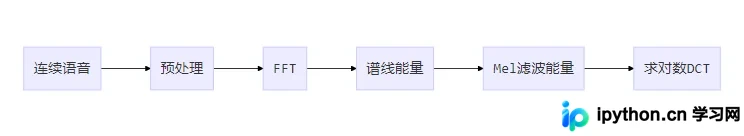
预处理阶段主要包括预加重、分帧以及加窗函数处理。
预处理环节包含预加重、分帧和加窗函数三个步骤。
预加重的目的是提升高频部分,使信号频谱在低频到高频的整个频带内保持平坦,从而能在相同信噪比下计算频谱。同时,预加重旨在消除发音过程中声带和嘴唇效应带来的影响,补偿语音信号中因发音系统抑制而减弱的高频部分,并突出高频共振峰。预加重处理本质上是将语音信号通过一个高通滤波器。
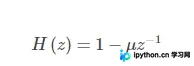
分帧是将N个采样点集合成一个观测单位,称为帧。通常N取值256或512,对应时间约为20至30毫秒。为避免相邻帧变化过大,相邻帧之间会设置重叠区域,包含M个取样点,M通常约为N的1/2或1/3。语音识别常用的采样频率为8kHz或16kHz。以8kHz为例,若帧长度为256个采样点,则对应时间长度为256/8000×1000=32毫秒。
加窗处理是将每一帧信号乘以汉明窗,以增强帧首尾的连续性。假设分帧后的信号为S(n),其中n=0,1,…,N-1,N为帧大小,乘以汉明窗后的结果形式如下:
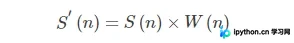
W(n)的具体表达式为:
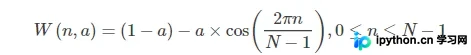
快速傅里叶变换(FFT)处理
由于时域信号变换难以直观反映信号特性,通常将其转换为频域能量分布进行观察,不同的能量分布代表不同的语音特性。因此,在乘以汉明窗后,每帧信号还需经过快速傅里叶变换以获取频谱能量分布。对分帧加窗后的各帧信号执行快速傅里叶变换,即可得到各帧的频谱。
谱线能量计算
对语音信号的频谱取模平方,即可得到语音信号的谱线能量。
Mel滤波器组能量计算
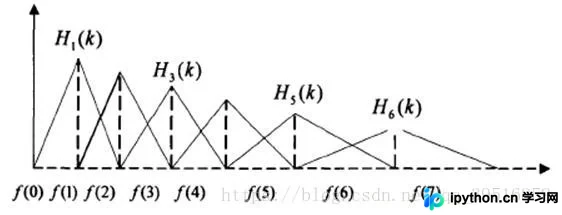
将能量谱通过一组Mel尺度的三角形滤波器组进行处理。定义包含M个滤波器的滤波器组(滤波器数量与临界带数量相近),采用三角滤波器,中心频率为f(m)。M通常取22至26。各f(m)之间的间隔随m值减小而缩小,随m值增大而增宽,如图所示:
三角滤波器的频率响应定义为:
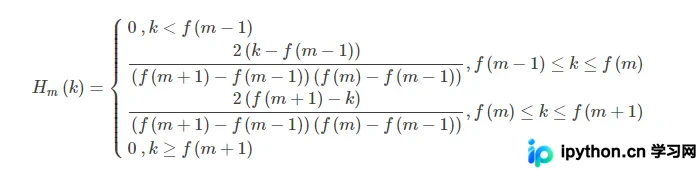
该过程对频谱进行平滑化处理,并消除谐波影响,从而突显语音的共振峰。因此,一段语音的音调或音高不会出现在MFCC参数中,这意味着以MFCC为特征的语音辨识系统不受输入语音音调差异的影响。此外,该方法还能有效降低运算量。
计算每个滤波器组输出的对数能量公式为:
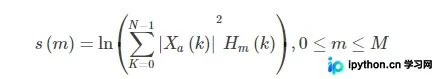
离散余弦变换(DCT)与倒谱计算
经离散余弦变换(DCT)得到MFCC系数:
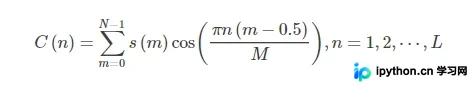
将上述对数能量代入离散余弦变换,可求出L阶的Mel参数。L阶指MFCC系数阶数,通常取12至16。此处M为三角滤波器个数。
MATLAB与Python实现对比
MATLAB实现方法
注意:在提取MFCC参数前,需加载并使用VOICEBOX工具包。
Df=5;
fs=8000;
N=fs/Df;
t=0:1./fs:(N-1)./fs;
x=sin(2*pi*200*t);
bank=melbankm(24,256,8000,0,0.5,'t');%Mel滤波器的阶数为24,fft变换的长度为256,采样频率为8000Hz
%归一化mel滤波器组系数
bank=full(bank);
bank=bank/max(bank(:));
% DCT系数,12*p
for k=1:12
n=0:23;
dctcoef(k,:)=cos((2*n+1)*k*pi/(2*24));
end
%归一化倒谱提升窗口
w=1+6*sin(pi*[1:12]./12);
%w=w/max(w);
%语音信号分帧
xx=enframe(x,256,80);%对x 256点分为一帧
%计算每帧的MFCC参数
for i=1:size(xx,1)
y=xx(i,:);
s=y'.*hamming(256);
t=abs(fft(s));%fft快速傅立叶变换
t=t.^2;
c1=dctcoef*log(bank*t(1:129));
c2=c1.*w';
end
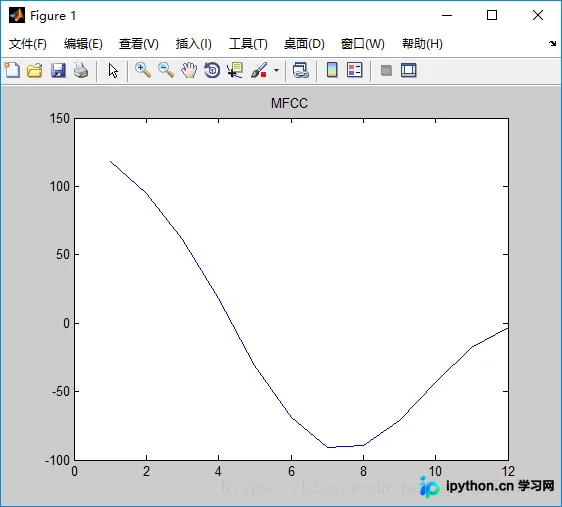
plot(c2);title('MFCC');
运行结果如下:
Python实现方法
import numpy as np
from scipy import signal
from scipy.fftpack import dct
import pylab as plt

def enframe(wave_data, nw, inc, winfunc):
  '''将音频信号转化为帧。
  参数含义:
  wave_data:原始音频型号
  nw:每一帧的长度(这里指采样点的长度,即采样频率乘以时间间隔)
  inc:相邻帧的间隔(同上定义)
  '''
  wlen=len(wave_data) #信号总长度
  if wlen<=nw: #若信号长度小于一个帧的长度,则帧数定义为1
    nf=1
  else: #否则,计算帧的总长度
    nf=int(np.ceil((1.0*wlen-nw+inc)/inc))
  pad_length=int((nf-1)*inc+nw) #所有帧加起来总的铺平后的长度
  zeros=np.zeros((pad_length-wlen,)) #不够的长度使用0填补,类似于FFT中的扩充数组操作
  pad_signal=np.concatenate((wave_data,zeros)) #填补后的信号记为pad_signal
  indices=np.tile(np.arange(0,nw),(nf,1))+np.tile(np.arange(0,nf*inc,inc),(nw,1)).T #相当于对所有帧的时间点进行抽取,得到nf*nw长度的矩阵
  indices=np.array(indices,dtype=np.int32) #将indices转化为矩阵
  frames=pad_signal[indices] #得到帧信号
  win=np.tile(winfunc,(nf,1)) #window窗函数,这里默认取1
  return frames*win  #返回帧信号矩阵

Df=5
fs=8000
N=fs/Df
t = np.arange(0,(N-1)/fs,1/fs)
wave_data=np.sin(2*np.pi*200*t)
#预加重
#b,a = signal.butter(1,1-0.97,'high')
#emphasized_signal = signal.filtfilt(b,a,wave_data)
#归一化倒谱提升窗口
lifts=[]
for n in range(1,13):
  lift =1 + 6 * np.sin(np.pi * n / 12)
  lifts.append(lift)
#print(lifts)

#分帧、加窗
winfunc = signal.hamming(256)
X=enframe(wave_data, 256, 80, winfunc)  #转置的原因是分帧函数enframe的输出矩阵是帧数*帧长
frameNum =X.shape[0] #返回矩阵行数18,获取帧数
#print(frameNum)
for i in range(frameNum):
  y=X[i,:]
  #fft
  yf = np.abs(np.fft.fft(y))
  #print(yf.shape)
  #谱线能量
  yf = yf**2
  #梅尔滤波器系数
  nfilt = 24
  low_freq_mel = 0
  NFFT=256
  high_freq_mel = (2595 * np.log10(1 + (fs / 2) / 700)) # 把 Hz 变成 Mel
  mel_points = np.linspace(low_freq_mel, high_freq_mel, nfilt + 2) # 将梅尔刻度等间隔
  hz_points = (700 * (10**(mel_points / 2595) - 1)) # 把 Mel 变成 Hz
  bin = np.floor((NFFT + 1) * hz_points / fs)
  fbank = np.zeros((nfilt, int(np.floor(NFFT / 2 + 1))))
  for m in range(1, nfilt + 1):
    f_m_minus = int(bin[m - 1])  # left
    f_m = int(bin[m])       # center
    f_m_plus = int(bin[m + 1])  # right
    for k in range(f_m_minus, f_m):
      fbank[m - 1, k] = (k - bin[m - 1]) / (bin[m] - bin[m - 1])
    for k in range(f_m, f_m_plus):
      fbank[m - 1, k] = (bin[m + 1] - k) / (bin[m + 1] - bin[m])
  filter_banks = np.dot(yf[0:129], fbank.T)
  filter_banks = np.where(filter_banks == 0, np.finfo(float).eps, filter_banks) # 数值稳定性
  filter_banks = 10 * np.log10(filter_banks) # dB
  filter_banks -= (np.mean(filter_banks, axis=0) + 1e-8)
  #print(filter_banks)
  #DCT系数
  num_ceps = 12
  c2 = dct(filter_banks, type=2, axis=-1, norm='ortho')[ 1 : (num_ceps + 1)] # Keep 2-13
  c2 *= lifts
print(c2)
plt.plot(c2)
plt.show()
运行结果:
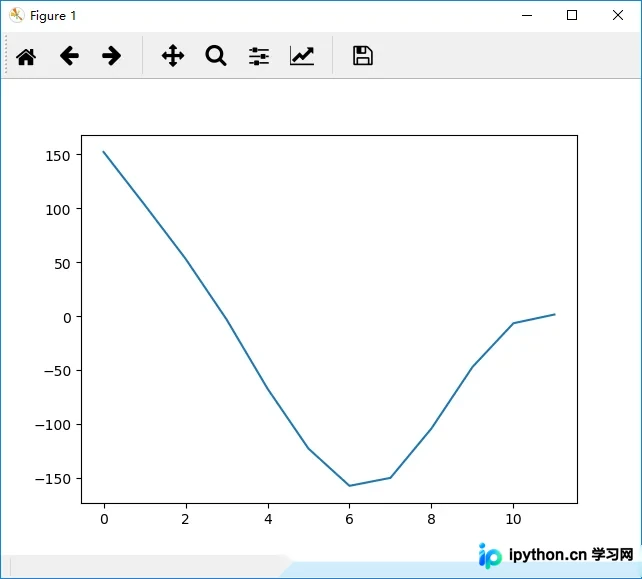
对比MATLAB与Python绘制的波形图可知,两者计算出的MFCC倒谱系数基本走势一致。
参考来源:http://haythamfayek.com/2016/04/21/speech-processing-for-machine-learning.html
本文内容旨在为学习者提供参考,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









