Python模拟登录并维持Cookie状态实战:以nosec.org为例
本文详解如何利用Python的Requests库模拟网站登录并维持Cookie状态。针对nosec.org等需要动态Token的网站,通过解析页面获取authenticity_token,结合用户名密码POST提交,实现自动登录。文章提供完整代码示例,解析Session对象复用机制,帮助开发者解决爬虫登录验证及会话保持问题。
2026-10-13
6

本文详解如何利用Python的Requests库模拟网站登录并维持Cookie状态。针对nosec.org等需要动态Token的网站,通过解析页面获取authenticity_token,结合用户名密码POST提交,实现自动登录。文章提供完整代码示例,解析Session对象复用机制,帮助开发者解决爬虫登录验证及会话保持问题。
本文详解Python爬虫中利用cookielib模块实现模拟登录的方法。通过构建CookieJar及子类MozillaCookieJar,结合urllib2的build_opener,可自动捕获并保存网站Cookie。文章涵盖从获取Cookie、保存到文件(cookie.txt)再到读取Cookie访问受限页面的完整流程,帮助开发者突破游客限制,高效抓取目标网页数据。
本文介绍Python中推荐的HTTP客户端库requests,通过一个模拟登录的示例展示其简洁用法。仅需少量代码即可实现会话保持、POST提交登录凭证及后续页面抓取,是Python数据采集的高效工具。
本文详细介绍如何利用Python中的urllib2与cookielib模块实现网站自动登录并保持会话状态,随后结合PyQuery库快速提取目标HTML数据。内容涵盖从环境准备、请求头配置、表单提交到DOM解析的完整操作流程,适用于传统静态网页的数据抓取场景。
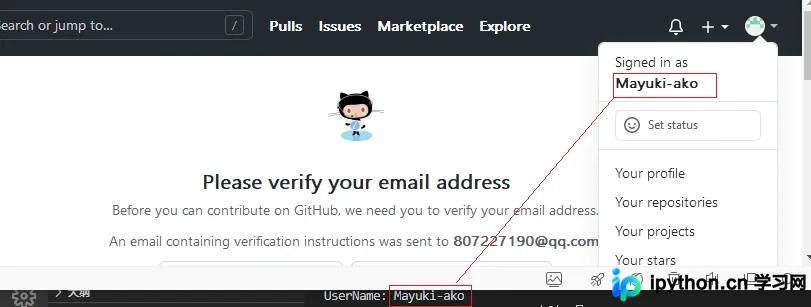
本文介绍如何使用 Python 的 requests 库模拟登录 GitHub。核心步骤包括:初始化 Session 保持状态、获取登录页的 CSRF Token、构造 POST 请求提交表单数据。代码展示了如何提取 authenticity_token 并处理登录响应,适用于学习 Web 自动化与爬虫基础。
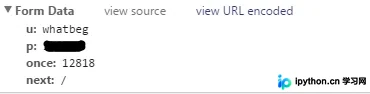
本文详细解析如何使用Python的requests.Session实现网站模拟登录。通过V2EX网站的登录流程为例,演示如何利用BeautifulSoup解析HTML获取动态参数(如once值),构建POST请求数据,并利用Session对象跨请求保持Cookie状态,最终验证登录成功。