

Python使用浏览器Cookie模拟登录知乎的方法
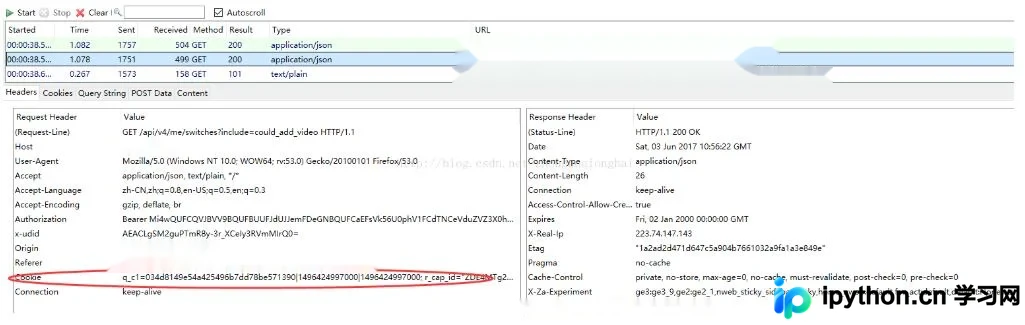
本文介绍了如何使用Python通过获取浏览器Cookie来模拟登录知乎。主要步骤包括使用Firefox和Httpfox插件获取GET请求的Cookie,将其正确格式化为Python代码中的字符串,并通过发送请求验证登录状态。该方法适用于需要模拟用户访问知乎的场景。
2026-10-13
6

本文介绍了如何使用Python通过获取浏览器Cookie来模拟登录知乎。主要步骤包括使用Firefox和Httpfox插件获取GET请求的Cookie,将其正确格式化为Python代码中的字符串,并通过发送请求验证登录状态。该方法适用于需要模拟用户访问知乎的场景。
本文详解如何使用Selenium模拟登录腾讯新闻网页版。针对部分账号触发的滑块验证,文章深入分析了TX滑块与极验的区别,重点讲解了Frame切换、蓝色滑块定位、移动轨迹构造及验证成功判断逻辑,并提供完整的Python重试代码实现。

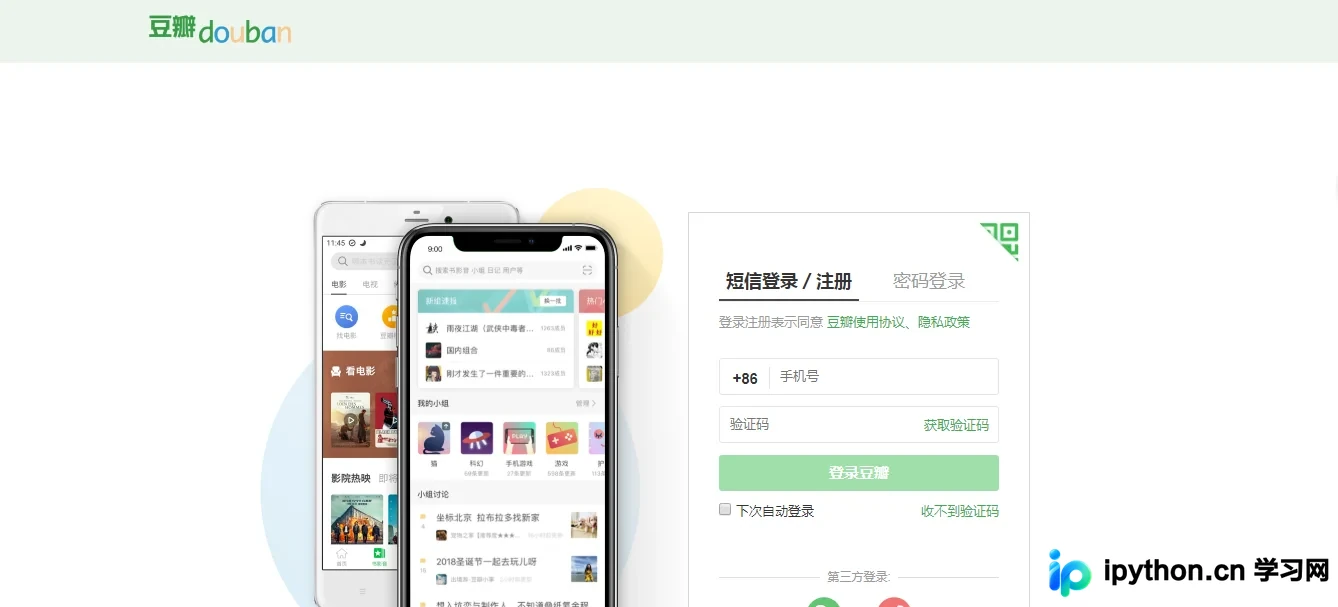
本文详解如何使用Python的requests库模拟豆瓣6.0新版网站的登录过程。通过开发者工具分析POST请求接口与数据格式,利用Session保持Cookie状态,成功获取个人首页内容。针对新版反爬策略,提供了完整的代码示例与关键步骤解析,帮助开发者解决登录失败问题。
本文通过Python实战案例,详细解析如何模拟登录CSDN平台。内容涵盖从导入必要库、获取请求头部信息、解析网页结构,到维持登录状态Session及验证登录结果的完整代码流程。旨在帮助开发者理解模拟登录的核心逻辑,提升Python网络编程与爬虫开发能力。
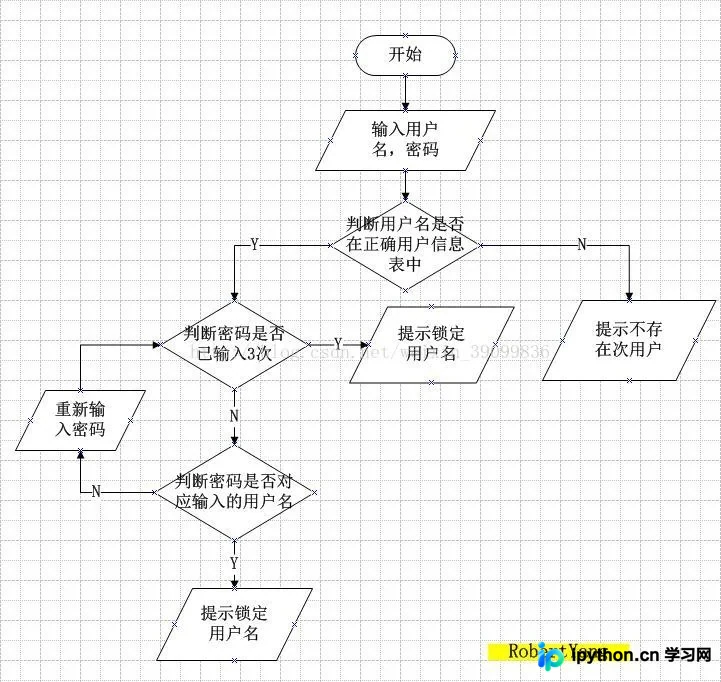
本文介绍如何使用Python3实现一个具备基础安全机制的模拟登录系统。系统支持从文件读取用户凭据,验证用户名和密码,并在密码连续输入错误三次后自动锁定该账户。通过文件操作和字典数据结构,演示了完整的登录逻辑与状态管理。
本文详细介绍如何使用Python的urllib2库实现网易邮箱的模拟登录。通过配置代理IP、处理CookieJar、构造POST请求及解析响应HTML,完成身份验证并获取登录后的页面内容。代码包含完整的请求头设置与URL跳转处理,适用于Python 2环境下的自动化登录场景。
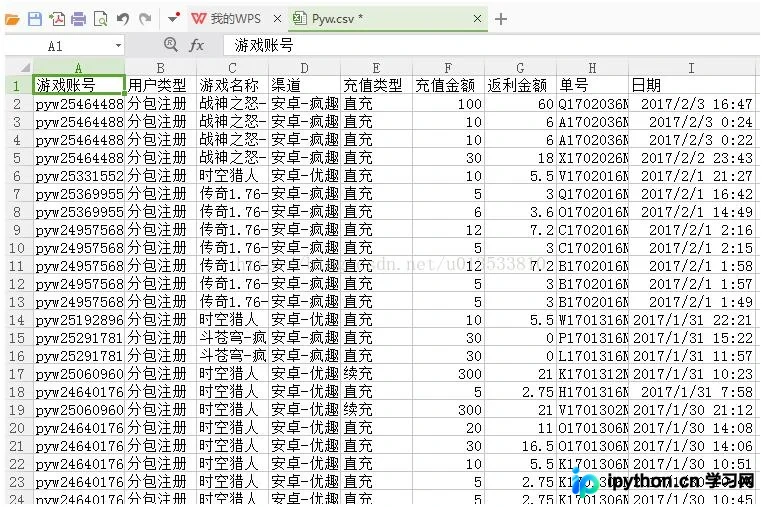
本文介绍使用Python编写简单爬虫,通过模拟登录获取HTML页面,利用正则表达式解析目标数据行,并将结果逐行写入CSV文件的全过程。包含核心逻辑说明、完整代码示例及导出结果展示,适用于需要批量抓取网页数据并保存为表格格式的场景。
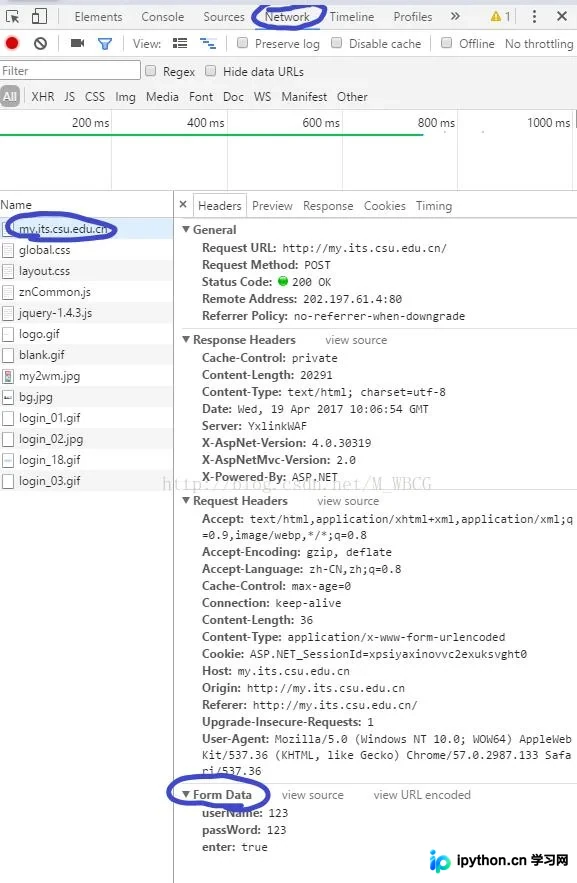
本文详解利用Python进行网站模拟登录的完整流程。通过开发者工具分析Network请求,提取登录所需的隐藏参数,并使用requests库建立Session以维持状态。文章展示了如何获取HTML源码、正则提取数据、提交POST请求以及获取登录后页面内容,提供基础代码参考。
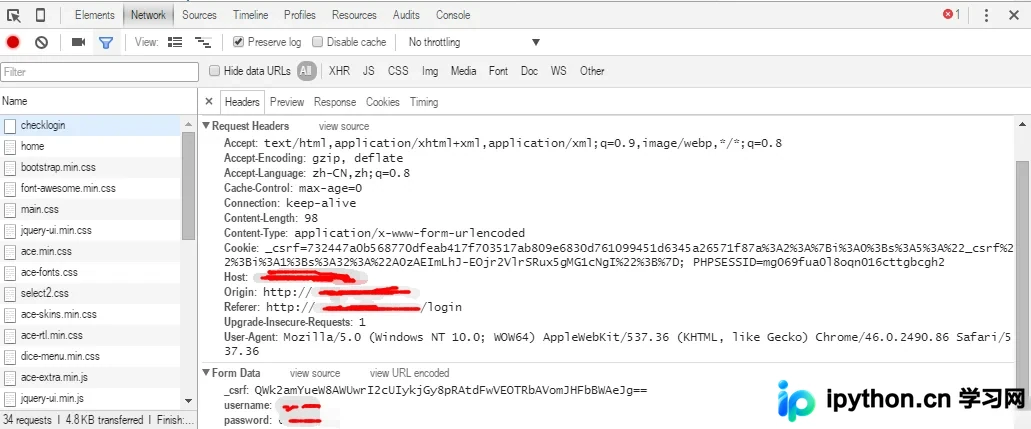
本文详解如何使用Python的Requests库实现网站模拟登录。通过抓取登录请求头与参数,解析CSRF Token机制,并重点解决HTTP无状态导致的身份识别问题。核心方案是利用requests.Session()维持会话状态,自动传递Session ID,从而成功通过服务器验证并获取登录后的页面内容。
本文详解Python3爬虫模拟登录的核心技术。通过前端审查元素定位加密逻辑,介绍Base64、手动模拟及PyExecJS调用JS三种加密还原方案。针对图片验证码,探讨本地存储与第三方识别模块的应用。最后演示如何构造Headers、处理Session/Cookie并发送POST/GET请求,实现完整登录流程。
本文详细介绍 Python 实现网站模拟登录的两种方法。重点在于获取表单提交地址并携带 Cookie 进行 POST 数据提交。通过普通脚本方式与面向对象封装两种方式,演示如何利用 urllib 和 http.cookiejar 模块完成身份验证及后续页面访问,帮助开发者掌握抓取需登录权限网页的核心技术。
本文详细讲解如何使用Python3结合Requests和BeautifulSoup库实现V2EX网站的模拟登录。通过获取动态Token、构造表单数据及发送POST请求,帮助开发者掌握Web自动化登录的核心技术,适合初学者进行练手实践。