

Python使用urllib2与cookielib模拟登录并搭配PyQuery解析网页

本文详细介绍如何利用Python中的urllib2与cookielib模块实现网站自动登录并保持会话状态,随后结合PyQuery库快速提取目标HTML数据。内容涵盖从环境准备、请求头配置、表单提交到DOM解析的完整操作流程,适用于传统静态网页的数据抓取场景。
抓取原理与核心组件
直接通过URL请求受限网页通常会返回未登录状态或拒绝访问。为实现自动化数据采集,需先模拟浏览器建立Session。本方案采用urllib2构建请求对象,利用cookielib自动管理Cookie以维持登录态,最后借助PyQuery(jQuery在Python中的实现)通过选择器语法精准定位并提取页面节点。
第1步:安装PyQuery解析库
目的:获取基于jQuery语法的HTML解析能力。入口:系统终端。动作:执行一键安装指令。重要参数:pyquery包名。完成状态:终端显示Successfully installed,脚本中import pyquery无报错。
sudo easy_install pyquery
第2步:配置HTTP客户端与会话管理
目的:初始化支持自动读写Cookie的请求管道,避免每次手动传递Session ID。入口:Python脚本头部定义区。动作:创建CookieJar实例并绑定至自定义Opener,同时注入标准User-Agent与Referer头部。重要参数:HTTPCookieProcessor对象、MSIE兼容UA字符串。完成状态:调用urllib2.install_opener生效,后续所有urlopen自动携带该会话上下文。
import urllib
import urllib2
import cookielib

cj = cookielib.CookieJar()
opener = urllib2.build_opener(urllib2.HTTPCookieProcessor(cj))
opener.addheaders = [('User-agent','Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1)')]
urllib2.install_opener(opener)
第3步:构造表单并提交登录请求
目的:向目标站点认证接口发送凭证,完成身份核验并激活账户权限。入口:业务逻辑执行区。动作:将用户名、密码、角色类型拼接为urlencoded格式作为POST请求体,发送至指定Login接口。重要参数:表单字段字典、Referer地址(防止防盗链拦截)。完成状态:urlopen(resp)返回HTTP 200,且CookieJar内已记录服务器下发的Session/Token标识。
req = urllib2.Request("http://seam.ustb.edu.cn:8080/jwgl/Login", urllib.urlencode({"username":"41255029","password":"123456","usertype":"student"}))
req.add_header("Referer","http://xxoo.com")
resp = urllib2.urlopen(req)
第4步:携带Cookie获取目标页并解析
目的:在已授权会话下加载受限页面,并通过选择器快速抽取结构化数据。入口:数据提取函数区。动作:使用PyQuery发起GET请求获取首页HTML,调用CSS类名选择器定位课表容器。重要参数:目标页面URL、DOM节点类名(如.haveclass)。完成状态:变量classes返回带有完整属性的Element对象,可调用.html()或遍历输出预期表格内容。
from pyquery import PyQuery as pq
html = pq(url=u'http://seam.ustb.edu.cn:8080/jwgl/index.jsp')
classes = html('.haveclass')
# classes 变量即包含解析后的课表节点数据,可直接渲染或存入数据库
结果展示与完成判断
运行完整流程后,程序将返回包含指定课程信息的DOM结构。通过打印解析结果或将其传入Web框架模板即可预览实际效果。当控制台无异常堆栈且能正确输出目标类名的子节点列表时,表示模拟登录与数据抓取链路已成功闭环。
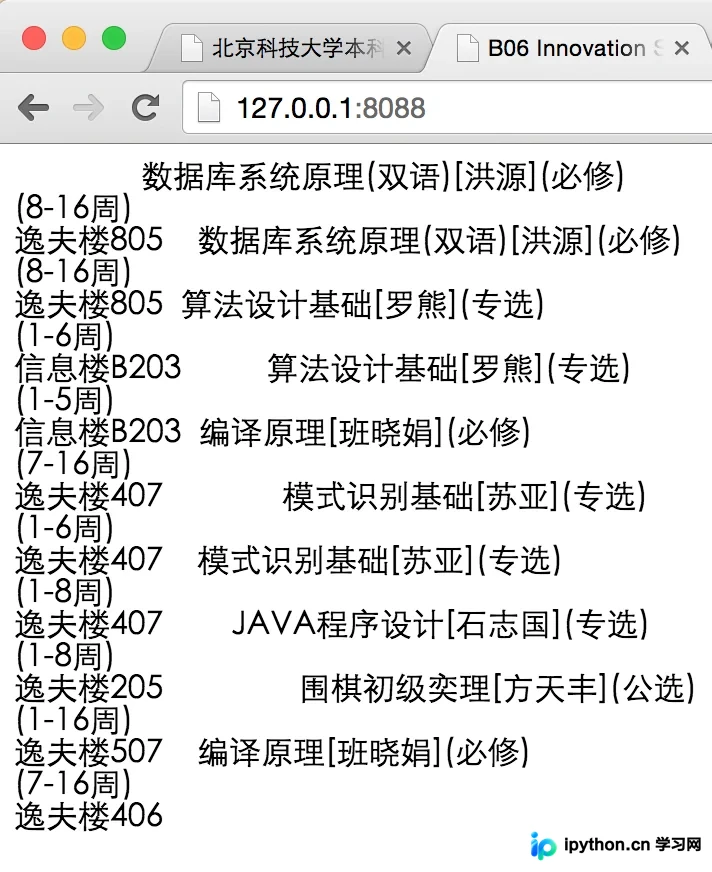
注意事项与排错指南
- 版本兼容性差异:示例代码基于Python 2标准库编写(使用
urllib2与u''字符串前缀)。若在Python 3环境下运行,需将urllib2替换为urllib.request,urllib.urlencode迁移至urllib.parse.urlencode,并移除字符串编码前缀。 - Referer校验拦截:部分教务系统严格校验请求来源。若返回空白页或持续跳转登录框,请确保
add_header中的Referer地址与实际承载登录表单的页面URL完全一致。 - 跨域能力边界:PyQuery本质是纯Python端的HTML/XML解析器,并非独立的网络代理工具。其内部仍依赖Urllib发起底层请求,因此不具备突破浏览器同源策略的能力,仅适用于服务端后台或同运行环境的批量数据采集。
以上就是Python使用urllib2模拟登录并结合PyQuery解析网页数据的详细内容,更多关于传统网页爬虫实战与自动化数据提取的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









