

淘宝秒杀Python脚本:扫码登录与自动抢购实现
本文介绍如何使用Python和Selenium编写淘宝秒杀脚本。脚本支持扫码登录,自动监控抢购时间并点击结算。代码仅供学习参考,实际使用需注意平台规则与风险。
2026-10-12
6

本文介绍如何使用Python和Selenium编写淘宝秒杀脚本。脚本支持扫码登录,自动监控抢购时间并点击结算。代码仅供学习参考,实际使用需注意平台规则与风险。
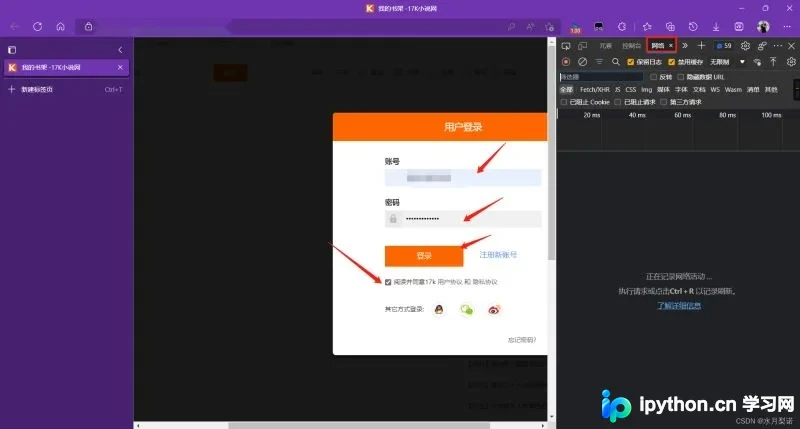
本文系统讲解使用Python绕过网页权限验证的三种实战方案。分别演示如何从抓包结果中提取有效Cookie直接发起请求、利用requests会话对象自动处理Form表单提交,以及基于Selenium驱动真实浏览器完成动态元素交互。附带完整可运行代码、参数定位步骤及版本兼容性注意事项。
本文详解Python爬虫处理动态网页的两种核心场景:利用Selenium模拟鼠标悬停以触发隐藏菜单,以及通过window_handles切换新弹出窗口。文章提供了完整的ActionChains操作代码与窗口句柄遍历逻辑,并针对窗口大小影响页面布局的问题给出最大化窗口的解决方案,帮助开发者稳定抓取动态内容。
本文详解使用Python结合Pillow、Scikit-learn和Selenium库,构建数字验证码识别与自动登录系统的完整流程。涵盖环境配置、图像灰度与二值化预处理、支持向量机分类器训练与参数持久化、预测函数封装,以及自动化抓取验证图、填写表单与实际异常处理方案,提供可直接集成的代码结构。
本文介绍使用 Selenium 控制浏览器的核心操作,包括自定义窗口尺寸、全屏显示、页面前进与后退以及刷新当前页。通过 Python 代码示例,展示如何调用 set_window_size、maximize_window、back、forward 和 refresh 等方法,帮助开发者实现浏览器自动化控制。
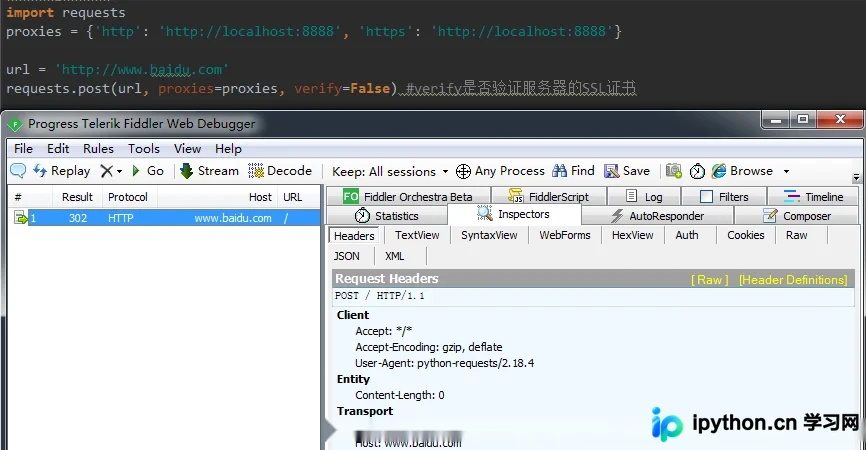
本文详细介绍在Python中使用requests库配置代理的方法,重点解决Python 3.8+版本中常见的ProxySchemeUnknown报错。通过示例展示如何正确拼接代理格式,并补充Selenium浏览器自动化的代理配置方案,帮助开发者顺利实现网络请求的代理转发。
本文介绍如何使用 Python Selenium 库操作网页中的单选框(Radio)。通过具体示例,演示如何遍历并点击所有单选框,以及如何精准定位并点击特定的单选框元素。
本文详细介绍如何在 Selenium Python 中配置爬虫代理 IP。通过 ChromeOptions 添加 --proxy-server 参数,可解决反爬限制并提升抓取效率。文章涵盖代理类型选择、多线程注意事项及代码实现,帮助开发者高效部署爬虫。
本文解决PyCharm新建工程时,因默认使用自带虚拟环境导致无法调用本机已安装的Selenium库的问题。通过修改Project Interpreter指向正确的Python解释器,即可在脚本中正常导入并使用Selenium。
本文详解在 Python Selenium 中如何管理浏览器标签页与窗口。涵盖使用 ActionChains 模拟快捷键(Ctrl+T/W)进行标签页的新建与关闭,以及通过 window_handles 获取并切换窗口句柄的方法。同时区分 driver.quit() 与 driver.close() 的区别,并提供完整的代码示例与操作逻辑。
使用 Python Selenium 访问自签名或过期证书的 HTTPS 站点时,常会触发握手失败报错。本文通过配置启动参数与浏览器选项,提供一键忽略 SSL 验证、屏蔽调试日志及移除控制横幅的完整方案,并附带兼容新版本的防检测优化步骤。
针对网页抓取与数据分析需求,本文详解Python解析HTML的核心方案。通过对比正则表达式、BeautifulSoup与lxml三种引擎,逐步演示字符编码处理、节点遍历定位、动态页面渲染及表格数据转换等关键操作,提供可直接运行的代码示例与异常排查指引。