Python3 实现极验(Geetest)滑块验证码自动破解与模拟
本文详细介绍使用Python3结合Selenium库破解极验(Geetest)滑块验证码的技术方案。内容涵盖通过API获取缺口图与背景图,利用PIL库进行图像拼接还原,计算滑动轨迹,并通过ActionChains模拟真实人类滑动行为完成验证。代码包含完整的浏览器模拟、图像处理及自动化交互逻辑,适用于Python爬虫开发与自动化测试场景。
2026-10-13
6

本文详细介绍使用Python3结合Selenium库破解极验(Geetest)滑块验证码的技术方案。内容涵盖通过API获取缺口图与背景图,利用PIL库进行图像拼接还原,计算滑动轨迹,并通过ActionChains模拟真实人类滑动行为完成验证。代码包含完整的浏览器模拟、图像处理及自动化交互逻辑,适用于Python爬虫开发与自动化测试场景。
本文详细介绍如何利用Python和Selenium库实现淘宝网站的自动化模拟登录。内容涵盖Selenium的核心优势、Windows环境下的安装方法(包括pip和源码包两种途径),并提供完整的模拟登录代码示例。通过该实例,读者可以掌握Web自动化测试的基础技巧及处理动态页面的方法。
本文详解Selenium Python中多窗口处理的完整流程。通过获取当前窗口句柄、打开新窗口、遍历所有句柄并切换至目标窗口,实现跨窗口元素操作。代码示例展示了如何安全切换窗口并返回原窗口,适用于自动化测试中的复杂页面交互场景。
本文详解Python Selenium自动化测试中的截图功能,重点介绍save_screenshot方法的使用。通过完整代码示例展示如何按日期和时间自动命名保存截图,解决长页面截图难题,并演示结合断言判断测试结果的实用技巧,帮助测试人员高效定位错误并记录测试步骤。
本文分享一段基于Python和Selenium库实现的淘宝秒杀脚本示例。代码通过模拟浏览器操作完成登录及下单流程,重点解析了time.sleep()在防止元素加载失败及触发滑块验证中的作用。作者通过实测验证了脚本可行性,并提供了处理中文账号编码等关键细节,供Python初学者参考学习。
本文介绍使用Python结合Selenium和Tesseract实现网站自动登录的方法。通过定位验证码URL并截取图片,利用PIL进行预处理后调用Tesseract识别字符。文中提供了完整的代码示例及处理像素点背景验证码的具体步骤,适用于需要绕过简单图形验证码的自动化测试场景。
本文提供基于Python和Selenium库的淘宝登录及数据爬取代码示例。通过模拟浏览器操作实现账号登录,并演示如何抓取特定网页内容。文中指出该方法可能触发平台风控,建议根据实际需求调整策略,并提到不登录模式在某些场景下可能更为有效。
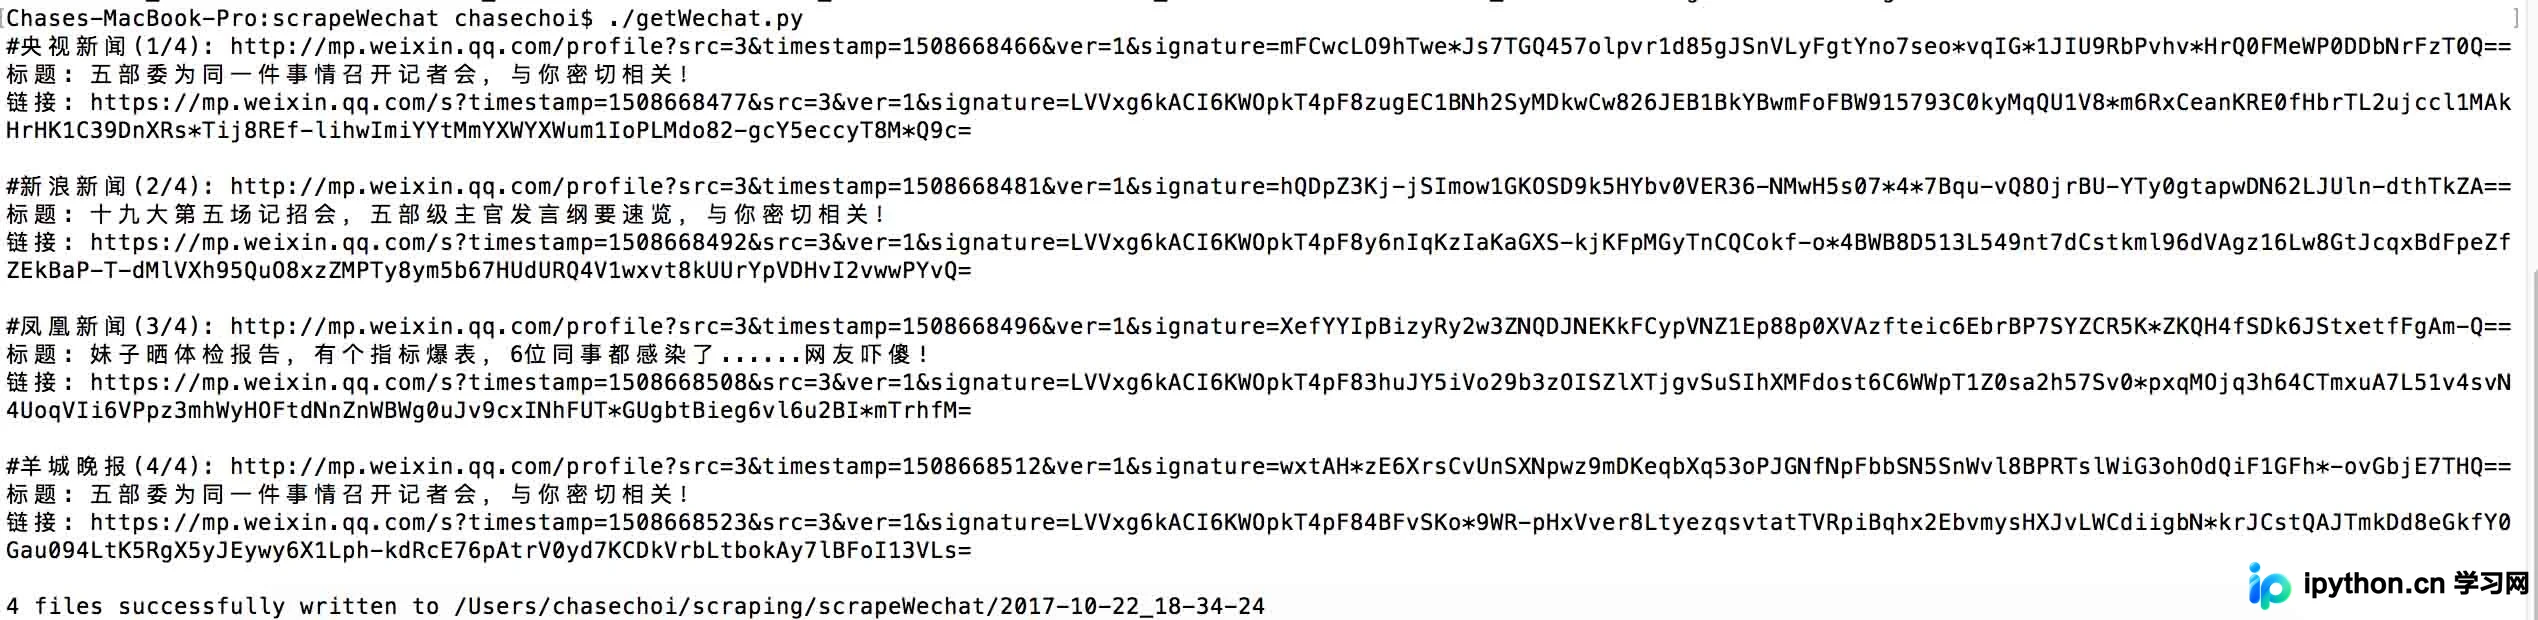
本文介绍如何使用Python抓取指定微信公众号的最新推送文章。针对搜狗微信搜索链接的时效性及动态网页渲染问题,结合Requests与Selenium+PhantomJS技术获取HTML内容,并通过BeautifulSoup提取链接。代码包含处理验证码提示、跨平台文件路径构造及带时间戳的文件保存逻辑,旨在提供一套完整的抓取示例供参考。
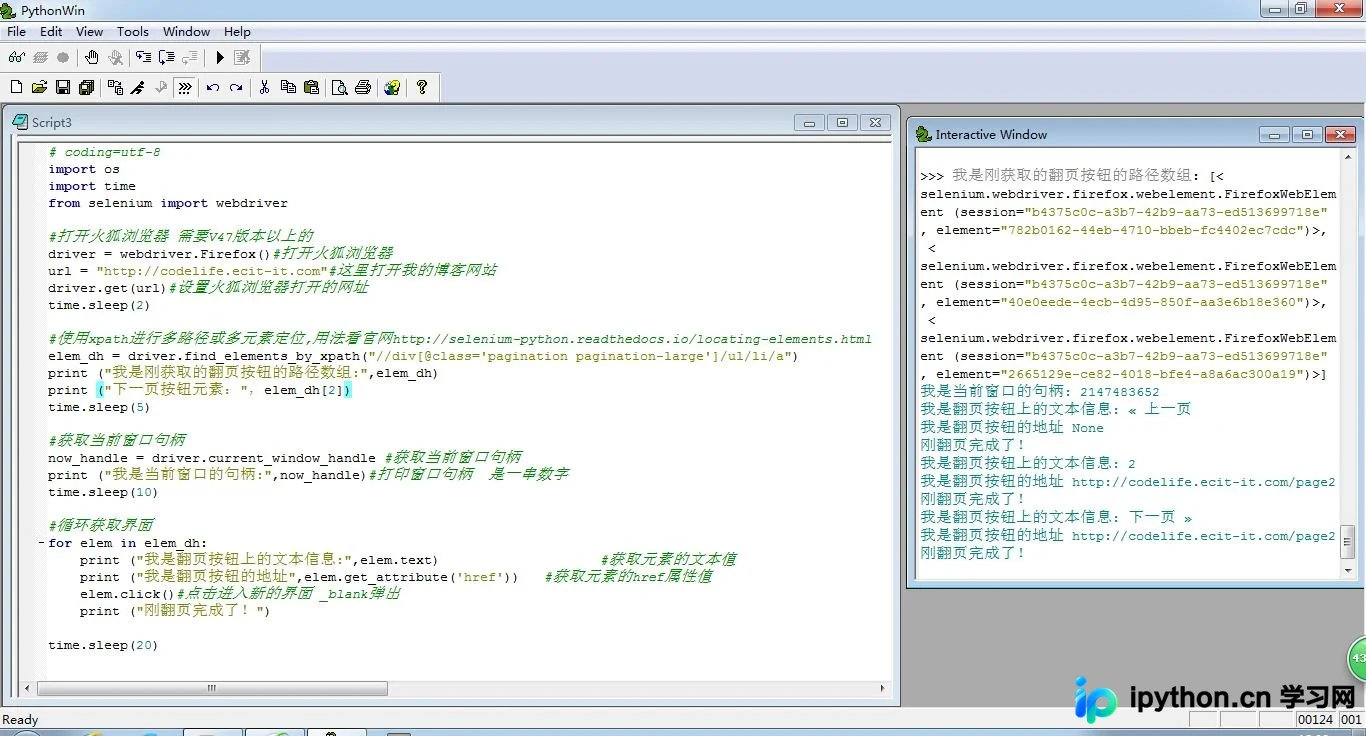
本文介绍如何使用Python结合Selenium库实现博客网站的自动翻页功能。通过Firefox浏览器驱动,利用XPath定位分页元素,遍历并点击“下一页”按钮实现内容加载。文中提供了完整代码、运行输出及环境配置建议,适用于Python 3.6.2及pywin32 3.6版本,帮助开发者掌握网页自动化基础操作。
本文详解如何使用Python3结合Selenium库解决urllib无法抓取JavaScript动态生成内容的问题。通过实例演示Firefox浏览器自动化操作,包括页面加载、元素查找及模拟按键,帮助开发者高效获取动态网页数据。
本文深入分析Python中获取当前页面所有链接的四种主流方法,涵盖正则表达式、BeautifulSoup、lxml及Selenium。重点指出iframe内容无法通过常规DOM解析获取的问题,并提供针对iframe的额外抓取策略,帮助开发者全面掌握网页数据提取技巧。
本文通过Python Selenium实现表单自动提交的完整示例,详细演示如何启动Firefox、定位页面元素、填充数据,并重点讲解iframe切换至子页面及跳出至父页面的方法。同时涵盖对window.alert、confirm和prompt等浏览器交互弹窗的处理技巧,包括accept、dismiss及send_keys的使用,适合初学者学习Selenium高级用法。