Python Selenium GUI自动化:获取Cookie并绕过验证码登录
本文介绍如何利用Python和Selenium进行GUI自动化,通过获取登录后的Cookie实现绕过验证码登录。文章详细展示了获取Cookie的代码逻辑,以及如何将Cookie注入浏览器以跳过登录验证步骤,为自动化测试和批量操作提供参考。
2026-10-12
6

本文介绍如何利用Python和Selenium进行GUI自动化,通过获取登录后的Cookie实现绕过验证码登录。文章详细展示了获取Cookie的代码逻辑,以及如何将Cookie注入浏览器以跳过登录验证步骤,为自动化测试和批量操作提供参考。
本文介绍如何使用Python和Selenium编写淘宝秒杀脚本。脚本支持扫码登录,自动监控抢购时间并点击结算。代码仅供学习参考,实际使用需注意平台规则与风险。
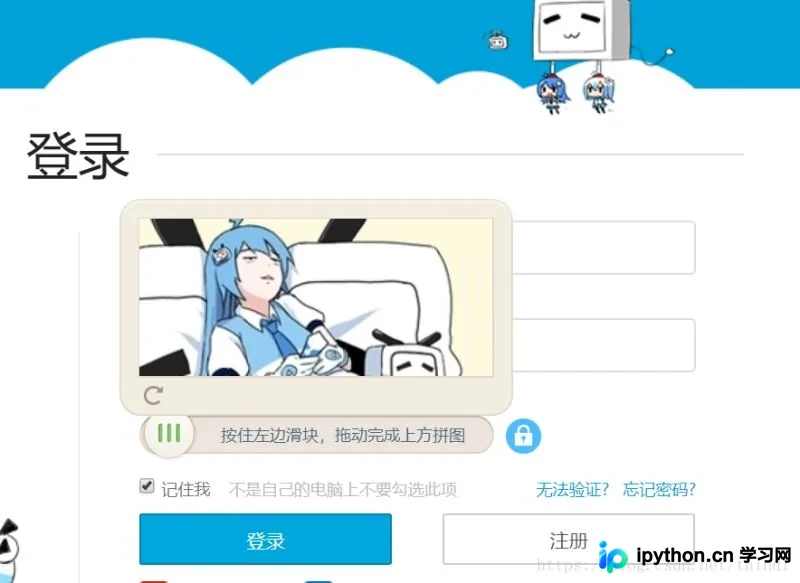
本文详细介绍使用Python结合Selenium和PIL库破解Bilibili滑动验证码的实现过程。通过获取完整与缺口验证码图片,利用图像分割与像素比对计算滑块位移,并模拟人类运动轨迹完成拖动。文中提供了从环境配置到代码实现的全流程解析,帮助开发者掌握自动化登录技术。
本文介绍如何使用 Python Selenium 库操作网页中的单选框(Radio)。通过具体示例,演示如何遍历并点击所有单选框,以及如何精准定位并点击特定的单选框元素。
本文详细介绍如何在 Selenium Python 中配置爬虫代理 IP。通过 ChromeOptions 添加 --proxy-server 参数,可解决反爬限制并提升抓取效率。文章涵盖代理类型选择、多线程注意事项及代码实现,帮助开发者高效部署爬虫。
本文介绍如何使用Python Selenium库实现网页的定时刷新与批量操作。通过配置Firefox或Chrome浏览器驱动,结合time和random模块控制刷新频率,实现自动化刷新指定URL。文章包含完整代码示例,涵盖页面刷新方法、异常处理及浏览器生命周期管理,适用于熟悉Selenium基础函数的开发者,为后续自动化任务如短信轰炸等场景提供技术铺垫。
本文解决PyCharm新建工程时,因默认使用自带虚拟环境导致无法调用本机已安装的Selenium库的问题。通过修改Project Interpreter指向正确的Python解释器,即可在脚本中正常导入并使用Selenium。
本文介绍使用Selenium结合Python实现网页自动登录的方法,以微博为例演示完整流程。重点解析Python 2.7与Selenium 3.0.2及Firefox特定版本的兼容性问题,提供geckodriver与浏览器版本的匹配建议。通过XPath定位元素、输入账号密码并提交,并获取Cookie。文中包含完整代码示例及常见报错排查指南,适合初学者参考。
本文详细解析了利用Python Selenium WebDriver自动化操作浏览器登录微信公众号后台,并抓取文章内容的完整流程。通过模拟输入账号密码、获取Cookie并持久化存储,结合Requests库调用后台接口实现文章数据的批量下载与本地保存,为公众号数据抓取提供了可参考的代码实现。
本文详解在 Python Selenium 中如何管理浏览器标签页与窗口。涵盖使用 ActionChains 模拟快捷键(Ctrl+T/W)进行标签页的新建与关闭,以及通过 window_handles 获取并切换窗口句柄的方法。同时区分 driver.quit() 与 driver.close() 的区别,并提供完整的代码示例与操作逻辑。
本文详解Python爬虫处理动态网页的两种核心场景:利用Selenium模拟鼠标悬停以触发隐藏菜单,以及通过window_handles切换新弹出窗口。文章提供了完整的ActionChains操作代码与窗口句柄遍历逻辑,并针对窗口大小影响页面布局的问题给出最大化窗口的解决方案,帮助开发者稳定抓取动态内容。
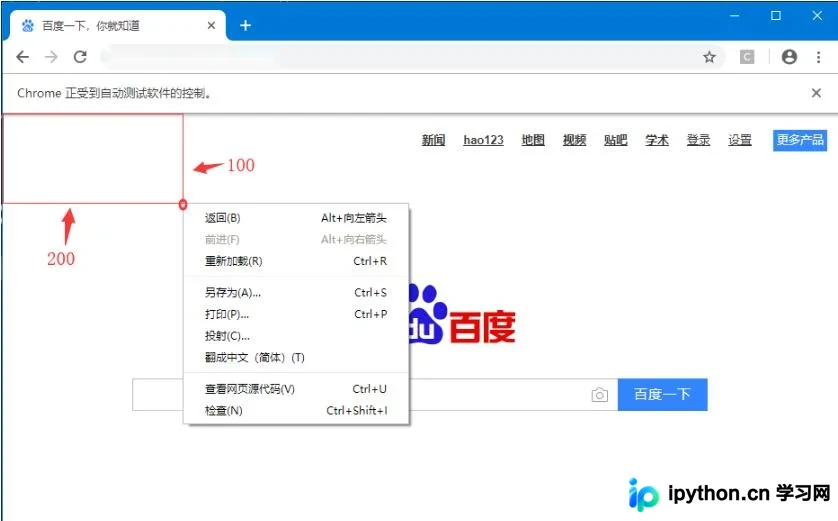
本文介绍如何使用 Python Selenium 的 ActionChains 库通过坐标点击网页元素。重点解析 move_by_offset 导致的坐标累积问题,并提供封装函数恢复鼠标位置的解决方案,适用于元素定位困难但位置固定的场景。