Python抓取微信公众号最新推送:Selenium与Requests实战
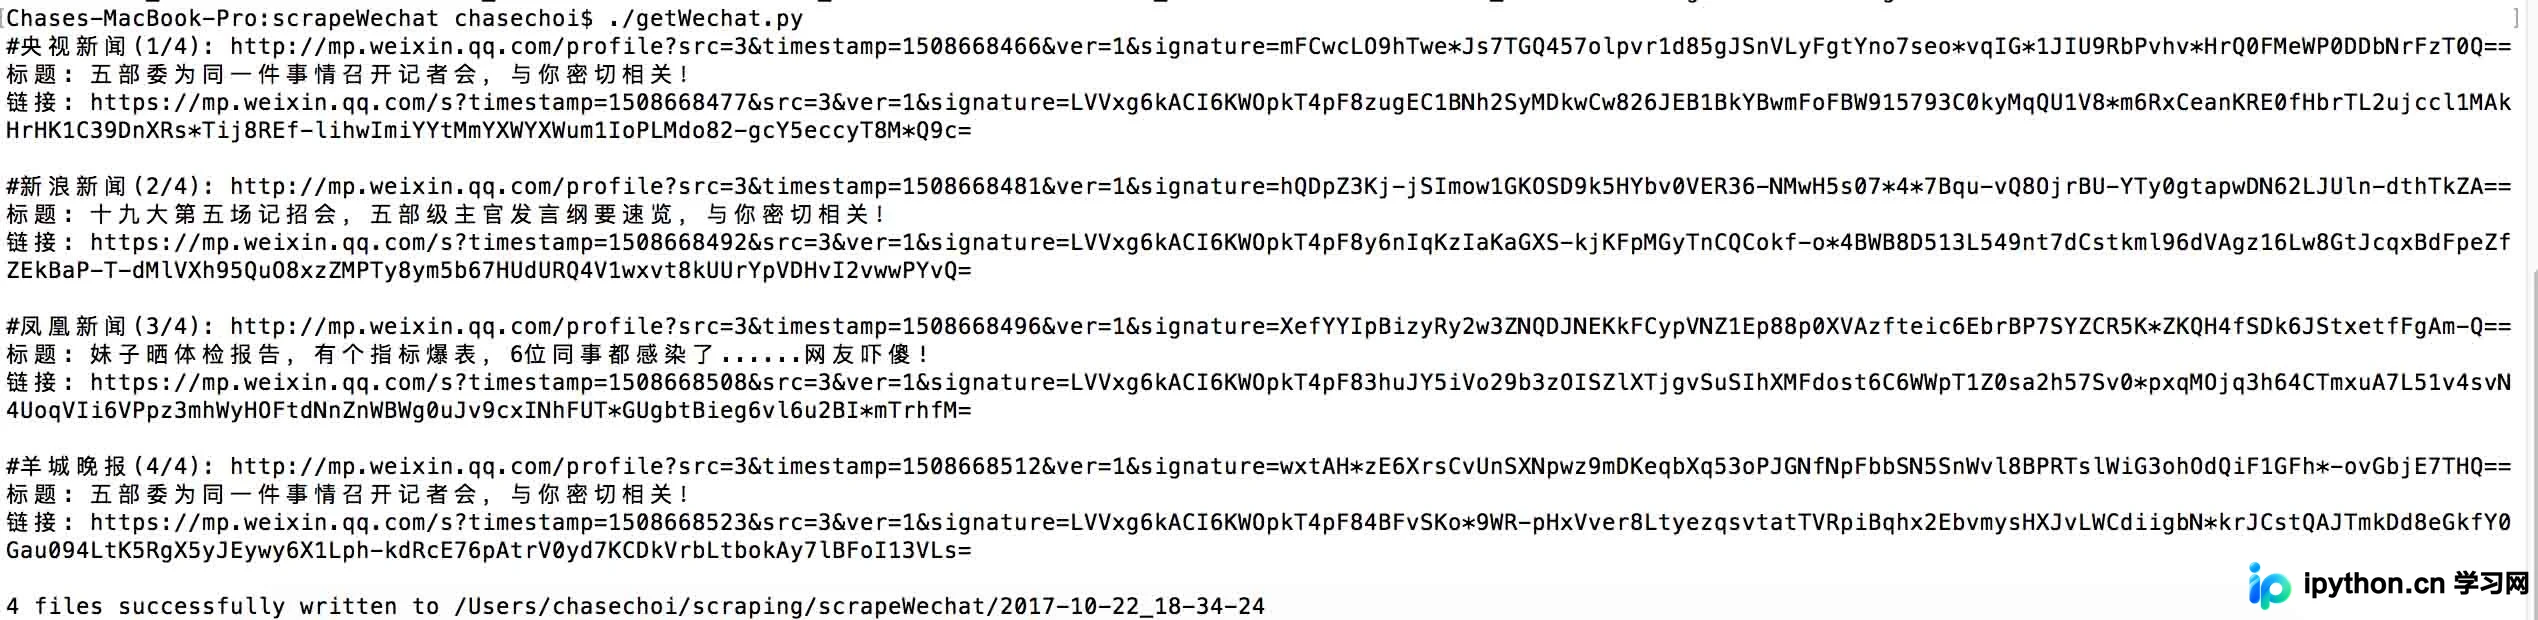
本文介绍如何使用Python抓取指定微信公众号的最新推送文章。针对搜狗微信搜索链接的时效性及动态网页渲染问题,结合Requests与Selenium+PhantomJS技术获取HTML内容,并通过BeautifulSoup提取链接。代码包含处理验证码提示、跨平台文件路径构造及带时间戳的文件保存逻辑,旨在提供一套完整的抓取示例供参考。
2026-10-13
6

本文介绍如何使用Python抓取指定微信公众号的最新推送文章。针对搜狗微信搜索链接的时效性及动态网页渲染问题,结合Requests与Selenium+PhantomJS技术获取HTML内容,并通过BeautifulSoup提取链接。代码包含处理验证码提示、跨平台文件路径构造及带时间戳的文件保存逻辑,旨在提供一套完整的抓取示例供参考。
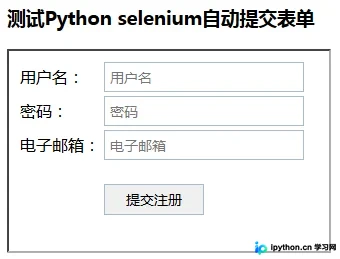
本文通过Python Selenium实现表单自动提交的完整示例,详细演示如何启动Firefox、定位页面元素、填充数据,并重点讲解iframe切换至子页面及跳出至父页面的方法。同时涵盖对window.alert、confirm和prompt等浏览器交互弹窗的处理技巧,包括accept、dismiss及send_keys的使用,适合初学者学习Selenium高级用法。
本文详解如何利用Python多线程技术结合Selenium实现跨浏览器自动化测试。通过解析跨浏览器测试的必要性及常见兼容性问题,演示了如何在同一台机器上并行启动IE、Firefox和Chrome执行百度搜索用例,旨在提升Web应用兼容性测试效率。
本文介绍如何利用Python和Selenium库自动化处理网页分页功能。通过解析DOM元素,可获取分页总数、当前页码及翻页状态,并演示如何定位并点击指定页码链接实现页面跳转,适用于Web自动化测试与数据采集场景。
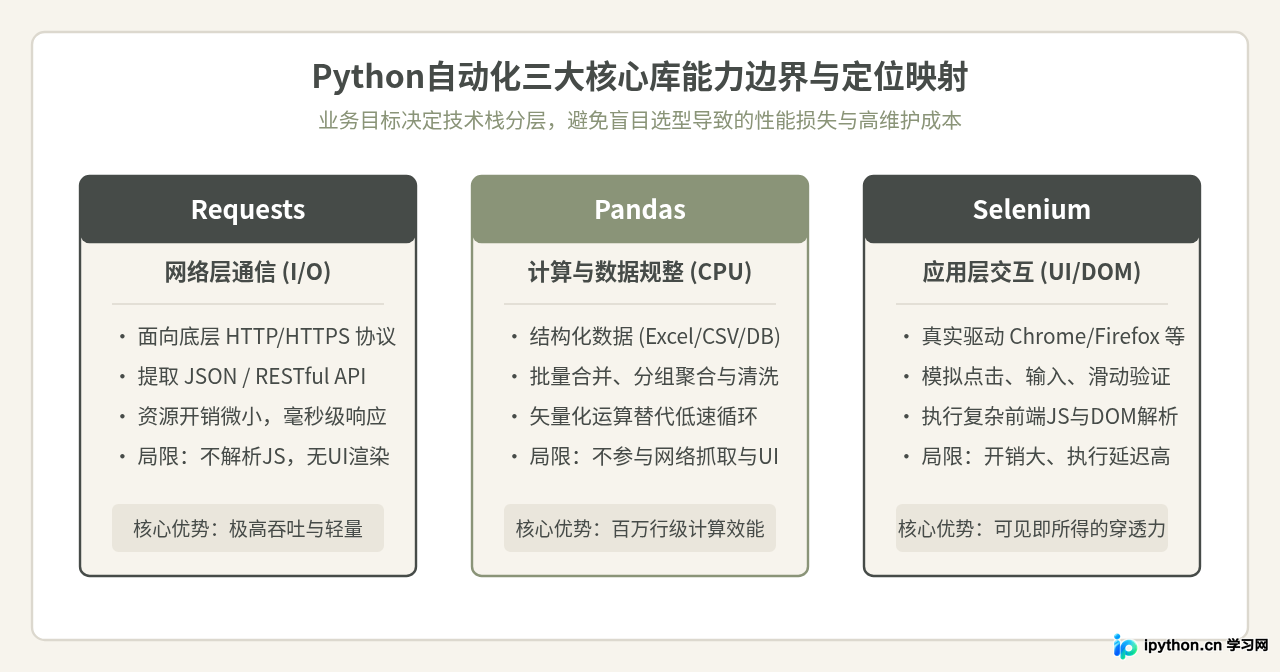
学习Python自动化时,面对Selenium、Pandas和Requests常令人难以抉择。本文从实际业务目标出发,详细拆解三者的核心能力边界、适用场景、性能差异与协同逻辑,提供清晰明确的技术选型决策指南。
针对网页抓取与数据分析需求,本文详解Python解析HTML的核心方案。通过对比正则表达式、BeautifulSoup与lxml三种引擎,逐步演示字符编码处理、节点遍历定位、动态页面渲染及表格数据转换等关键操作,提供可直接运行的代码示例与异常排查指引。
使用 Python Selenium 访问自签名或过期证书的 HTTPS 站点时,常会触发握手失败报错。本文通过配置启动参数与浏览器选项,提供一键忽略 SSL 验证、屏蔽调试日志及移除控制横幅的完整方案,并附带兼容新版本的防检测优化步骤。
本文详解如何在Python Selenium中利用execute_script方法绕过网站JS行为监控。通过注入JavaScript代码,实现模拟鼠标直接点击、拦截弹窗、创建派发事件、悬停后点击、滚动至元素及等待可点击状态等多种复杂交互场景,帮助开发者解决元素遮挡、未加载或反爬限制问题。
本文详解使用Python结合Pillow、Scikit-learn和Selenium库,构建数字验证码识别与自动登录系统的完整流程。涵盖环境配置、图像灰度与二值化预处理、支持向量机分类器训练与参数持久化、预测函数封装,以及自动化抓取验证图、填写表单与实际异常处理方案,提供可直接集成的代码结构。
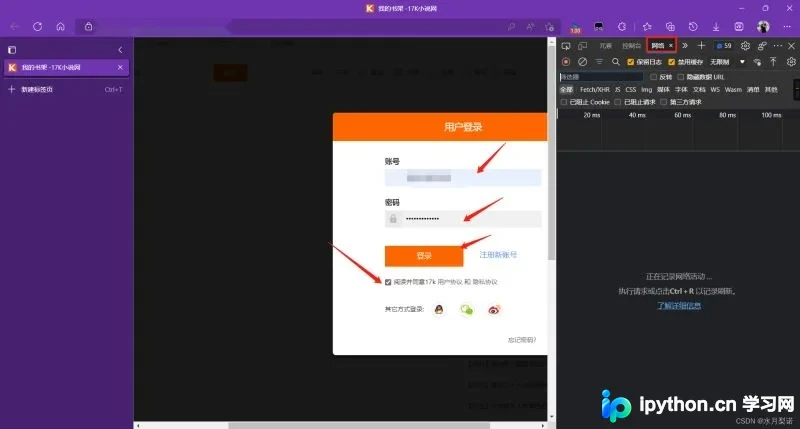
本文系统讲解使用Python绕过网页权限验证的三种实战方案。分别演示如何从抓包结果中提取有效Cookie直接发起请求、利用requests会话对象自动处理Form表单提交,以及基于Selenium驱动真实浏览器完成动态元素交互。附带完整可运行代码、参数定位步骤及版本兼容性注意事项。
针对Web自动化测试中频繁弹出的图文验证码难题,常规策略包括关闭验证、预留万能码、Cookie注入或直接调用第三方打码平台。若需本地自主识别,可借助Python的Selenium获取页面坐标,配合PIL库进行像素级色彩过滤,最后接入Tesseract OCR引擎还原字符内容。该方法无需联网付费,稳定可靠,适合私有化测试环境的高效拦截与复用要求。
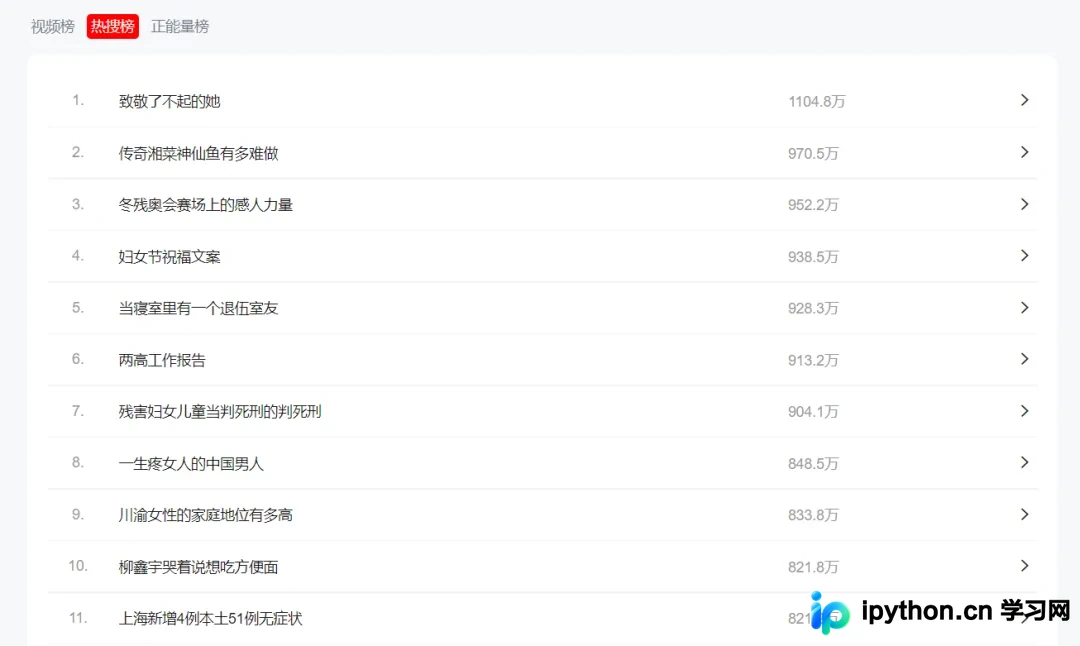
本文详细介绍如何使用Python爬取抖音热搜榜数据。通过对比requests和selenium两种方法,演示如何获取排名、热度、标题及链接,并利用lxml解析数据保存至Excel。最后结合Windows任务计划程序实现每小时自动运行,打造高效的热榜监控工具。