

Python爬虫进阶:requests库实战与高级用法
本文深入讲解Python爬虫中requests库的高级应用。通过GET与POST请求实例,演示如何构造Headers与Params;结合拉钩网案例解析数据抓取逻辑;详细介绍代理IP配置方法以规避封禁;最后通过人人网登录示例,阐述利用Session对象保持会话状态及Cookie管理的完整流程。
2026-10-13
8

本文深入讲解Python爬虫中requests库的高级应用。通过GET与POST请求实例,演示如何构造Headers与Params;结合拉钩网案例解析数据抓取逻辑;详细介绍代理IP配置方法以规避封禁;最后通过人人网登录示例,阐述利用Session对象保持会话状态及Cookie管理的完整流程。
本文介绍了如何使用Python通过requests库调用钉钉开放平台接口,发送Text格式的消息。文中提供了完整的代码示例,包括设置访问令牌、构造JSON数据以及发送POST请求的关键步骤,帮助开发者快速实现自动化消息通知功能。
本文介绍如何使用Python调用有道翻译API接口。首先需通过pip安装requests库,随后申请API密钥。文中提供了完整的Python代码示例,涵盖请求发送、JSON解析及错误处理逻辑,旨在帮助初学者快速实现简单的翻译功能。
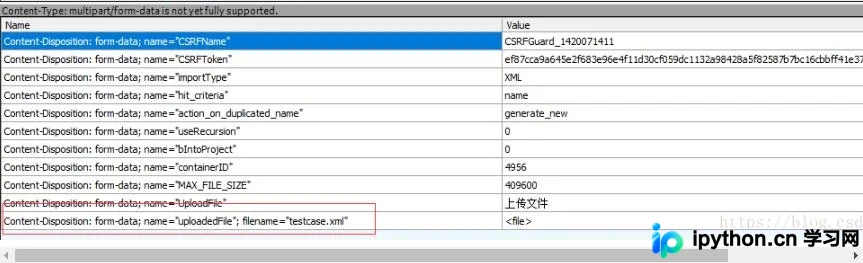
本文详解如何使用Python Requests库调用包含文件参数的接口。针对Fiddler抓包显示的Form-Data结构,说明不能仅用data传参,需将文件参数通过files字典传递。通过对比抓包结果验证请求一致性,确保文件上传逻辑正确。
本文介绍在Python中使用Requests库获取网站Cookie时遇到的常见陷阱。通过调试发现,某些情况下服务器返回的Cookie可能存在于r.request.headers而非r.headers中。文章分析了请求头中Host和Referer字段对Cookie返回的影响,并推荐通过会话对象自动管理Cookie的最佳实践,帮助开发者解决模拟登录中的Cookie获取问题。
本文介绍如何使用Python的requests库高效提交HTTP表单数据。通过实例演示了无Cookie、显式添加Cookie及Session隐式维持Cookie三种场景下的POST请求实现。同时提供利用tcpdump进行网络抓包以辅助脚本调试的实用技巧,帮助开发者快速定位网络交互问题。
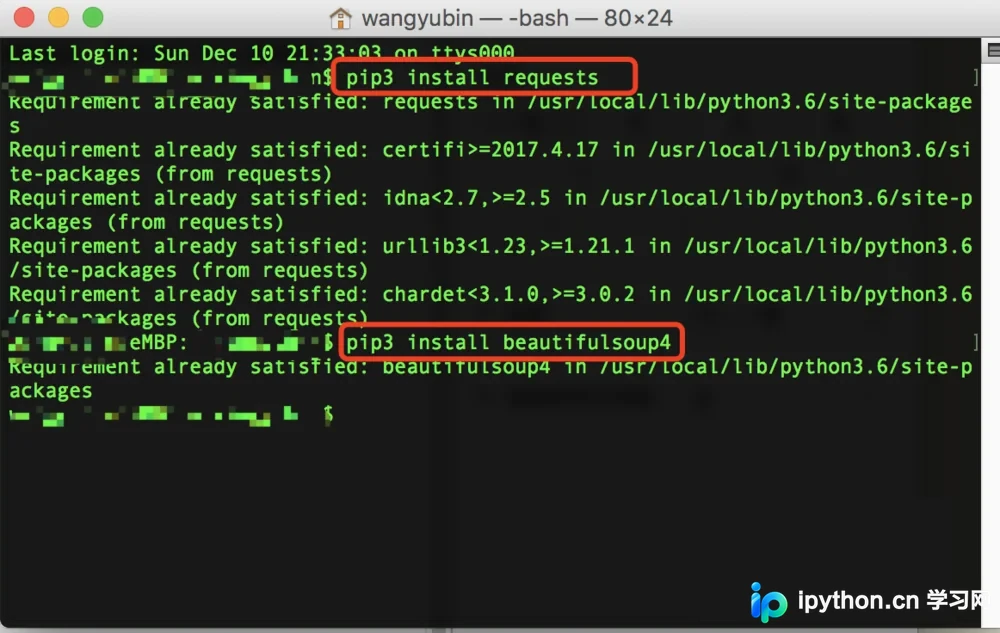
本文详细介绍如何使用Python编写爬虫程序抓取新浪新闻。通过安装requests和bs4库,模拟浏览器请求获取原始数据,并解决常见的乱码问题。接着利用浏览器开发者工具定位HTML标签,结合BeautifulSoup解析提取新闻标题、发布时间及链接,最终实现结构化数据的自动采集。
本文详细介绍利用Python爬虫下载网页中图片、文档等资源的三种方法。通过解析网页源码获取资源URL,分别演示了使用urllib.urlretrieve直接下载、requests库同步全量下载以及开启stream参数进行分块写入的实现代码。重点解析了分块下载在处理大文件时节省内存的优势,并提供了批量下载多个资源的通用逻辑思路。
本文介绍如何利用Python的requests库判断计算机是否拥有网络连接。通过安装requests第三方库,编写简单函数尝试访问百度并设置超时时间,若成功则返回真,否则捕获异常返回假。该实例代码简洁,适合初学者参考学习网络状态检测的基本方法。
本文介绍了如何使用Python的requests库通过POST方法访问RESTful服务接口。主要步骤包括构建包含数据的字典,利用json模块将其序列化为JSON字符串,设置请求头Content-type为application/json,最后发送POST请求并打印响应结果。该方法适用于需要提交JSON格式数据的API交互场景。
本文提供一段Python代码,演示如何抓取网易云音乐歌曲的热评。通过构造请求头与参数,利用requests库获取数据,并解析JSON提取用户昵称及评论内容,最终保存至本地文本文件。
本文介绍如何利用Python的requests、lxml及xlsxwriter库,通过构造高德地图API接口批量抓取水果店等POI数据。教程涵盖环境配置、请求参数构造、分页循环逻辑及Excel表格写入实现,帮助开发者快速掌握地图数据抓取与本地存储技巧。