

Python爬虫实战:利用requests库高效抓取数据
本文介绍如何使用Python的requests库进行数据抓取。通过对比Java等语言,突出Python在集成工具库方面的便捷性。详细讲解了设置请求参数、Headers、代理以及处理不同响应格式(文本、JSON、二进制)的具体代码示例,帮助开发者快速上手网络爬虫开发。
2026-10-13
6

本文介绍如何使用Python的requests库进行数据抓取。通过对比Java等语言,突出Python在集成工具库方面的便捷性。详细讲解了设置请求参数、Headers、代理以及处理不同响应格式(文本、JSON、二进制)的具体代码示例,帮助开发者快速上手网络爬虫开发。
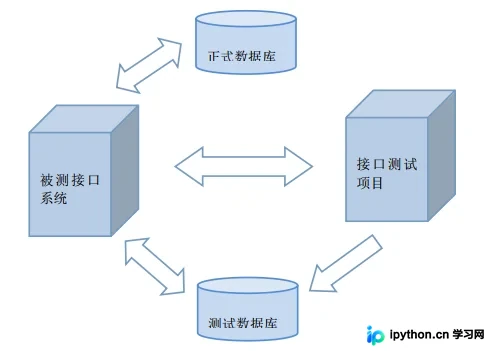
本文详解如何使用Python的Requests库与Unittest框架搭建接口自动化测试系统。针对传统工具在数据控制、加密接口及扩展性上的不足,提出通过独立测试数据库保证数据可控性的设计方案。结合Django后端示例,展示从环境配置、数据库封装到测试用例编写及HTML报告生成的完整流程,实现高效、可扩展的接口自动化测试。
本文详细介绍如何利用Python的Requests库获取网页源码,并结合BeautifulSoup解析HTML结构以提取表格数据。通过定义检查链接、获取内容及保存文件三个核心函数,实现将网页中的表格信息清洗后写入本地CSV文件的完整流程,适合初学者参考学习。
本文详细介绍在Python爬虫开发中应对反爬机制的代理IP设置方法。通过安装requests、bs4和lxml库,构建从免费代理网站抓取IP并随机选取的完整流程。代码演示如何利用random模块生成符合requests格式的代理字典,有效规避真实IP被封风险,提升爬虫稳定性。
本文介绍使用Python进行淘宝商品价格定向爬取的完整流程。通过requests库获取HTML源码,利用正则表达式提取价格和商品标题,并格式化输出结果。代码包含异常处理机制,适合初学者学习网络爬虫基础与数据解析技巧。
本文提供一段Python实现12306登录功能的示例代码。通过requests库发起会话,获取验证码图片并保存,用户手动输入坐标后提交登录请求。代码包含必要的库导入、会话管理及简单的验证码坐标映射逻辑,供参考学习。
本文详解Python爬虫中GET与POST请求的区别及适用场景,重点解析Cookie在维持会话状态中的作用。通过163邮箱实例,演示如何利用Requests库发送请求,并解决SSL证书过期导致的SSLError问题,提供verify=False的解决方案及完整代码示例。
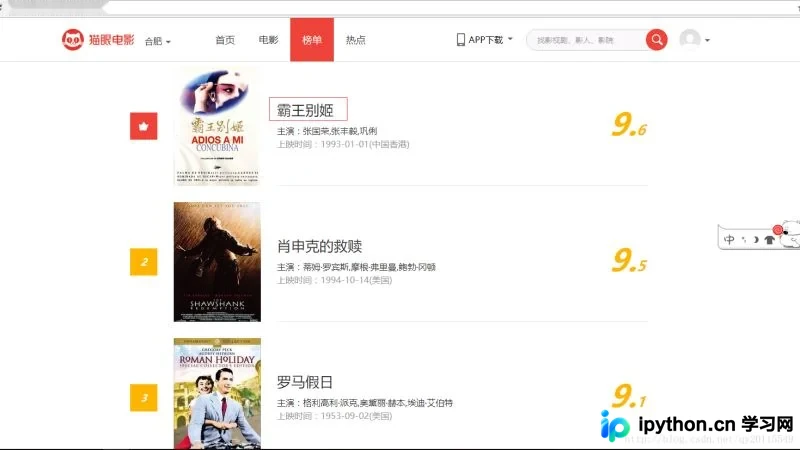
本文详细介绍如何使用Python的requests模块发起HTTP请求获取HTML源码,并结合BeautifulSoup库解析网页结构。通过抓取猫眼电影Top100榜单的具体案例,演示安装依赖、构造请求及提取电影标题与链接的完整流程,提供可直接运行的代码示例。
本文详解Python中requests库Session对象的两个核心妙用:一是跨请求自动保持Cookie等会话状态,简化接口测试流程;二是通过设置Session属性提供请求默认值(如Auth和Headers)。重点解析方法层参数如何覆盖Session层参数,以及如何通过显式设置None来省略默认属性,帮助开发者更高效地管理HTTP会话。
本文介绍如何在Python的requests库中通过proxies参数配置HTTP和HTTPS代理。通过示例代码展示具体用法,并提供使用chinaz.com网站验证代理是否生效的方法。同时附带解决乱码和添加cookies的参考链接,帮助开发者顺利处理网络请求中的代理配置问题。
本文深入探讨Python中HTTP长连接客户端的实现,针对高并发场景下短连接导致的Time-Wait状态堆积和端口耗尽问题,提供了从单进程到多进程,再到长连接优化的完整解决方案。通过对比短连接与长连接代码,展示了如何利用Requests库的Session对象维持连接,显著提升系统稳定性和处理效率。
本文介绍一个基于Python的简单图片爬虫程序,旨在帮助用户批量保存知乎问题中的图片。程序通过Requests库模拟浏览器请求获取页面数据,利用BeautifulSoup解析HTML提取图片链接,并根据图片尺寸过滤头像和小图标。文中提供了使用PIL、OpenCV和skimage等多种方式处理图片的代码示例,适用于对网页图片抓取有基础需求的开发者。