

Python使用正则表达式按多个空格分割字符串
本文介绍在Python中利用正则表达式实现按多个空格分割字符串的方法。通过re.split函数配合特定模式,可有效处理包含连续空格的文本数据,并展示了从原始数据到处理结果的完整流程及代码示例。
2026-10-13
10

本文介绍在Python中利用正则表达式实现按多个空格分割字符串的方法。通过re.split函数配合特定模式,可有效处理包含连续空格的文本数据,并展示了从原始数据到处理结果的完整流程及代码示例。
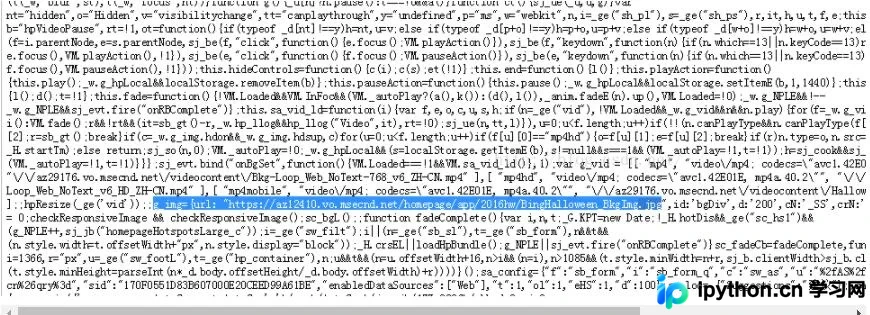
本文分析Python中使用正则表达式匹配网页图片URL时,因HTML源码包含换行符导致匹配失败的问题。通过对比单行与多行字符串匹配结果,指出默认模式下'.'不匹配换行符。解决方案为在re.compile中传入re.S标志,使点号匹配所有字符包括换行符,从而完美提取跨行显示的图片地址。
本文探讨Python网页采集中正则表达式匹配换行符的问题。默认情况下,正则中的点号(.)无法匹配换行符,导致数据采集失败。通过示例展示使用[\s\S]组合可匹配包括换行在内的任意字符,并简要介绍\s与\S的定义,帮助开发者解决HTML解析中的换行匹配难题。
本文介绍利用Python脚本从文本文件中筛选包含中文字符行的方法。通过结合文件读写操作与正则表达式匹配Unicode范围,实现高效的内容过滤。文中提供了完整代码示例,解析了with语句的资源管理优势及正则匹配原理,适用于多语言版本处理场景。
新版 Django 使用 path 替代 url,但 path 不支持直接编写正则表达式,导致路由匹配失败。本文介绍通过导入 re_path 模块来解决此问题,确保正则路由正常工作,并提供完整的代码示例供参考。
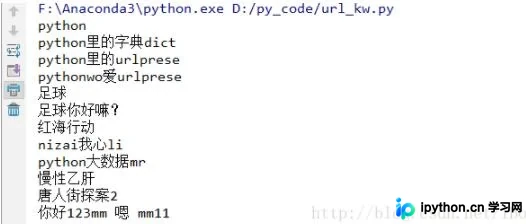
本文详细介绍如何利用Python解析URL并提取关键字。通过对比Python2与Python3的urlparse模块差异,结合正则表达式匹配query和path中的关键参数。文章提供了针对百度、搜狗等主流网站及特殊域名如weibo.com的字典映射规则,并附带完整代码与测试案例,帮助开发者高效处理各类URL解析需求。
整理 JavaScript 开发中常用的字符串验证功能,涵盖 IP 地址、手机号、邮箱、日期、金额及证券代码等场景。通过封装标准正则表达式与自定义逻辑函数,提供可直接复用的校验工具,解决前端表单输入合法性检查需求,提升数据准确性与用户体验。
本文深入探讨Python中按固定长度切分字符串的多种实现方式。针对无分隔符的字符串,对比了传统的for循环切片、列表推导式以及利用re模块findall函数的正则匹配方案。重点解析了正则表达式\w{1,4}在自动分组中的巧妙应用,帮助开发者根据场景选择最高效的代码实现。
本文介绍利用Python进行文件读写、正则表达式提取及集合去重的完整流程。通过示例代码展示如何遍历源文件,使用re模块匹配特定字段,并借助set数据结构实现高效去重,最终将唯一结果写入目标文件。
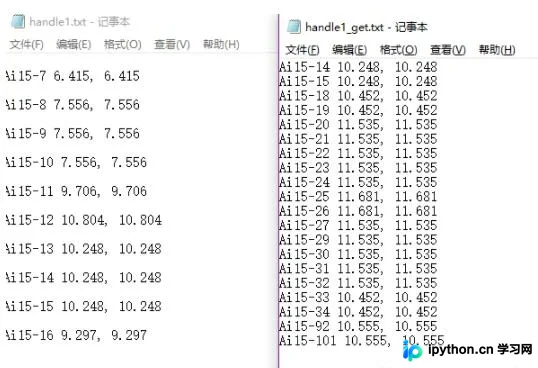
本文介绍使用Python3.5读取txt文件,通过正则表达式提取每行逗号后的数值,并过滤掉小于9.500或大于12.500的行,最终将保留的数据写入新文件的完整代码与步骤。
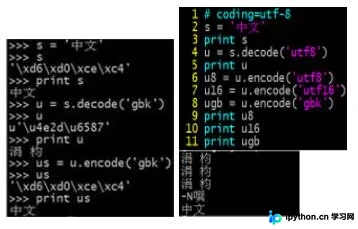
本文详细解析Python中处理含中文字符串时的编码问题,重点讲解str与unicode的转换机制及正则表达式匹配中文的规则。通过Python2.7环境下的实测案例,演示了如何正确设置文件编码、处理不同编码格式文件的读取显示,以及利用Unicode范围匹配中日韩文字与标点符号,为开发中解决中文乱码和匹配问题提供实用参考。
本文详细介绍Python标准库fnmatch模块,该模块提供Unix Shell风格的文件名匹配功能。涵盖filter、fnmatch、fnmatchcase及translate四个核心函数的用法,展示如何结合os.walk筛选文件,以及将Shell模式转换为正则表达式的技巧,适用于简单的字符串过滤场景。